TGViewer
Channel Public Channel
Daria’s room

Daria’s room

@dariasroom

Копаюсь в недрах Go, проектирую схемы, абстракции, а главное - учусь

Буду рада пообщаться! -> @darya_smyr

https://github.com/dariasmyr
Subscribers
1.2K
Photos
66
Videos
2
Links
69
Recent Posts 14 shown
Post #130 693
Автоматическое сжатие на клиенте vs ручное на сервере

Стандартный клиент http.Transport сам добавляет в запрос Accept-Encoding: gzip и, если сервер отвечает с Content-Encoding: gzip, клиент сам распакует ответ. Но только пока Accept-Encoding не выставлен вручную. Если клиент сам задаёт этот заголовок (случайно либо намеренно с указанием другого алгоритма типа `zstd`) логику распаковки тоже надо писать самому. Подробнее прямо описано в доке `net/http`

Интересно, что на сервере симметричной автоматики нет. http.Server сам ответы не сжимает - и это довольно логично: но стороне сервера eщё нужно решить, стоит ли вообще сжимать конкретный ответ. Все таки сжатие переносит часть стоимости с сети на cpu: сервер и клиент тратят проц на переупаковки в обмен на уменьшение объёма передаваемых по сети данных.

Поэтому для тех, кому экономия на сжатии превышает доп вычисления, будет полезно обернуть хендлер небольшим миддлваром, например через klauspost/compress


func responseCompressionMiddleware(next http.Handler) http.Handler {
return gzhttp.GzipHandler(next)
}


Нейминг может запутать, потому что gzhttp.GzipHandler умеет не только gzip, но и zstd: алгоритм выбирается по Accept-Encoding, а при одинаковом приоритете q выбирает zstd.

А если передаются секреты или другая sensitive инфа, у gzhttp можно добавить RandomJitter - оберточная функция, которая добавляет небольшой padding, размывая точный размер сжатого ответа, чтобы нарушитель не смог по небольшим изменениям размера косвенно угадывать части секрета

Также можно обернуть весь клиент http.Transport через gzhttp.Transport и автоматическая распаковка будет распространяться уже и на zstd - тогда как стандартный http.Transport автоматически работает только с gzip. Не знаю, насколько это общеизвестная деталь, но я даже про gzip под капотом узнала только сейчас :-)

#go #perf
  • ❤ 18
  • 👍 9
  • 🔥 5
  • 🏆 3
  • 🤩 1
Post #126 1.21K
Причина перекосов в уровне балансировки

L4-балансировщик выбирает серверную ноду при создании соединения. После этого net/http может долго переиспользовать то же соединение через keep-alive - и все следующие запросы продолжат идти на уже выбранную ноду без участия L4.

В некоторых сценариях такое переиспользование приводит к перекосу нагрузки. Проблема далеко не новая, но я хочу разобрать отдельные решения подробнее. В чем, собственно, проблема:

Для http 1.x свободные соединения внутри net/http пакета в http.Transport переиспользуются по LIFO: логично, что нам выгоднее взять последнее освободившееся. Это видно в реализации http.Transport.queueForIdleConn и в самой модели http.Transport:


type Transport struct {
///
idleConn map[connectMethodKey][]*persistConn // most recently used at end
///


В отдельных кейсах типо #79664, если одна из нод отвечает немного медленнее остальных, её соединение позже возвращается в idle pool и оказывается последним использованным. Следующий запрос снова забирает его, нода опять отвечает дольше - и так по кругу. В данном кейсе мы минуем L4 - ведь новых соединений нет и выбирать ему просто нечего.

Периодическая ротация соединений встряхнет L4 (рис 1)

В вышеописанном issue предлагают добавить новый параметр, которое ограничивает число запросов на одно соединение (MaxRequestsPerConn), чтобы они периодически закрывались и снова проходили через балансировщик. Например, можно периодически вытеснять активно переиспользуемые соединения через вероятностное включение Request.Close.

Подобную задачу давно решают на инфраструктурном уровне, например, в nginx есть upstream параметры keepalive_requests - которое ограничивает число запросов и keepalive_time типо время жизни соединения. Поэтому часть подобных проблем по 10+ лет не доезжает до http.Transport: их уже умеет решать инфра снаружи.

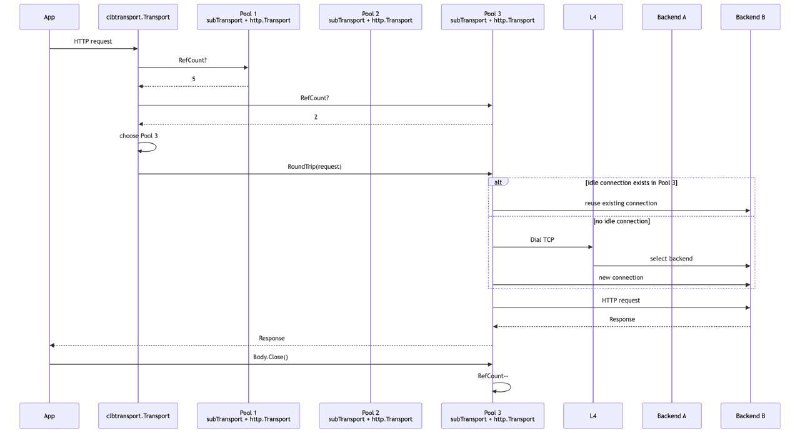
Балансировка на уровне пулов (рис 2,3)

Можно поступить грубее и держать несколько независимых http.Transport и распределяться между ними. Так устроен clbtransport: снаружи это обертка, которая внутри ротирует запрос между несколькими пулами. Перед каждым запросом сравнивается два кандидата: один по round-robin, второй рандомный. Запрос уходит в тот пул, где меньше незавершённых запросов на пул (это кстати называется Power of Two Choices).

К тому же пулы периодически пересоздаются в фоне с jitter, чтобы минимизировать одновременное закрытие и создание кучи соединений.

Но внутри каждого пула остаётся LIFO, а конкретную ноду по-прежнему выбирает L4 только при создании соединения.

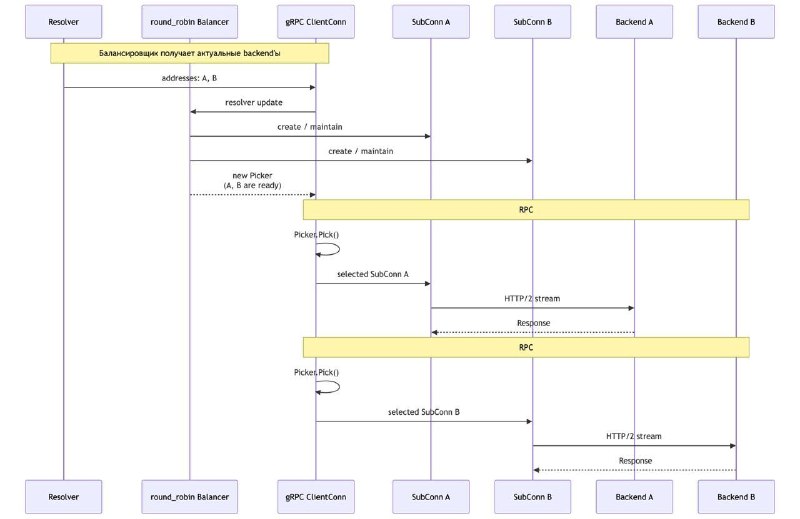
Кастомная балансировка на уровне отдельного RPC - на примере gRPC (рис 4)

В http2 привязка к соединению становится ещё важнее: через одно соединение одновременно может идти множество стримов.

Видимо поэтому в gRPC балансировку вынесли в клиент благодаря отдельным моделям: Resolver, который получает адреса доступных нод (аля service discovery), Picker - модель, которая выбирает подходящее соединение (SubConn) для каждого запроса.

Клиент может поддерживать соединения сразу с несколькими нодами напрямую, если перед каждым запросом вызывать Picker, который выбирает подходящий SubConn по заданной стратегии - например round-robin или least-request, который тоже использует Power of Two Choices. Но в отличие от clbtransport, здесь выбор происходит уже между конкретными нодами, а не между пулами с агрегированным счётчиком активных запросов на каждый пул.

Не буду пересказывать то о чем можно почитать в доке gRPC. И подробнее про реализацию кастомного grpc балансировщика

На этих примерах хорошо видно, что балансировка зависит в том числе от уровня, где она вызывается.

В http.Transport для http 1.x L4 участвует только при создании соединения. Пока keep-alive соединение переиспользуется, новый выбор ноды не происходит - для этого нужно открыть новое соединение.

В gRPC балансировку встроили прямо в клиентскую модель: он поддерживает соединения с несколькими нодами напрямую и выбирает подходящую для каждого запроса. Нравится..

#go #perf
  • ❤ 14
  • 👍 7
  • 🔥 4
  • 👏 1
  • 🏆 1
Post #125 1.34K
Итераторы…

TL;DR: в iter.Seq итератор сам передаёт следующие элементы в код внутри range, а через yield получает сигнал и решает, продолжать ли обход. Ошибку можно передавать вторым значением через Seq2[T, error], но тогда, если она должна дойти до конца цепочки, все промежуточные итераторы тоже должны уметь её принять и передать дальше, даже если она им не нужна (!). Стоит ли оно такой запары?

Вспомним обычный обход:

for i := 0; i < source.Len(); i++ {
process(source.Get(i))
}

Это типичная pull-модель: внешний код сам сначала вытаскивает значение из источника Get(i), а потом передаёт его в бизнес-логику process.

Обратный вариант - обход с callback функцией:

source.Scan(func(v Value) bool {
process(v) // принимает то, что будет попадать из цикла ниже
return true
})

func (s *Source) Scan(process func(Value) bool) {
for i := 0; i < s.Len(); i++ {
if !process(s.Get(i)) {
return
}
}
}


Внешний код вызывает Scan один раз, а дальше уже Scan достает данные и сам вызывает коллбек process - в ответ получает bool и принимает решение об остановке. С точки зрения вызывающего кода это push-модель.

Многострадальные итераторы работают по тому же принципу, только такой callback-обход стандартизирован общим типом iter.Seq


go
func Numbers(n int) iter.Seq[int] {
return func(yield func(int) bool) {
for i := 0; i < n; i++ {
if !yield(i) {
return
}
}
}
}


Коллбек-механика спрятана внутри range:


go
for v := range Numbers(10) {
// бизнес логика тут, а вызывает ее код из Numbers
if v == 5 {
break
}
}


Numbers сам вызывает yield с очередным значением. Код внутри range получает значение, обрабатывает (в нашем случае сравнивает с 5), и отдает bool итератору, где последний решает, продолжать ли обход.

С остановкой по инициативе коллбека внутри range всё ок. Но что, если продолжить обход не может уже сам итератор - например, если чтение следующего значения закончилось ошибкой.

В Seq[T] передать её некуда. Один из вариантов - вынести ошибку во второе значение:


func Values() iter.Seq2[int, error] {
return func(yield func(int, error) bool) {
for i := 0; i < 10; i++ {
v, err := readValue(i)
if err != nil {
yield(0, err)
return
}

if !yield(v, nil) {
return
}
}
}
}


Тогда ошибка приходит в тот же range, что и данные:


for v, err := range Values() {
if err != nil {
return err
}

process(v)
}


Для одного итератора это выглядит естественно. Но в композиции с другими итераторами, например c


func Double(seq iter.Seq[int]) iter.Seq[int] {
return func(yield func(int) bool) {
for v := range seq {
if !yield(v * 2) {
return
}
}
}
}


eсли ошибка из Values должна пройти через Double до конечного потребителя, то`Double` (который сам упасть не может и которому не нужна ошибка), вынужден перейти на Seq2[int, error] (иначе у нас просто не скомпилится тк Double принимает `Seq[int]`) и явно передавать чужую ошибку

Чтобы не разводить зоопарк предложили даже собирать такие ошибки через отдельный хелпер`slices.CollectError` в #70631


func CollectError[T any](seq iter.Seq2[T, error]) ([]T, error) {
var err error

result := slices.Collect(func(yield func(T) bool) {
for v, e := range seq {
if e != nil {
// записываем первую ошибку
err = e
// завершаем обход
return
}

if !yield(v) {
return
}
}
})

return result, err
}


Просто как кейс стандартизации обработки ошибки через Seq2[T, error]. Или очередной способ задать себе правила 😗

Еще нашла #71901 где решают, какой контракт для итераторов с ошибками стоит считать стандартным. Но мне страшно туда лезть..

#go
GitHub proposal: slices: add CollectError · Issue #70631 · golang/go Proposal Details Idiomatic go functions are often in the form func (...) (T, err). When creating iterators, it is equally common for the underlying functions to potentially return an error as each ...
  • ❤ 14
  • 🔥 5
  • 👍 3
  • 😱 2
Post #124 1.54K
Что на самом деле нужно сохранять при сериализации сложной структуры?

TL;DR: Важно отделить логические данные от производного состояния: часть структур можно восстановить после загрузки, а часть - вообще заменить другим физическим представлением под нужный сценарий.

Вспомним хотя бы слайс: само значение - это дескриптор с указателем на нижележащий массив, len и cap. После рестарта старого расположения памяти всё равно не будет: появится новый массив и новый дескриптор. То же самое относится к lookup-таблицам, оффсетам, кешу и другим производным структурам, которые существуют ради удобной работы с данными в рантайме.

Поэтому в вопросе сохранения структур для дальнейшего переиспользования можно отделить основные данные от производного состояния: сохранить то, что нельзя потерять, а всё, что однозначно выводится из данных, построить заново после загрузки.

В инвертированном индексе каждый раз заниматься переиндексацией дорого, поэтому были добавлены два варианта экспорта структур в файлы: snapshot, если после загрузки есть необходимость менять индекс (например, дополнять его новыми термами), и sealed segment, если после загрузки индекс используется только для поиска.

Возьмём упрощённый пример:


"go" -> doc 10: [2, 7]
doc 14: [3]


go — term, 10 и 14 — документы в posting list, [2,7] и [3] — позиции слова.

Например flat.Index состоит из следующих частей:


type Index struct {
arena []byte // где лежат термы
entries []entry // где хранятся оффсеты термов в арене и список документов
byHash map[uint64]int32 // поиск entry по его term hash
positions [][][]uint32 // позиции слова для каждого документа внутри каждого entry
}


Snapshot: сохранить данные для восстановления mutable-структуры

В snapshot мы сериализуем в отдельный файл термы, документы и позиции слов - то есть логическое состояние индекса. При загрузке по этим данным заново собирается flat.Index, после чего в него снова можно добавлять данные.

Чтобы уменьшить размер snapshot, DocOrd сохраняются как разница с предыдущим ordinal, а получившиеся числа кодируются через uvarint. Про uvarint и delta encoding я рассказывала тут.

При загрузке декодер восстанавливает абсолютные DocOrd, последовательно прибавляя сохранённые дельты, а затем собирает структуру индекса заново. byHash мапа после этого тоже строится заново по загруженным термам.

(де)сериализация на примере flat индекса

Segment: сохранить read-only индекс без восстановления структуры вообще

В segment режиме сериализации экспортируются те же основные данные: термы, списки документов, позиции термов - в отдельный read-only бинарный формат. Он разделен на области байт по назначению:


[header][postings area][positions area][term index][footer]


Postings и positions участки лежат подряд, а term index хранит оффсеты и длины диапазонов для каждого терма.

Поэтому при загрузке такого сегмента обратного преобразования индекса в структуру flat.Index уже нет. Для запроса "go" мы находим его оффсеты в term index, берём через mmap (или через обычный `ReadAt`) только нужный диапазон данных и декодируем postings: подробнее про построение segment.

То есть в snapshot данные сначала декодируются, а производные структуры типо byHash собираются заново - получаем готовую к использованию структуру индекса.

В sealed segment эти структуры вообще не нужны: данные сразу раскладываются в компактный формат с оффсетами, который оптимизирован под чтение.

Получается, что одни и те же логические данные можно сохранить по-разному в зависимости от того, что нужно после загрузки.

Этот вывод не относится только к поисковым системам: при сохранении сложной структуры не нужна ее in-memory копия. Производное состояние можно не сохранять, если его дешевле восстановить. А если после загрузки данные будут использоваться иначе, из одного и того же состояния можно вообще построить другое физическое представление - под запись или только под чтение.

PS: finally совесть чиста и можно готовить вторую часть про HSNW

#fts #perf #projects
Telegram Daria’s room Запечатываю крупную структуру индекса в бинарь через mmap, uvarint и delta encoding Сложно сказать, в какой момент FTS индекс превратился в большой набор гошных структур, но это надо было как то решать, тк восстанавливать весь индекс каждый раз при старте…
  • 👍 12
  • ❤ 4
  • ✍ 2
  • ⚡ 2
  • 🆒 1
Post #123 2K
Привет!

Вас стало больше, так что пора наконец представиться 🙂 Я Даша, давно пишу на Go, но на своем тернистом пути постоянно нахожу интересности во внутренностях языка. Пишу про производительность, работу с бд и свои наблюдения, которыми грех не поделится.
Параллельно развиваю свой поисковый движок FTS engine (который в народе прозвали Fast Turtle Search): https://github.com/dariasmyr/fts-engine

Из-за него тут регулярно появляются посты про full-text search, индексы, фильтры, хранение данных и разные эксперименты вокруг темы поисковиков.

Пока тут легкий хаос с темами: от рабочих кейсов до иногда странных углублений в исходники и ищьюс ;’) Чтобы во всём этом было чуть проще ориентироваться, я разметила посты тегами:

#go - Go, рантайм, реализации техник и описание внутрянки
#perf - производительность, профилирование и бенчи
#db - базы данных, оптимизации
#fts - поиск, индексы и устройство движка
#projects - мои проекты и эксперименты


Пишите, если заинтересовала какая то тема или идея, буду рада обсудить.

Welcome!
GitHub GitHub - dariasmyr/fts-engine: Modular full-text search engine in Go with pluggable indexes, filters, and customizable text processing… Modular full-text search engine in Go with pluggable indexes, filters, and customizable text processing pipelines. You can instantly index your docs (radix, HAMT), apply probabilistic filters, and ...
  • ❤ 59
  • 👍 12
  • 🔥 7
  • 😱 1
  • 🐳 1
Post #121 1.93K
HNSW: как устроен графовый индекс для векторного поиска

One million years later, я наконец добралась до прикручивания в проект семантического поиска.

Тащить ради этого отдельную векторную бд максимально не хотелось, поэтому решила пойти классическим путем - попробовать встроить индекс HNSW прямо в движок наравне с остальными индексами.

Если кратко, HNSW - это графовый индекс для approximate nearest neighbor поиска по векторам. Вместо того чтобы сравнивать запрос со всеми векторами в индексе, HNSW заранее связывает близкие векторы в многоуровневый граф, а во время поиска двигается по этим связям в сторону все более похожих кандидатов.

Как обычно, решила разобраться, как HNSW вообще работает:

1. зачем графу несколько уровней;

2. как выбирается entry point;

3. почему сверху greedy поиск, который расширяется на ниженем уровне;

4. что делают параметры M, efSearch и efConstruction;

5. почему при построении нельзя просто соединить ноду с M ближайшими;

6. и как работают reverse links и pruning.


В итоге текста получилось на статью :") Пока без реализации и бенчмарков, а просто разбор внутрянки индекса.

Старалась написать максимально подробно и понятно, читать тут: https://gist.github.com/dariasmyr/d492c3388feaf0f779571a635a3b493e

В следующих сериях напишу, каким blazing fast оказался наш HNSW

#fts #projects
  • 🔥 13
  • ❤ 5
  • 👏 2
Post #120 1.82K
Недавно @dmedovich добавил в движок flat inverted index под данные с высокой кардинальностью и даже написал отдельную статью про его устройство и оптимизации. Мое дело, конечно, найти, что из этого имеет смысл перенести в мои существующие индексаторы HAMT/radix. Потому что заинтересовала меня не столько хешмапа, на которой строится индекс, сколько обвязка вокруг нее.

Начала с простого: fast append для списка документов.

У каждого слова есть список доков, где оно содержится (postings). Эти postings отсортированы по внутреннему числовому индексу документа (ordinal). При обычной индексации ordinal почти всегда инкрементится по возврастанию: 1, 2, 4, 7, 8...

Ранее для вставки, например, документа с ordinal 6, требовалось проходится бин поиском по всему срезу ordinals для поиска индекса между 4 и 7. Но в типичном случае новый ordinal просто больше последнего, поэтому сначала можно проверить хвост (подробнее):


last := len(d) - 1

// Если last документ совпадает с добавляемым - просто увеличиваем частоту.
if last >= 0 && d[last].Ord == ord {
d[last].Count++
return d
}

// Новый документ
if last < 0 || ord > d[last].Ord {
return append(d, fts.DocRef{
Ord: ord,
Count: 1,
})
}

// Док с индексом в середине, ищем нужное место по бин поиску
i := sort.Search(len(d), func(i int) bool {
return d[i].Ord >= ord
})
}


Получился быстрый путь для вставки доков с фоллбеком на бинпоиск. Добавила это оптимизацию в итоге и в HAMT, и в radix.

Вторая идея: fast + rest для списка postings

Допустим,`rare-word` терм встретился только в одном документе:


rare-word -> [doc 42]


В обычном HAMT список документов хранится в cлайсе []Posting. Даже ради одного дока 42 создаётся слайc и все ему сопутствующее, в котором лежит этот единственный posting. Таких редких термов в высококардинальных данных может быть очень много.

Идея first + rest в том, чтобы первый posting хранить прямо внутри entry:


type postings struct {
first Posting
rest []Posting
}


Тогда для term, который встретился только в одном документе (`df=1`), first содержит этот документ, а rest остаётся ниловым. Если term встретился ещё раз, следующие документы уже складываются в rest:


df=1: first=[42] rest=nil
df=3: first=[42] rest=[57, 81]


Для данных, где df=1 термов очень много, можно скосить по аллокации. Но мой HAMT - скорее индекс общего назначения, поэтому мне было интересно, что будет по бенчам на обычном тексте. Для начала прогнала тест на 4096 синтетических термов.


HAMT 22433 allocs/op
HAMT-first 18337 allocs/op


Ожидаемо, разница ровно 4096 - исчезло по одной аллокации на каждый терм. Но B/op почти не изменился: массивы мы убрали, зато увеличили структуру entry за счет поля first.

Дальше был Zipf тест, где одновременно есть редкие, среднечастотные и частые слова, где HAMT-first реализация стабильно проигрывала.

В конце сравнила оба варианта на 50k документов Simple Wikipedia:


build +0.6% у HAMT-first
heap 610.3 -> 611.5 MB
heap objects -4.6%

term search -2.4%
boolean ≈ одинаково
phrase +0.9%


То есть first + rest делает свое дела за счет уменьшения количества маленьких heap-объектов. Но на обычных запросах это не дало ни меньшего retained heap, ни ускорения поиска.

Получается, цена фичи - это оптимизация df=1, но поле first появляется у каждого терма - в том числе у тех, у которых есть появления в куче других документов. Плюс надо будет работать с разделением first/rest, что как-никак влияет на читаемость.

Поэтому HAMT индекс с first+rest я решила не оставлять. Но сама идея вполне рабочая. Просто, кажется, ей действительно подходит отдельный хешмап индекс, где df=1 - основное свойство данных (например, логи), а не частный случай внутри универсального текстового индекса по обычным докам (например статьям). Ну и я поняла, что недостаточно смотреть только на`allocs/op` - можно убрать кучу аллокаций и в итоге вообще не уменьшить размер хипа.

#fts #projects #perf
Daniil Medovich Плоский инвертированный индекс для данных высокой кардинальности Как общая arena для байтов, inline-postings, ленивое хранение позиций и компактный порядок термов помогают изменяемому индексу работать с высокой кардинальностью.
  • 🔥 9
  • ❤ 7
  • 👍 4
  • ⚡ 1
  • 🤯 1
Post #119 1.39K
Отделяем текстовый скоринг от продуктового ранжирования

Как оказалось, научить поисковый движок находить релевантные документы = только половина задачи. Следующий вопрос в том, какие из найденных совпадений важнее для конкретного продукта.

Окей, движок уже умеeт строить индексы по нескольким полям (title, abstract и т.д.) и поддерживает разные типы поиска: например term, phrase, prefix, фразовый поиск. Но после поиска вклад каждого совпадения просто добавлялся в итоговый вес документа. Например, для запроса`title:diabetes abstract:"type 1" abstract:insulin*` мы находили три независимых совпадения:

• term - diabetes в title;
• phrase - "type 1" в abstract;
• prefix - insulin* в abstract.

Для каждого совпадения BM25 считал свой вес, после чего все веса просто суммировались:

BM25 total doc score =
BM25(title:diabetes)
+ BM25(abstract:"type 1")
+ BM25(abstract:insulin*)


Базово текстовая релевантность оценена за счет частоты термина, его редкости среди всех документов, длине поля. И это ок, но продуктово мы помимо всего знаем, что совпадения в заголовке обычно важнее совпадения в abstract, и что точная фраза часто ценнее совпадения по одному слову (или хотя бы по префиксу).

Поэтому я подсмотрела идею с Rank Profiles - добавлением правил ранжирования по заданым критериям, который добавляет веса нужным докам без переиндексации.

Пример профиля из конфига:

rank_profile:
name: debug-weights

field_weights:
title: 1.5

query_type_weights:
term: 1.5
phrase: 1.7
prefix: 0.5


Теперь BM25 по-прежнему считает базовый score каждого совпадения, но перед суммированием вклад умножается на коэффициент:

document score =
BM25(title:diabetes) × 1.5 × 1.5
+ BM25(abstract:"type 1") × 1.0 × 1.7
+ BM25(abstract:insulin*) × 1.0 × 0.5


Поскольку индекс уже хранит информацию о каждом найденном совпадении (поле, тип запроса и базовый вес), политику ранжирования теперь можно менять прямо во время поиска - без переиндексации документов с явным разделением ответственности:

• основная retrieval часть находит совпадения и сохраняет их контекст;
• BM25 считает базовую текстовую релевантность;
• Rank Profile задает правила, по которым совпадения влияют на итоговый вес документа;
• Explain разбивка помогает понять, почему документ получил именно такой вес.

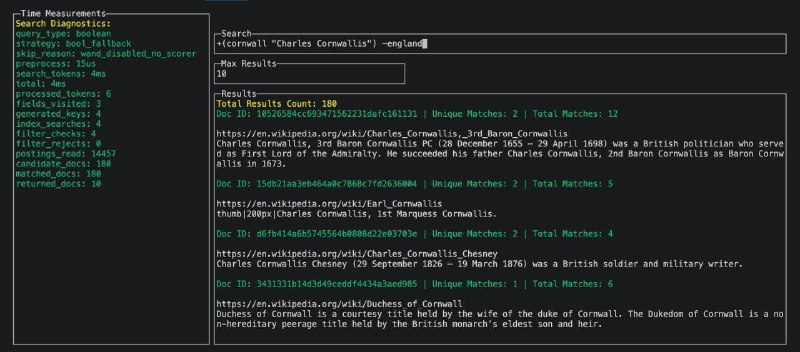
Чтобы было проще отлаживать ранжирование, добавила Explain-панель. Для каждого документа можно посмотреть, из каких вкладов сложился итоговый вес: какое совпадение сработало, в каком поле, какой базовый вес посчитал BM25, какие коэффициенты применились и какой вклад каждое совпадение внесло в итоговый результат.

На скрине из TUI (который, кстати, был тщательно причесан и допичкан инфо панельками) как раз видно такую разбивку по весам для каждого найденного документа.

Сейчас Rank Profile умеет учитывать поле документа и тип совпадения. В дальнейшем список сигналов можно расширить: например, добавить свежесть документа, популярность или поведенческие сигналы (клики пользователей). Главное, чтобы поисковый движок умел вычислить такой сигнал - тогда его можно включить в ranking pipeline без изменения индекса.

В итоге базовый текстовый скоринг остается отдельным слоем, а продуктовая логика ранжирования начинает жить поверх него. Это позволяет менять стратегию ранжирования, не меняя сам индекс.

#fts #projects
  • ❤ 13
  • 🔥 4
  • 👍 2
  • 🤯 2
Post #116 1.45K
Daria’s room Почему коннекты растут быстрее, чем RPS Недавно разбирала кейс: в pgx пуле резко выросло количество соединений, условно с 10 до 80. Но RPS вырос совсем немного, поэтому объяснение типа "стало больше запросов, значит нужно больше коннектов" не совсем сходилось.…
В продолжение темы про коннекты: выше описывала кейс про pgx-пул, где коннекты росли быстрее, чем RPS, потому что запросы стали дольше удерживать соединения.

В этот раз кейс тоже про коннекты, но уже HTTPшные: ручка начала отвечать почти в 2 раза дольше, хотя ни бд, ни зависимый сервис по отдельности такого роста не показывали.

Представим: есть сервис A. Внутри он ходит в другой сервис - B. Запрос может прийти с большим количеством ID, поэтому мы аккуратно режем его на батчи по 100 ID и ходим в сервис B конкурентно через waitgroup. Соответственно, результат ручки можно вернуть только после выполнения всех батчей.


RT сервиса A = RT максимального батча в сервис B + DB + сетевой оверхед


На запросах 100–300 ID всё выглядело ожидаемо: сервис A в p99 работал за 90–100 мс, а внутри включал 70 мс сервиса B + 20 мс в базе + небольшой оверхед

Но на 500 ID p99 сервиса A вырос примерно до 200 мс.

Сначала подумала на бд, но запросы туда подорожали максимум на 10 мс. Даже если заложить это в общий путь, ожидалось что-то вроде роста со 100 мс до 120, но точно не 200. Аналогично с сервисом B, время ответа которого в p99 особо не поднялось, поэтому он не был причиной роста ручки выше.

Коллега предложил интересную идею - посмотреть на хвостовые задержки.

Вспомним, что при распараллеливнии запросов сервиса А ждет самый долгий запрос в сервис B. Поэтому p99 может зависеть не от p99 сервиса B, а от более долгого запроса.

На 500 ID у нас получается 5 параллельных вызовов в сервис B. Если взять время, соответствующее p99 одного вызова в сервис B, то каждый отдельный вызов уложится в него с вероятностью 99%. Но для сервиса A нужно, чтобы в это время уложились все 5 вызовов:


0.99^5 ≈ 0.95


То есть p99 сервиса B для запроса с 5 батчами превращается примерно в p95 сервиса A. Чтобы получить именно p99 сервиса A, нужно смотреть глубже в хвост сервиса B:


x^5 = 0.99
x = 0.99^(1/5) ≈ 0.998


Выходит, что p99 сервиса A при 5 параллельных батчах примерно смотрит на p99.8 одного вызова в сервис B.

(В реальности эти вызовы не полностью независимы, у них может быть общий хост, клиент, пул соединений. Но доказывает главное: распараллеливание запросов ставит в зависимость от хвостовых задержек.)

Следующий вопрос: откуда у части вызовов в сервис B берётся хвост? нам просто не хватило свободных коннектов.

HTTP-клиент переиспользует уже открытые соединения. Если есть готовый idle-коннект, то запрос уходит на него без создания нового. На тот момент MaxIdleConnsPerHost был 25, то есть столько уже созданных свободных соединений можно держать для переиспользования на один хост.

На 500 ID и 50 RPS получалось:


50 RPS в сервис A * 5 батчей = до 250 RPS на сервис B


Но тут еще нужно учесть время вызова: если один вызов в сервис B занимает примерно 100 мс, то бы получаем 250 RPS * 0.1 сек = 25 одновременных вызовов, и это ок пока ок для нас. Но если часть вызовов уходит в хвост и начинает занимать 150–200 мс, то нужно уже больше коннектов: 250 RPS * 0.2 сек = 50 соединений.

В итоге готовых соединений стало не хватать. Часть батчей переиспользовала уже открытые соединения, а часть попадала на оверхед создания нового соединения. При waitgroup достаточно одного такого батча, чтобы p99 всей ручки улетел вверх.

Чтобы проверить гипотезу, коллега предложил свести на один график:


p99.9 latency сервиса A
open HTTP connections до сервиса B
p99 duration сервиса B


На котором стало видно корреляцию:


соединений мало / они нестабильны
→ хвост сервиса A растёт

соединений становится больше и они покрывают всплески
→ RT сервиса A падает


В итоге мы просто подняли лимит idle коннектов с 25 до 50. На проверке при тех же условиях с 500 ID и 50 RPS ручка стала отвечать примерно за 100–120 мс вместо 200 мс.

Вывод: если ручка распараллеливает запросы во внешний сервис и ждёт все батчи до последнего, её RT определяется самым медленным вызовом. А из-за хвостовых задержек вероятность поймать такой медленный батч растёт. Дальше задача - найти причину хвоста. В этом кейсе ей это нехватка HTTP коннектов.

#go #perf
  • ❤ 12
  • 👍 6
  • 🔥 6
  • 🏆 1
Post #115 1.32K
Почему коннекты растут быстрее, чем RPS

Недавно разбирала кейс: в pgx пуле резко выросло количество соединений, условно с 10 до 80. Но RPS вырос совсем немного, поэтому объяснение типа "стало больше запросов, значит нужно больше коннектов" не совсем сходилось.

Потому что количество занятых коннектов зависит не только от того, сколько запросов приходит, но и от того, как долго каждый запрос удерживает соединение (находится в состояния acquired) внутри пула:


busy concurrent connections ≈ RPS × connection hold (acquired) time


Например, имея 100 RPS и 100 ms времени удержания коннекта мы получим 10 одновременно занятых коннектов.

А если RPS вырос до 160, но коннект из-за внутренней задержки стал удерживаться 500 ms, то получается: 160 RPS × 500 ms = 80 одновременно занятых коннектов

В итоге пул выглядит так, будто нагрузка выросла в 8 раз, хотя RPS не сильно вырос.

Главное, что нужно запомнить: коннект считается занятым с момента, когда приложение получило его из пула, и до момента, когда вернуло обратно.

Это если воспроизводить цепочку событий:


запросы приходят
↓
старые соединения дольше не освобождаются
↓
idle коннектов почти нет
↓
если idle коннектов нет, pgx еще не дошел до MaxConns и начинает создавать новые
↓
pool доходит до лимита
↓
новые запросы ждут свободный коннект
↓
растет AcquireDuration
↓
растет общий RT приложения


В моем случае pgx коннект мог быть уже получен, но дальше запрос может ждать свободное серверное соединение внутри своего пулера (Odyssey, PGBouncer, etc). Для pgx такой коннект уже занят, поэтому метрика типо AcquiredConns может расти, а IdleConns падать.

При этом AcquireDuration сначала может быть нормальной. Она начнет расти позже, к моменту когда из-за таких долгих удержаний коннектов уже закончится сам pgx пул.

Итого, сам по себе кейс вышел самым банальным: чтобы понять резкое увеличение коннектов при небольшом росте RPS, нужно ответить на вопрос, почему коннект стал удерживаться дольше.

А там уже может быть все разнообразие причин, начиная с ожидания внутри пулера и заканчивая самими запросами.

#db #perf
  • 👍 12
  • ❤ 4
  • 🔥 3
  • 🏆 1
Post #111 1.61K
Пришло время наконец-то сравнить, как выглядит fts рядом с другими полнотекстовыми движками.

Ранее я писала серии постов с разборами работы индексаторов radix и HAMT, но остался вопрос, что это даёт на реальных поисковых сценариях.

Поэтому я собрала небольшой benchmark suite в виде отдельного подпроекта и прогнала свой fts рядом с другими гошными индексаторами bleve (не смейтесь) и blue на нескольких типах запросов:


term — поиск одного слова
and — несколько обязательных слов
or — несколько альтернативных слов
phrase — точная фраза
prefix — поиск по началу слова

Меня интересовало конкретно: время билда, размер индекса, время поиска, QPS и основные метрики качества выдачи: Recall@k, nDCG@k, MRR.

Radix

Radix-индексатор ожидаемо оказался очень сильным на prefix запросах за счет хранения ключей через общие префиксы - поэтому для него это почти нативный сценарий. В цифрах это примерно так:


p50: 0.003 ms
p95: 0.026 ms
p99: 0.062 ms
QPS: 126080


При этом индекс оказался самым компактным:


fts-engine radix: ~160 MB
blue: ~307 MB
bleve: ~690 MB


Но сам билд занял около 24.66s при скорости индексации - 2028 docs/s, что сильно медленее конкурентов. По остальным типам запросом radix не обогнал конкурентов.

HAMT

Так как fts позволяет менять индексаторы, переключилась на HAMT (спасибо Pavlo!!) для сравения. Он уже устроен иначе, так как путь к ключу определяется фрагментами хеша.


radix: BUILD 24.66s, docs/s 2028, INDEX ~160 MB
HAMT: BUILD 19.68s, docs/s 2541, INDEX ~175.5 MB

Видно, что HAMT стал быстрее строиться, индекс немного вырос, но всё ещё остался заметно меньше.

Тут нет большого выигрыша относительно radix, но HAMT обогнал конкурентов на нескольких обычных fts сценариях с поиском по отдельным словам:


term QPS:
bleve 1256
blue 2344
fts-engine 3048

and-hl QPS:
bleve 1465
blue 2301
fts-engine 7966

phrase QPS:
bleve 354
blue 169
fts-engine 1301

Особенно удивил результат по фразовому поиску - HAMT тут быстрее в несколько раз. Опустим провал с префиксами - в HAMT там тупо не реализован и висит на костыле из strings.HasPrefix() ;D

Bag of words

Отдельно я прогнала индексы по датасетам MS MARCO (спасибо Даниилу за идею) и синтетическим данным: в частности, эти тесты были именно на запросах с поиском по группе слов с оператором OR, иначе говоря - bag-of-words.

На MS MARCO fts почти догнал bleve по качеству:


Recall@k: bleve 0.8666 / fts-engine 0.8589
nDCG@k: bleve 0.7398 / fts-engine 0.7325
MRR: bleve 0.7040 / fts-engine 0.6963


Индекс fts опять заметно меньше, но все еще отстает по скорости:


bleve: 133.8 MB
blue: 66.3 MB
fts-engine: 40.0 MB

QPS: bleve 2984 / fts-engine 863 / blue 179


На синтетических данных fts вообще дал самые плохие метрики на обоих индексах. То есть можно сделать вывод, что простой OR / bag-of-words поиск пока нельзя назвать сильной стороной fts вообще на любом индексе.

Вывод - индексаторы хороши для разных задач.

Radix подходит для префиксного поиска, как автодополнение, тут без новостей. А HAMT не является заменой radix, но быстрее строится и сохраняет хороший QPS на обычных полнотекстовых запросах, причём на бОльшей части сценариев обгоняет bleve и blue.

Имеет смысл даже использовать гибрид - там, где это позволяет структура проекта. Пока fts выглядит конкурентно по размеру индекса и части классических term запросов, но bag-of-words (ms marco) и качество ранжирования ещё явно требуют доработки.

Ps: ниже таблички с бенчами по порядку: radix->hamt. Первый тип бенчей по wiki дампу с разными запросами, второй - на MS MARCO

#fts #projects #perf
  • 🔥 10
  • ❤ 2
  • 👍 2
  • 🏆 1
Post #110 1.38K
Запечатываю крупную структуру индекса в бинарь через mmap, uvarint и delta encoding

Сложно сказать, в какой момент FTS индекс превратился в большой набор гошных структур, но это надо было как то решать, тк восстанавливать весь индекс каждый раз при старте стало не очень.

Что если вынести часть индекса из памяти на диск как отдельный immutable segment - компактный бинарный файл со своим форматом, который собирается один раз, больше не меняется (для определенных кейсов это подходит) и используется только при чтении.

И вот как может выглядеть структура для файла сегмента:

[header][postings area][positions area][term index][footer]

header хранит сигнатуру формата и версию, postings area - списки postings, positions area - позиции токенов, term index - оффсеты до данных конкретного терма, а footer помогает при чтении быстро найти term index в конце файла.

Структура пригодится нам в будущем, сейчас главное запомнить, что при чтении мы не восстанавливаем весь индекс в память: мы открываем файл, читаем таблицу термов, находим в ней оффсет нужного терма и дальше берем из файла только конкретный кусок байт.


term -> offset -> byte range -> decoded postings


Переходим к двум важным компонентам: uvarint и mmap.

uvarint

Ранее я писала, что перешла со строковых DocID документов (postings) на числовые DocOrd - порядковые номера документа. Но даже число можно хранить по разному.

В posting lists часто много маленьких чисел: частота терма в документе обычно небольшая, позиции токенов тоже небольшие, а соседние DocOrd часто лежат близко друг к другу. Поэтому можно вместо типов фиксированных размеров аля uint64 попробовать uvarint

Если коротко, то через uvarint маленькие числа занимают меньше байт, большие - больше. Для этого число разбивается на группы по 7 бит, где восьмой - старший бит используется как флаг продолжения.
Возьмем число 300. uvarint берем нижние 7 бит, потом сдвигает число вправо на 7 бит и повторяет процесс, пока не получит 0:

300 & 0x7F = 44
300 >> 7 = 2

2 & 0x7F = 2
2 >> 7 = 0

И у нас два 7-битных куска по 44 и 2. Первый байт будет с флагом продолжение, второй - без флага, потому что число закончилось.

Для работы с числами через uvarint есть методы binary.AppendUvarint(buf, x) и
binary.Uvarint(data)

В сегменте я использую uvarint почти везде, где нужно записать число: для длин, оффсетов, DocOrd, Count, количества позиций и самих позиций.

Вместе с этим для компактного хранения используется маленькая оптимизация в виде delta encoding. Когда то в чате по математике меня удивила простота этого метода: вместо хранения полных id документов:`1, 3, 8` - можно хранить разницы: 1, 2, 5. При чтении можно восстановить исходные значения обычным накоплением.

Главное, что это хорошо сочетается с uvarint, так как числа меньше и занимают они меньше байт.

mmap - memory mapping

Фишка mmap в том, что мы говорим ОС отобразить файл в виртуальное адресное пространство процесса. После этого мы получаем диапазон байт, к которому можно обращаться почти как к обычному []byte. Но в отличии от os.ReadFile, весь файл сразу не загрузится в память. Если файл сегмента весит 1 GB, мы не будем грузить 1 GB в память сразу. ОС может подгружать реальные страницы лениво. Если соответствующей страницы еще нет в памяти, произойдет page fault: процесс обратится к адресу, ОС поймет, что этот адрес относится к отображенному файлу, подгрузит нужную страницу и продолжит выполнение.

Например, мы хотим прочитать posting list для терма alpha, он есть в term index:

postingsOff = 120
postingsLen = 15

и берет только нужный диапазон:

data[postingsBase+120 : postingsBase+120+15]


Именно поэтому mmap хорошо подходит для immutable segment: файл не меняется, данные лежат подряд, у каждого терма есть оффсет и длина. Но syscall.Mmap - поддерживает только Unix подобных, поэтому на других платформах нужен фоллбек типо os.ReadFile.

Подробнее про сегменты. Отдельная благодарность за идею @dmedovich_notes

#fts #perf #projects #go
GitHub fts-engine/pkg/segment at index-optimisation · dariasmyr/fts-engine Modular full-text search engine in Go with pluggable indexes, filters, and customizable text processing pipelines. You can instantly index your docs (radix, HAMT), apply probabilistic filters, and ...
  • 🔥 7
  • 👍 5
  • ❤ 2
  • 🏆 2
  • 👀 2
Post #109 1.21K
Tombstones и логическое удаление

Одна из вещей, с которыми рано или поздно придется столкнуться в процессе работы с индексером, это удаление документов.

Представим, что у нас есть внутренний реестр документов:


idToOrd:
{
"docA":0,
"docB":1,
"docC":2
}

ordToID:
[
"docA",
"docB",
"docC"
]


Здесь внешний строковый ID документа преобразуется во внутренний порядковый номер (ordinal):


docA -> 0
docB -> 1
docC -> 2


Но зачем вообще нужен отдельный ordinal? Cуть в том, что почти все внутренние структуры индекса работают с числами, а не со строками. Например, в списке документов (postings lists), просто потому что инты дешевле:


"cat" -> [0,1,2]
"red" -> [1]
"dog" -> [1,3]


Вернемся к вопросу с удалением. Конечно, возможен вариант типо delete(idToOrd, "docB"), но он абсолютно не подходит. Как минимум потому что документ исчезнет только из реестра, а во всех postings lists он останется:


"cat" -> [0,1,2]
"red" -> [1]
"dog" -> [1,3]


Чтобы удалить его полностью, придется пройти по всему индексу и убрать оттуда удаляемый id (в нашем случае 1).

Вариант решения: делать не физическое удаление, а логическое, например через tombstone. Конкретно в этой реализации tombstone представляет из себя bitset, где каждому биту внутри соответствует не слово, а один документ (через его ordinal).

Например:


docA -> 0
docB -> 1
docC -> 2
docD -> 3


Тогда битсет читается так:


bit: 3 2 1 0
↓ ↓ ↓ ↓
D C B A


Если документ docB удаляется:


go
ord, ok := registry.Has("docB")
if ok {
tombstones.Set(ord)
}


Для ord=1 установится бит:


tombstones:

00000010


Сам документ сохранен в индексе, просто помечается как удаленный. Во время поиска проверяем, включен ли в tombstone соответствующий бит, если да - док удален, не тратим время не поиск:


go
for _, ord := range posting {
if tombstones.IsSet(ord) {
continue
}

results = append(results, registry.Lookup(ord))
}


Внутри это выглядит довольно просто: ordinal документа разбивается на номер слова в массиве и номер бита внутри этого слова.


word := uint32(ord) / 64
if int(word) >= len(t.bits) {
return false
}
return t.bits[word]&(1<<(uint32(ord)%64)) != 0


На примере с ord := 130 получится: word = 2 и bit = 2

Итак, пользователь никогда не увидит удаленный документ, хотя физически он все еще лежит внутри индекса. А у нас выходят ништяки:
* проверка удаления работает за O(1), так как tombstone - обычный слайс bits []uint64.
* памяти может занять прилично, и дело даже не в количестве доков (на 10 млн доков выйдет около 1.25mb - деграднет сам поиск по такому слайсу за счет роста лишних проверок и роста postings). Решение - это делать периодическую реиндексацию с перестроением tombstone слайса (compaction). Ну и на уровне архитектуры индексов сегментировать, то есть строить небольшие обособленные индексы по сегментам, а не один индекс на вес объем доков.
* не нужно переписывать postings lists, то есть проводить реиндексацию каждый раз - достаточно делать это периодически после накопления достаточного количества удаленных доков.

При наличии tombstones внутренний реестр документов обычно становится append-only: если удалить документ через tombstones, а потом снова добавить тот же документ в индекс, он может получить новый ordinal (id), пока старый всё ещё останется в индексе и tombstones.


docB -> 1
docC -> 2

tombstones:
010

// удаляем docB
registry.Forget("docB")
registry.GetOrAssign("docB")

// docB получает новый id в индексе
docA -> 0
docB -> 3
docC -> 2

// tombstones все еще содержит включенный 1-й бит
tombstones:
010


Довольно похоже на то, как работают многие системы хранения: сначала запись помечается как удалённая, а физическая очистка происходит отдельным процессом позже: когда индекс решает, что накопилось слишком много мусора и лучше пересобрать его заново. Напоминает классический принцип работы сборщика) или мапы

А в роли loadFactor переменной - триггера для пересборки можно завести простой счетчик удаленных документов.

#fts #perf #projects #go
  • 🔥 6
  • ❤ 4
  • 👍 4
  • 🦄 2
  • 😐 1
Post #108 1.25K
"Explain" plan для FTS

Заметила, что по мере усложнения поискового пайплайна метрика вроде p95 latency стала недостаточной. На одном из последних бенчей время ответа выросло на 30%, но по одной этой цифре невозможно понять, где именно возникла задержка, так как она может проявится как в разборе запроса, отборе кандидатов или ранжировании так и в попытке попасть в fast path.

Снаружи поиск выглядит как один вызов, но внутри мы выбираем разные стратегии в зависимости от семантики запроса. Поэтому даже похожие запросы могут выполняться по разному:


+postgres +wal
"postgres wal"
title:postgres


Они по-разному парсятся в AST и дальше попадают в разные стратегии выполнения.

Поиск по одному слову обычно прост: достаточно нормализовать токен, найти его в индексе и прочитать список документов. Стоимость здесь в основном зависит от количества кандидатов (postings list).

Поиск фразы дороже: нужно проверить не только наличие слов, но и их позиции, поэтому нужен positional index. Например, для "hotel barge" важно убедиться, что barge действительно идет после hotel и в нужном порядке.

Префиксный поиск, например bar*, требует, чтобы индекс умел определять слова с нужным началом, и простого поиска по ключу здесь недостаточно.

В boolean запросах, например +postgres +wal, самая дорогая часть здесь скорее в выборе стратегии: нужно искать пересечения между списками, хранением списка кандидатов, определит, использовать ли WAND или уйти в на фоллбек ветку.

Из-за этого метрика вида latency не отвечает, что именно стало дороже. Поэтому я добавила сбор диагностики, которую можно явно включить через контекст:


ctx := fts.WithDiagnostics(context.Background())
res, _ := engine.SearchDocuments(ctx, "postgres wal checkpoint", 10)


Диагностика показывает тип запроса, выбранную стратегию выполнения, причину пропуска fast path, число обращений к индексу, число прочитанных доков и время по этапам.

То есть получилось что-то вроде упрощенного execution plan для поиска:


strategy: bool_fallback
skip reason: non-term boolean clause
posting entries read: 180_000
candidate docs: 24_000
returned docs: 10


И вот мы уже имеем точку для отладки. Можно быстро понять, не сработал ли fast path, не прочитал ли движок слишком большой список кандидатов и не раздулся ли он до лимита.

Например, alpha beta gamma может выполниться через WAND, а запрос "alpha beta" gamma уже уходит в bool_fallback, потому что содержит phrase clause и не попадает в оптимизированный WAND. По диагностике видно, что меняется стратегия выполнения, растут posting entries read и candidate docs, хотя количетсво документов в результате остается тем же. Значит, причина задержки не в размере выдачи, а в том, что движок потерял WAND пропуск нерелевантных по весу доков и мы вынуждены обработать намного больше кандидатов.

Про бенчи: если смотреть только на задержку, можно не заметить, что поиск стал быстрее, но хуже по качеству. Поэтому в бенчах стоит смотреть как минимум на две группы метрик.

Пр качеству:
- nDCG показывает, насколько хорошо ранжирована верхняя часть выдачи.
- MRR показывает, насколько рано пользователь увидит первый правильный результат.
- Recall показывает, какую долю релевантных документов поиск вообще нашел.

По стоимости:
- latency
- posting entries read
- index lookups
- candidate docs
- распределение execution strategies

Поэтому если latency p95 улучшился, но nDCG упало, можно сделать вывод, что мы размениваем время в счет качества выдачи.

На мысль изначально меня натолкнула одна бизнесовая статья от VM про отдельный "observability" слой для AI агентов.

А вообще мотивация сделать что то похожее была еще в том, что такая диагностика делает разросшийся поисковый движок объяснимым: показывает не просто то, что запрос стал медленнее, а почему именно это произошло и сколько стоит каждый этап. Подробнее прилагаю пр, где можно посмотреть само решение. Также добавила слой с in memory аггрегатором статы в отдельном пакете ftsstats, чтобы не нарушать текущую пакетную структуру проекта.

#fts #projects
  • ❤ 8
  • 👍 8
  • ⚡ 3
  • 🏆 2
Older posts →

About this channel

How can I read @dariasroom without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Daria’s room: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Daria’s room have?
Daria’s room (@dariasroom) has 1.2K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Daria’s room know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →