
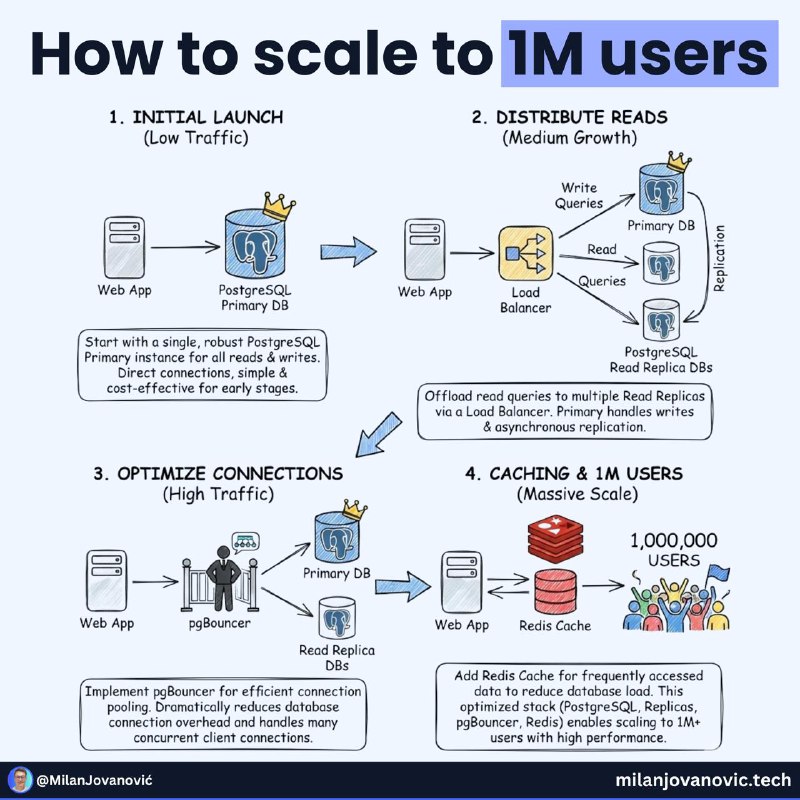
Автор работал над системой, которая выросла с нуля до более чем миллиона пользователей. Без сложных модных архитектур на старте и без преждевременного оверинжиниринга. Только последовательная эволюция под реальные нагрузки.
В начале всё было максимально просто:
Одно приложение - одна база данных.
И этого было достаточно.
Проблемы появились не в коде. Узким местом стала база данных. Архитектура развивалась шаг за шагом, решая конкретные проблемы по мере их появления.
1️⃣ Старт - один основной инстанс
Использовался один primary-инстанс PostgreSQL. Минимум инфраструктуры, низкие расходы и полный фокус на продукте.
Главная мысль этого этапа - не строить "архитектуру уровня Netflix" для проекта с десятками пользователей.
2️⃣ Разделение чтений - Read Replicas
Когда резко вырос read-трафик:
- Primary обрабатывал только записи
- Реплики обрабатывали SELECT-запросы
- Балансировщик распределял чтения
Кодовая база почти не менялась - менялась маршрутизация трафика.
Результат - база перестала быть узким местом из-за чтений.
3️⃣ Проблема соединений - добавление pgBouncer
При росте числа пользователей упёрлись не в CPU, а в количество соединений.
Каждое соединение к базе - это память и ресурсы. Тысячи коннектов начали "душить" систему.
Решение - connection pooling через pgBouncer:
- Меньше реальных соединений к БД
- Выше пропускная способность
- Меньше сбоев под нагрузкой
4️⃣ Масштабирование через кэш
Чтобы выдержать 1M+ пользователей, стало критично не обращаться к базе за каждым запросом.
Добавили Redis как слой кэширования:
- Часто используемые данные отдавались из кэша
- База перестала быть единственной точкой нагрузки
- Задержки заметно снизились
Именно на этом этапе начинается настоящее масштабирование.
Главный урок
На каждом этапе решалась текущая проблема, а не гипотетическая задача будущего.
| Проблема | Решение |
|---------|---------|
| Много чтений | Read Replicas |
| Слишком много соединений | Пул соединений |
| База перегружена запросами | Кэш |
| Сложная инфраструктура | Не добавлялась без реальной необходимости |Приложение существует, чтобы поддерживать бизнес.
Если бизнес-модель не работает, никакое масштабирование не спасёт.
Масштабирование - это не про технологии ради технологий.
Это про внедрение решений в тот момент, когда они действительно нужны.
milanjovanovic.tech/blog/scaling-monoliths-a-practical-guide-for-growing-systems