

Тут мне присылают видео, где блогер бодро объясняет: подключить защиту персональных данных к любимому ИИ-агенту — дело пары кликов. Посмотришь — и кажется, будто утечки закончились навсегда.
🔗 Вот эту модель рекомендовал блогер на видео: ссылка
Разбираю, почему на проде так не работает.
🚧 Откуда вообще проблема
У любого бизнеса — от стартапа до корпорации — есть обязанность защищать персональные данные сотрудников и клиентов. За утечку — штраф, а в договорах часто прямо прописано: «Исполнитель обязуется не передавать данные третьим лицам».
С одной стороны — ИИ, который ускоряет работу. С другой — безопасники, которые запрещают им пользоваться: запросы уходят в чужие юрисдикции и компании, а туда эти данные слать нельзя. За помощью обычно зовут инженеров.
😐 «Ну поставьте локальную модель»
Идеальный вариант — развернуть свою модель уровня Kimi K2.6 и гонять всю корпоративную работу через неё. Данные не покидают контур, анонимизация не нужна вообще. Одна беда: под такую модель нужны сотни гигабайт, а лучше терабайт видеопамяти. Мало у кого столько есть.
Вот тут и появляется анонимизация — как компромисс.
Поэтому фильтр должен быть маленьким и быстрым — он стоит на входе у каждого запроса. Ровно за этим OpenAI и выпустила privacy-filter: 1,5 млрд параметров, активны только 50 млн, крутится даже на CPU, без видеокарты. Кстати, именно эту модель и советовал блогер.
🧩 Как устроена анонимизация
Любая — это три задачи:
1. Найти в тексте всё чувствительное и определить тип: имя, телефон, счёт, адрес.
2. Модифицировать запрос к LLM так, чтобы модель могла понимать задачу с сохранением тегов, допустим заменить все перс данные на
<PII type="name" id="1">🚀 Такая модификация позволяет сохранить интент вопроса, допустим явно объявить LLM, что она действует в интересах person_2. А также явно укажет, сколько всего есть акторов и какие у них есть идентификационные свойства.
3 .Получить ответ от облачной модели и подставить реальные данные обратно вместо меток. Склонения иногда хромают, но это не критично.
⚠️ Где всё сыпется
Тут и вылезает разрыв между красивой презентацией и продом.
• На бенчмарке OpenAI заявляет 98% полноты. На моих реальных договорах фильтр из коробки оставляет до 30% персональных данных неразмеченными.
• Модель путает категории. Для телефона и номера счёта это не страшно. А вот если адрес уезжает в категорию «человек» — контекст для LLM становится шумным, растёт риск галлюцинаций.
• Простой фильтр без идентификаторов не различает людей — все имена схлопываются в одну метку. Договор на три стороны превращается в кашу: кто кому что должен, модель уже не понимает.
⚡ Планируйте фильтр как слой защиты, а не как галочку «мы защищены». Он снимает процентов 70, а не 100 — часть данных всегда просочится.
📏 Как это проверять
Я закидываю в фильтр документы, которые знаю наизусть, — договоры с юристами и подобное. Так видно и полноту детекта, и лишние теги.
Недавно RnD-команда red_mad_robot выложила бенчмарк для таких проверок:
🔗 Анонс
🔗 Датасет
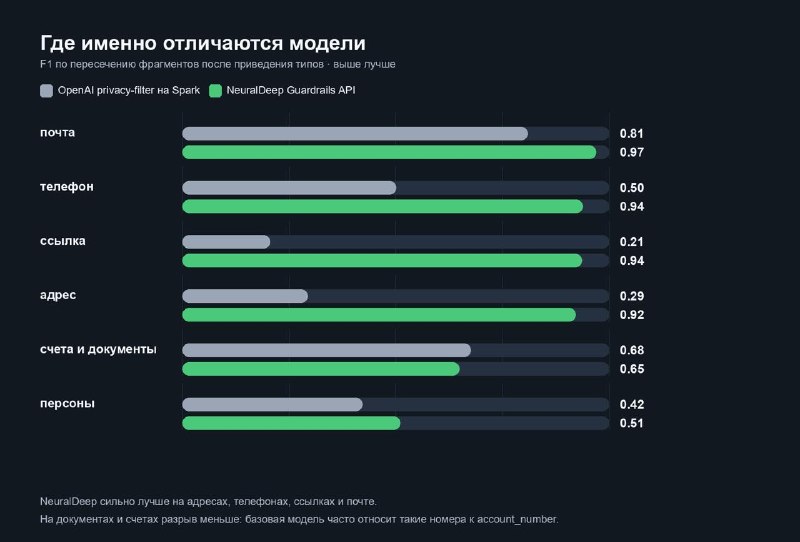
Я сравнил рекомендацию блогера с облачным анонимайзером NeuralDeep на этом же бенчмарке — облако заметно обходит опенсорс. Правда, честности ради: бенчмарк и облако делает одна команда, так что цифры стоит перепроверять на своих данных.
🎯 Что в итоге делать
Ставить локальные модели и не думать про анонимизацию вообще — если тянете по железу. Нужен локальный фильтр — берите опенсорс и дообучайте до продуктового качества, из коробки он сырой. Данные можно отдавать наружу, а хранить нужно в России — берите российского провайдера с договором, я тестировал на neuraldeep.ru.
Короче, зовите инженеров.
А чем чистите персональные данные вы — и удаётся ли выжать больше 90% полноты на реальных документах?
----
Поляков считает — AI, код и кейсы