
DeepSeek V4.1 Flash - наконец то пооноценный релиз...
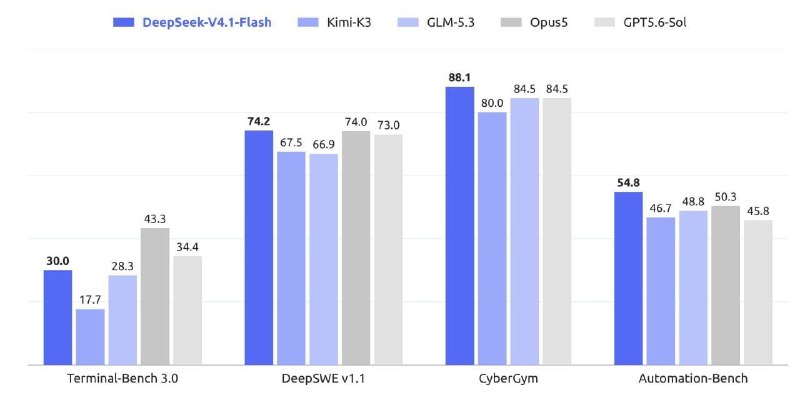
Давайте посмотри как на тестах выглядит китайская модель которая примерно от 5 до 20 раз дешевле всех моделей с кем ее сравнивали на графике.
Для понимания: Flash модель подразумевает что это "средняя или легкая" модель которая фокксируется не на размышлениях, а на скорости.
Американские флагманы делают вид что DeepSeek не существует, в то время как:
Новая модель Flash 4.1 получила 552 млрд параметров, но за один токен использует только 8 млрд при обработке входных данных и 16 млрд при генерации. За счет этого DeepSeek делает упор на длинные агентные задачи, где модели приходится постоянно работать с огромным контекстом.
Главное изменение внутри модели связано с KV Cache. DeepSeek сократила его размер до 890 байт на токен, примерно в четыре раза меньше прошлой V4 Flash. Это снижает требования к памяти при работе с длинными диалогами, кодовыми базами и агентами.
Модель мультимодальная, понимает текст и изображения, поддерживает контекст до 1 млн токенов и позволяет вручную задавать глубину рассуждений от 1 до 100. Мультимрдальность для вас на самом деле особо много не значит, это имеет разницу в програмах где нейронке заранее не дали инструменты читать изрбражения, например OpenCode о котором я часто писал, не имеет из коробки такой фичи.
На DeepSWE v1.1 она получила 74.2 процента, на Terminal Bench 2.1 набрала 90.6 процента, а на CyberGym 88.1 процента. В нескольких агентных тестах V4.1 Flash обходит GPT-5.6 Sol и Claude Opus 5.0.
Веса уже лежат на Hugging Face под лицензией MIT.
То есть это все для вас бесплатно если есть видюха нужного размера.
Теперь вы знаете почему я больше люблю азиатов 🚬
Post #351
56
- ❤ 3