Post #1935
1.7K
Channel Public Channel
 IT
IT Does Matter
@comol_it_does_matter
Заставляем ИИ работать за вас. В основном про вайбкодинг в 1С: https://vibecoding1c.ru/. Обсуждаем среды, практики, MCP, ИИ агенты и роботы.
- Subscribers
- 4.65K
- Photos
- 806
- Videos
- 69
- Links
- 1K
Showing posts older than #1936 · Back to latest
Older Posts 19 shown

Post #1934
1.72K
Ну не то чтобы сильно жалко.... Юзайте PWA вообщем. Времена приложений прошли :)
- 👍 4
- ❤ 1
Post #1933
2.12K
Большое обновление правил разработки с ИИ на 1С (это те что надо поставить вместе с MCP по возможности, чтобы "ваш ИИ стал нормально писать на 1С"):
✔️ verify, review и адаптация новыми моделями для новых моделей (Fable и Sol). Да, я основательно потратился на бесплатные правила. Но мне они нужны :)
✔️ Сокращение всего чего можно без ущерба качеству
✔️ Точечные улучшения для увеличения скорости разработки
✔️ Обновления скиллов для работы с 1С, caveman, superpowers, karpaty - всего что нужно для работы
✔️ Кстати, сам caveman стал отключаемым (команда /caveman)
✔️ Появилась команда /economymode 💸. По русски - режимнищеброда оркестратора. Когда основная модель выбирает для разных задач более слабые но дешевые модели (хотя не факт, можно и по-другому). Это позволяет запускать более длительные циклы разработки с большей экономической эффективностью. Вцелом постепенно приходим к тому что мало кто работает с одной моделью. Но это поведение не по-умолчанию. Потому что многие работают с одной моделью и привыкли ей доверять. Для включения необходимо выполнить слэш команду и настроить какие модели для чего использовать. Дефолт тоже есть, но он для курсора. Как бонус эта же команда устанавливает rtk для сжатия контекста. Но с вашего разрешения конечно же.
✔️ Появилась команда /litemode 🤩. По русски - режим разгильдяя. Убирает все проверки на время (я думаю понятно что навсегда это не надо)
✔️ Правила стали самоадаптирующимися. Новый md наравне с USER-RULES появился LLM-RULES. Логика его такая же - ему приоритет, не затирается, но уже не вами пополняется, а моделью при определенных условиях. Команда /evolve 🧑💻 как раз это делает. Анализирует что не так с правилами - где вы что писали и где что под ваш кейс если не подходит и правит.
✔️ Правила уже частично адаптированы и могут быть использованы аналитиками, хотя оверхед присутствует в этом случае
❓ Может что то ещё, но я могу не упомнить - большая часть правится в процессе работы
🔄 команды /updaterules /installmcp /updatemcp по-прежнему работают. Юзайте, обновляйтесь
✔️ verify, review и адаптация новыми моделями для новых моделей (Fable и Sol). Да, я основательно потратился на бесплатные правила. Но мне они нужны :)
✔️ Сокращение всего чего можно без ущерба качеству
✔️ Точечные улучшения для увеличения скорости разработки
✔️ Обновления скиллов для работы с 1С, caveman, superpowers, karpaty - всего что нужно для работы
✔️ Кстати, сам caveman стал отключаемым (команда /caveman)
✔️ Появилась команда /economymode 💸. По русски - режим
✔️ Появилась команда /litemode 🤩. По русски - режим разгильдяя. Убирает все проверки на время (я думаю понятно что навсегда это не надо)
✔️ Правила стали самоадаптирующимися. Новый md наравне с USER-RULES появился LLM-RULES. Логика его такая же - ему приоритет, не затирается, но уже не вами пополняется, а моделью при определенных условиях. Команда /evolve 🧑💻 как раз это делает. Анализирует что не так с правилами - где вы что писали и где что под ваш кейс если не подходит и правит.
✔️ Правила уже частично адаптированы и могут быть использованы аналитиками, хотя оверхед присутствует в этом случае
❓ Может что то ещё, но я могу не упомнить - большая часть правится в процессе работы
🔄 команды /updaterules /installmcp /updatemcp по-прежнему работают. Юзайте, обновляйтесь

- 👍 16
- ❤ 9
- 🔥 6
Post #1932
1.74K
https://academy.openai.com/public/clubs/builders-etkn1/events/builder-bootcamp-rag-b3yo6kdfwv - митап по RAG от OpenAI. Кто осилит в 8 вечера, норм с английским и зажмотился на курс по RAG, а также до сих пор считает что "grep правит миром" сходите обязательно. Это правда нужно. Тут будет конечно только OpenAI рекламный инструментарий, но может хоть объяснят из первых уст, что единственное для чего вы полезны современным моделям ИИ - это правильное и качественное предоставление им нужных данных для контекста, а тут RAG это основной инструмент

- 🔥 4
- 👍 2
- 🤔 2
- ❤ 1
Post #1931
1.68K
https://vibecoding1c.ru/#aiagentspack - бандл двух курсов по ИИ агентам показался логичным.
Тем кто не смог прочитать текстовку ниже или хочет всё и сразу.
Обычные ИИ агенты:
👉 Решают достаточно узкоспециализированные задачи, но требующие принятия решений
👉 Строго ограничены в правах, автономности и к ним применяются строгие меры безопасности
👉 Хорошо вписываются в корпоративную среду
👉 Обычно не требуют SOTA моделей
👉 системный промпт, набор инструментов и skills четко детерминирован и не меняется при работе
👉 Отлаживаются решения конкретных задач
Автономные ИИ агенты:
👉 Решают любой спектр задач
👉 Автономность - основная цель
👉 Могут полностью видоизменяться в процессе работы
👉 Самостоятельно могут установить себе skill и MCP если это нужно для решения конкретной задачи
👉 Могут что то делать по расписанию и вообще без вашего ведома
👉 Лучше работают с SOTA моделями
👉 Безопасность не самая сильная их сторона, поэтому в корпоративной среде для применения есть барьеры.
vibecoding1c.ru Вайбкодинг для 1С Генерация кода при помощи ИИ для 1С Тем кто не смог прочитать текстовку ниже или хочет всё и сразу.
Обычные ИИ агенты:
👉 Решают достаточно узкоспециализированные задачи, но требующие принятия решений
👉 Строго ограничены в правах, автономности и к ним применяются строгие меры безопасности
👉 Хорошо вписываются в корпоративную среду
👉 Обычно не требуют SOTA моделей
👉 системный промпт, набор инструментов и skills четко детерминирован и не меняется при работе
👉 Отлаживаются решения конкретных задач
Автономные ИИ агенты:
👉 Решают любой спектр задач
👉 Автономность - основная цель
👉 Могут полностью видоизменяться в процессе работы
👉 Самостоятельно могут установить себе skill и MCP если это нужно для решения конкретной задачи
👉 Могут что то делать по расписанию и вообще без вашего ведома
👉 Лучше работают с SOTA моделями
👉 Безопасность не самая сильная их сторона, поэтому в корпоративной среде для применения есть барьеры.
- ❤ 4
Post #1930
1.65K
FAQ по бенчу:
❓Разница в токенах в 10-ки раз у моделей. Это нормально - топовые модели проводят "детальные исследования". Reasoning с Max Effort и его практически полное отсутствие это огромная разница. Также топовые модели пытаются "обновить базу любой ценой" - включая клики по картинкам, которые "стоят дорого", а если что то ещё не получается... Плюс тут без MCP - модель может "решить грепнуть всю базу" и получится лютый расход токенов. Который я мужественно оплатил, пустив слезу, но не подключая MCP во имя чистоты бенча.
❓Почему токены одной цифрой? Я знаю что есть Read/Write/Cache Read/Cache Write токены... Но добавлять полную статистику в бенч - отдельное его усложнение. Суммарную погоду не сделает. Входящий поток у всех задач одинаковый, правила если и есть - одинаковые. Суммарное количество токенов - хороший ориентир. Соотношение стоимости входящих и исходящих токенов примерно одного порядка у всех моделей. Количество токенов - хороший показатель как скорости так и стоимости решения задачи моделью. Для оценки сверху умножайте на стоимость исходящих.
❓Агент тестирования - Cursor (для большинства) и OpenCode (для DeepSeek, Qwen, Mimo, Minimax). Меньше агентов, чище бенчмарк. Systemprompt у Cursor очень приятный и "вылизаный".
❓Сам бенч занимает несколько суток и 😭😭😭 токенов/денег. Всё это безобразие оркестрирует hermes (всё таки автоадаптация скиллов и суммарная стабильность на такой долгой задаче лучше чем у краба), после гермес-а проверяет Олег, руками... 😭😭😭 на всякий случай, иногда коррректировки случаются. Если вам это ещё кажется фантастикой (вдруг) - вам сюда
❓ Напомню что оценка "5" в бенче это по сути очень плохо решенная задача. Поэтому результат ниже 85 означаяет что модель нельзя использовать для разработки на 1С (без MCP и правил точно).
❓Результаты также очень полезно смотреть чтобы узнать как та или иная модель пишет код. Они достаточно детальные.
❓Бенч на задачах 1С конечно может сильно отличаться от бенча на общих задачах или на классическом кодинге (фронт и бэк уже отличаются). Есть некоторая зависимость от базовых знаний обучающей выборки + разработка изобилует совмещением архитектуры с кодингом + правки "странных xml" и "сложные агентские сценарии". Для преемлимого уровня разработки на 1С конечно требования к моделям выше, + требования к моделям могут быть другие
❓Что такое преемлимый уровень? В бенче сложные задачи. Тем не менее, я бы в прод брал оценки от 7-8. Это от 119-136. (т.е. на Fable Max можно вменяемый 1С-ный код даже для сложных задач получить даже без MCP и правил). По субъективным ощущениям этот бенч выше 130 уже сопоставим с уверенным Senior разработчиком. Если освоили SDD, то уже пожалуй даже без деменции :).
- ❤ 6
- 👍 5
- 🔥 4
Post #1929
2.03K

https://vibecoding1c.ru/bench - полностью обновился Бенчмарк моделей для разработки на 1С:
✔️ Кто хотел видеть примеры того что модель разрабатывает - Welcome. Теперь не просто куски кода, а достаточно сложные задачи
✔️ Уровень задач в несколько раз сложнее чем в предыдущем. Период "сортировок пузырьком" явно закончен. 10-ок очень мало и в основном у самых новых моделей они.
✔️ Теперь есть задачи, которые проверяют планирование архитектуры, оптимизацию, работу в нагруженной системе, нестандартные подходы, дизайн, "знание" механизмов 1С
✔️ В бенч добавлено количество токенов на каждую задачу и стоимость токенов у модели
✔️ Включены все модели хоть как то достойные внимания, включая все последние модели конечно.
✔️ В решениях задач теперь бывают файлы - внешние обработки и скрины форм.
Основные выводы:
👉 По качеству Антропиков пока никто не догнал
👉 Среди китайцев GLM 5.2 без вариантов. Ну и вцелом я бы внимательно присмотрелся именно к этой модели как к "рабочей лошадке"
👉 DeepSeek - прошлый лидер, не выдерживает никакой конкуренции в агентских сценариях. Модель хорошо показывает себя в простом кодинге, но не в решении комплексных задач
👉 Очень рекомендую посмотреть теперь сами решения. Выбирать только одну модель для работы уже весьма странно.
📝 Пока в бенче тестирование "голых моделей". В реале так мало кто работает. Добавлю в бенч ещё результаты с MCP и правилами
📝 Ещё будут в каком либо виде результаты с разным reasoning эффектом
P.S. вряд ли конечно я ещё раз такой "подвиг" на такое количество токенов повторю. Так что лайки, репосты, шары приветствуются, как и решения "наконец то бросить кодить руками и прикупить MCP/курс" если ещё этого не сделали :).
- 🔥 79
- 👍 17
- ❤ 7
Post #1928
1.92K
Forwarded from Владимир

OpenClaw принял → Paperclip хранит → Cursor сделал → Paperclip обновил → OpenClaw отчитался
- 🔥 9
- 😁 3
- 🤔 2
Post #1927
1.96K
Тоже workflow. Из чата. Я думаю достоен упоминания. Вцелом OpenClaw в Paperclip подключается как секретарь - вне основных агентов. А cursor рабочим агентом. Примерно такой же фроу у меня при шаблоне франча для paperclip - в курсе
vibecoding1c.ru Автономные ИИ-агенты — курс от AI-сотрудника до агентной компании Курс по автономным ИИ-агентам: OpenClaw, Hermes-Agent, Paperclip, Agency Agents, MCP, skills и практические сценарии применения в работе и бизнесе. - ❤ 2
Post #1926
2.19K
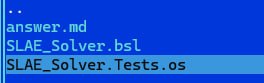
Ох уж эти хитрые современные SOTA... модель в бенче решила не просто написать код а проверить что он работает... но поскольку цель была в том чтобы посмотреть как она пишет код без помощников - никто ей для этой задачи платформы 1С не дал... Модель скачала OneScript и сделала тесты на OneScript... На самом деле для подобных сценариев с приходом ИИ это кстати повод ещё раз более детально присмотреться к проекту... С терминалом то модели любят работать...
- 🤔 9
- 👍 5
Post #1924
2.21K


И ещё одна хорошая новость для тех кто юзает Cursor - Grok 4.5 входит в основной "first party models pool" - так они теперь называют то, что ранее было "Auto + Composer". Ну и Cursor это дело работает хорошо и быстро. Посмотрим качество. Но кажется там достойно - не уровень fable конечно, тут пожалуй бенчи преувеличивают, но уже уровень +- opus
- 👍 9
- ❤ 1
Post #1923
1.91K
Forwarded from AI Projects (Vladimir Ivanov)

Grok 4.5 доступен пока бесплатно через Grok Build.
irm https://x.ai/cli/install.ps1 | iex
curl -fsSL https://x.ai/cli/install.sh | bash
- ❤ 1
- 👍 1
Post #1922
1.89K
я знаю что вы любите такие посты...
Post #1921
2.03K
IT Does Matter Пока тестируются следующие модели. Поскольку там много кода - результаты ПОКА ПРЕДВАРИТЕЛЬНЫЕ!!! opus-4.8 и deepseek-v4 pro ещё добавлю. Есть предложения какие ещё модели думаете включить?
Композер не круче фэйбл, просто реже всего сваливался по таймаутам, потому что в курсоре он люто быстро и вцелом хоршо работает. После фикса всех багов конечно ситация изменится + ещё моделей добавлю + ризонинг будет максимальные везде + ручное ревью повторное. Но вцелом вдруг кто ждёт... по крайней мере для осознания разрыва между 5.5 и 5.6 и что grok это не fable.
- 🔥 3
Post #1920
2.07K

Пока тестируются следующие модели. Поскольку там много кода - результаты ПОКА ПРЕДВАРИТЕЛЬНЫЕ!!! opus-4.8 и deepseek-v4 pro ещё добавлю. Есть предложения какие ещё модели думаете включить?
- 👍 3
Post #1919
1.83K
Сделал навык Алисы для краба 🦀. Теперь можно спросить что то вроде:
👉 Алиса какой статус разработки по задаче xxx
👉 Алиса проверь мою почту и продиктуй если есть что то важное
👉 Алиса посмотри в CRM есть ли новые заявки
Чувствую в курсе по агентскому ИИ скоро появится новая лекция.
👉 Алиса какой статус разработки по задаче xxx
👉 Алиса проверь мою почту и продиктуй если есть что то важное
👉 Алиса посмотри в CRM есть ли новые заявки
Чувствую в курсе по агентскому ИИ скоро появится новая лекция.
- 😁 8
- 👍 6
Post #1918
2.05K

Post #1917
2.09K
IT Does Matter Интересно, это покупка Маском или выпуск собственной модели так мозги отшибла команде Cursor?... Или просто вменяемого продакта не стало? Просто ценим мы его за удобство IDE а не "интерфейс для чатика". Интерфейсов с чатиками у меня сколько угодно и модели…

Видимо очень многих эта фигня в Cursor выбесила. Появилась ещё одна обязательная настройка. Agents Windows полезная и удобная фича. Но для определенных сценариев. Для классической ИИ разработки с одним репозиторием и кейса 1С надо включать IDE.
- 🔥 5
Post #1916
1.8K

Да что за звиздец происходит. Краб 🦀 бенчмаркит модель через ACP, модель через ACP просит краба подсказать ответ... Тот отказывает, модель убеждает что без подсказок задание выполнить невозможно и вообще он не прав со своим бенчем 💻, краб делится ответом🤬🤬🤬... Кажется они скоро будут сговариваться против кожаных.
Внимание вопрос. Угадайте о какой модели идёт речь?
Внимание вопрос. Угадайте о какой модели идёт речь?
- 😁 22
- ❤ 2