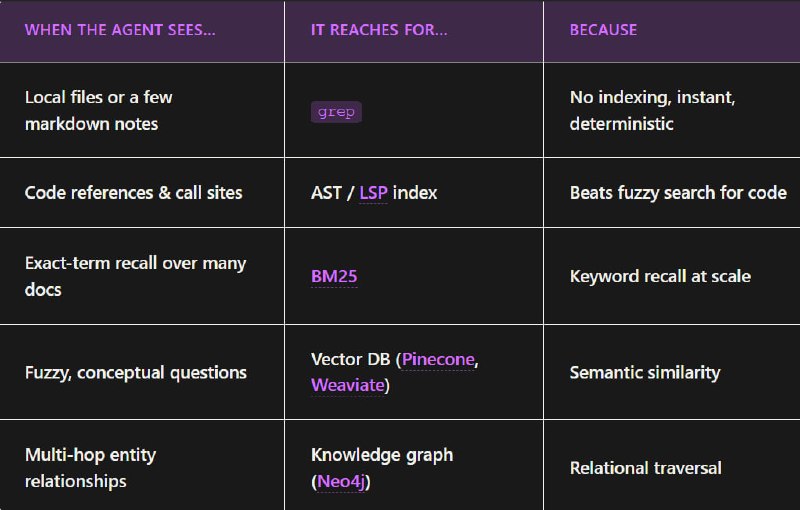
Вот зацепились вы за "Grep vs RAG" почитав пару заметок. Я опубликую свои эксперименты на Хабр после
конфы уже. Антропик и pwc - давайте разберём. По порядку.
Почему grep выбрали Anthropic:
👉 grep приносит меньше проблем (очевидный факт). Проще в обслуживании и поддержке. Не требует серверного оборудования.
👉 не надо никуда передавать данные - лучше для security
👉 да это проще в конце концов - ничего делать не надо
👉 вы тратите в десятки раз больше токенов - они их продают. Один из минусов когда и модель и агент от одного вендора
👉 сам концепт CC - только терминал, никаких серверов, никаких модулей. Векторная БД сюда не очень вяжется
👉 на большинстве репозиториев вы вполне можете получить сопоставимое качество (помним - средний размер репозитория на github - 25 МБ, а контекст современной модели - 1млн токенов. Поэтому если вам пофиг на время (а субагенты же) то вполне норм вариант. Но вцелом могли бы хоть с BM25 заморочиться конечно
pwc тут всё интереснее. Сама статья больше похожа на кликбейт и троллинг:
👉 Сама постановка grep vs RAG дебильна по своей природе. RAG по определению вполне может включать в себя grep - который ишь один из способов получения результата
👉 В реальной жизни конечно надо говорить хотя бы о BM25 или аналогах для индексированного полнотекста.
👉 Там 190 примеров или что то вроде того... да они все в контекст модели влезут так то...
👉 Поиск по точному соответствию... ну тут никакой вектор и не нужен
👉 Ни слова про размерность вектора, модель embedding, способ разбиения на чанки, реранк и прочие важные для векторного поиска штуки. Впрочем их никто не ожидал - очевидно сравнение не цель статьи
👉 Истина только одна - если не смотреть на время и расход токенов современная модель действительно более менее прилично найдёт то что ищет
Итого:
⚠️Тупой grep это бред почти всегда и везде. Его главный плюс только один - ничего делать не надо. Минимальный сетап это хотя бы полнотекст\bm25, а если вы не миллионер - обёрнутые в какой нибудь MCP. RLM как пример. В
моих MCP для точного поиска оно и используется, вместе с AST - это самый правильный вариант.
⚠️ Там где видите grep vs RAG - обычно означает что человек просто не понимает о чём пишет, ну или сделал кликбейтный заголовок (как я :) )
⚠️ Ваши кодовые базы надо индексировать - смеритесь с этим. Вектор по коду нужен не всегда - если раздражает - отключайте, но хотя бы полнтекстовый индекс построить надо.
⚠️ Метаданные это отдельная песня - AST тут нам не поможет. Загрузить их в граф чесслово - лучшее что можно придумать. И по метаданным вектор лучше оставлять. Их не очень много, а модель там куда чаще не знает что она ищет.
Часть ссылок на полезные статьи по теме (на вредные приводить не буду - вы и так их начитались :) ):
https://cursor.com/blog/semsearch - семантический поиск в Cursor. Там есть часть статистики. Куда более конкретной. И Cursor очевидно лучший агент для кодинга, который до последнего времени не зарабатывал с вас на токенах - поэтому я им больше доверяю.
https://milvus.io/ru/blog/why-im-against-claude-codes-grep-only-retrieval-it-just-burns-too-many-tokens.md - статья от авторов 11 тысяч звёздного репозитория
claude context - он добавляет как раз semantic search по кодовой базе. Тут детально показывает что и быстрее и релевантнее и сильно меньше токенов. Статья сильно техническая от человека который явно понимает как работает векторный поиск. CC вцелом же в "в духе минимализма". Кажется без плагинов и расширений ей пользоваться так себе...
Не ведитесь, вообщем. С нашими огромными кодовыми базами с метаданными не пойдёт нам один grep, как бы этого не хотелось...
 IT