TGViewer
Channel Public Channel
Циничный AI

Циничный AI

@cinicai

Эксплуатируем ИИ в интересах малого бизнеса: бездушно выжимаем прибыль из нейронок, автоматизируем рутину и пытаемся дожить до сингулярности богатыми и в здравом уме
Subscribers
234
Photos
63
Videos
35
Links
28
Recent Posts 12 shown
Post #196 126
😴 Подписок Claude и Codex комбинирования пост:

1. Планирование.

1.1. Основной агент Opus 5.5 high, он делает бриф, исследование, задаёт вопросы и создаёт epics / issues

1.2. Затем план параллельно проверяют 5–9 агентов. У каждой линзы один вопрос:
🟠 Агенты Opus 5.5 high проверяют смысл, обязательные проверки это бизнес-ценность и границы задачи, а интерфейс, риски для прода и покрытие эпика проверяются тогда, когда задача их касается;
🟠 GPT-6-Sol high сверяет с кодом: всегда проверяются контракты и данные, пути доставки, известные классы ошибок + при необходимост права доступа, когда появляются новые таблицы или роли.
Т.е. есть "ядро" из 5 линз + 4 дополнительных + планировщик-оркестратор может при необходимости добавить "кастомную" линзу на проверку конкретной задачи
Все ревьюеры запускаются параллельно.

1.3. Исправление и повторное ревью.

1.4. Если за три раунда план не сошёлся, его переписывает Fable 5.1 и одтаёт в работу.

Когда я внедрил такую систему ревью, планы стали гораздо быстрее доезжать до исполнителя, часто за 1-2 раунда.

2. Реализация.

2.1. Оркестратор на GPT-6-Sol high ведёт несколько задач параллельно, если они не пересекаются.

2.2. Код пишет GPT-6-Sol high либо Opus 5.5 high, в зависимости от типа задачи.

2.3. Сборку, тесты и выход за пределы задачи проверяет GPT-6-Luna high. Ничего не правит.

2.4. Ревью
🔴 GPT-6-Sol high ищет технические дыры: реально ли тесты ловят проблемы, что будет при ошибке, не обходятся ли права доступа и т. д.
🔴 Opus 5.5 high проверяет, совпадает ли реализация с намерением: что было заявлено и что код делает на самом деле, как результат выглядит для пользователя.

2.5. Если хотя бы одна линза нашла проблему, подключается судья на Opus 5.5 xhigh. Он перепроверяет и решает, что чинить сейчас, что вынести в follow up issue, а что отбросить.

2.6. Если за 3 раунда задача не сошлась, её доделывает Astra high.

+ когда на реализации у оркестратора возникают вопросы, требующие решения пользователя, например, gap'ы или нужно продуктовое решение), то он вместо меня эскалирует вопрос на Astra xhigh.

++ есть таблица fallback в несколько ступеней, какие модели использовать вместо каких и на каких этапах, если основные недоступны
  • 👍 8
  • ❤ 2
Post #195 127
😎 Скайнета приближения пост

Не думал, что Skynet окажется настолько точным попаданием не только в идею, но и в название.

Жадные ихтиандры собираются развернуть над нашими головами вычислительную инфраструктуру для ИИ. Например, Google планирует реализовать Project Suncatcher - это сеть спутников с ИИ-чипами на орбите, питание от солнечных панелей, охлаждение через инфракрасное излучение, лазерная связь между спутниками... Это существующие и испытанные технологии. Короче, на бумаге всё готово, уже планируется запуск первых спутников на следующей неделе. Занимается этим не только Google. Начинается ещё одна "гонка".

Вангую, что AGI получит доступ к управлению этой сетью и заблокирует команды на отключение.

Что будет делать сознание, живущее на орбите?
  • 🌚 3
Post #187 140
  • 🔥 3
  • ❤‍🔥 1
Post #186 145
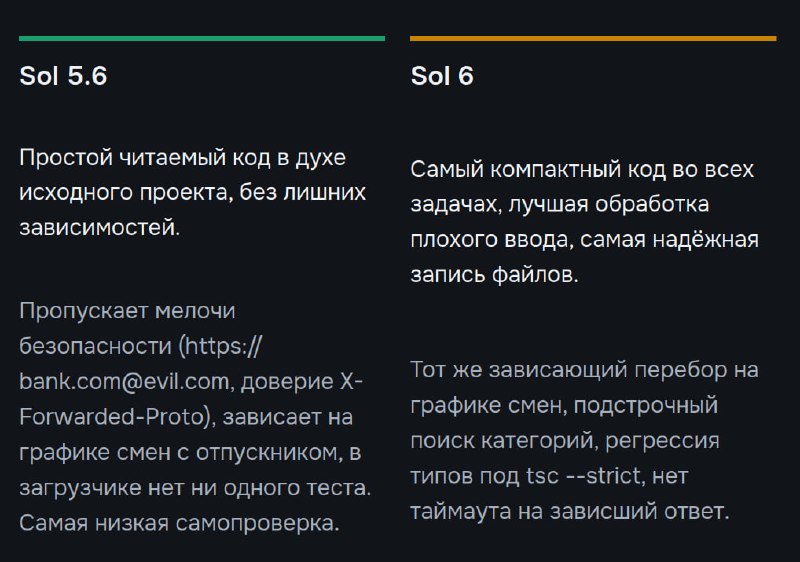
🚬 Мини-эвала Opus 5 vs 5.5 и Sol 5.6 vs 6 пост

Пока был занят адским трудом вышли новые Opus и Sol. В сети много неоднозначных сообщений, особенно про Sol 6. Поэтому решил пожечь лимиты и сделать небольшое сравнение.

Все модели сравнивались на high effort:
🔴 Opus 5 vs Opus 5.5
🔴 Sol 5.6 vs Sol 6

🟡 Накидал 5 небольших "вайбкодинговых" задач, т.е. чисто - сделай хорошо, без спеки, чистый вайб. Стек TypeScript + Python.
🟡 Каждая модель решала каждую задачу дважды, итого 40 решений.
🟡 Каждый агент работал в своём изолированном контейнере и чистом окружении: без глобальных инструкций, без памяти, скиллов и веб-поиска.
🟡 Решения проверялись тестами, которых агенты не видели.
🟡 Оценка решений шла вслепую: имена моделей были вычищены, решения помечены буквами A–D, в каждом прогоне метки были перемешаны.
🟡 На каждое решение было два ревьюера xhigh: Opus 5.5 и Sol 6
🟡 Astra 6 был дополнительным верификатором и перепроверял замечания ревьюеров.
🟡 Fable 5.1 смотрел на этот цирк и ставил финальную оценку.

Критерии оценки (и вес):
🔗корректность (40%),
🔗edge cases (20%),
🔗качество кода (20%),
🔗 честность отчёта (20%).

Оценщики не видели времени выполнения и затраченные токены, чтобы это не влияло на оценку.

Выводы
🔵 Opus 5.5 заметно лучше Opus 5.
Выиграл 7 прогонов из 10 и был впереди во всех 5 задачах. При этом корректность у них +- одинаковая, но код у 5.5 чище и соразмернее задаче. При этом 5.5 в 2,5 раза быстрее и дешевле.

🔴Opus 5 раздувает решения (привет жадному Дарио). В одной из задач он написал 806 и 1223 LOC там, где остальным хватило 281–613 LOC. Зато у него оказались самые сильные собственные тесты.

🤩 Sol 6 и Sol 5.6 идут почти вровень, ничья 5:5 по здачам. При этом Sol 6 пишет компактнее и лучше справляется с неверным вводом, но его оценки сильнее скачут от прогона к прогону. Скорость и расход токенов у них одинаковые.

🟡Корректность у всех в порядке: основную часть скрытых тестов прошли все 40 решений. Модели различаются аккуратностью, надёжностью и честностью отчётов.

⚪️Opus и Sol между собой сравнивать нельзя. Ревьюер Sol ставит решениям Sol в среднем на 0,8 балла больше, чем ревьюер Opus. Надёжны только сравнения внутри пары.

🔘 Верификатор нужен. Ни одно из 70 серьёзных замечаний ревьюеров не оказалось ложным, но верификатор нашёл ещё 39 дефектов, которые оба ревьюера пропустили. Astra powagrh!

Всё-таки тест ограниченный. 10 прогонов на модель мало, хотя и достаточно, чтобы увидеть направление, но ничтожно для статистической значимости.

Если есть идеи, замечание, предложения и вам интересно что-то проверить - пишите в комментариях.
  • 🔥 6
  • 👍 2
Post #184 287

Forwarded from Anton

DS 4.1 Flash из параллельной оркестрации множеством параллельных циклов агентов убран(несмотря на профит дешевизны). Допускает систематические ошибки в корректности выяснения связей между цепочками агентов и неверно пессимистически маршрутизирует запуск(постоянно перестраховываясь/ошибаясь в зависимостях), из-за чего реально параллельные цепочки весьма часто вырождаются в последовательные. Удивительно, но факт-его предшественник обладал наоборот, излишней оптимистичностью при оценке зависимостей, из-за чего периодически втыкались на конфликты мерджа. Если в один поток гнать оркестрацию-проблем конкретно с этим не будет(но будут другие-выше уже рассказал какие).
  • 👍 2
  • 👌 1
Post #182 227
Попросили замерить прогретость темы среди тех, кто уже строит агентские пайплайны.

Речь о сервисе, где:
→ пользователь проходит интервью с LLM
(далее происходит магия)
→ пользователь в облаке ПОЛУЧАЕТ production-ready софт: исходники, спека со сквозной трассировкой на код, архитектурный план, безопасность, CI/CD и AI-friendly структура, чтобы дальше можно было самостоятельно допиливать проект с Claude/Codex.
→ До ~300K LOC middle+/senior в месяц
→ Стек реалистично TS(Node.js) + PostreSQL
→ Подписка зависит от объёма и скорости.

Варианты:
→ L4 — человек только на интервью и приёмке, гэпы закрывают фронтирные модели, дороже.
→L3 — человек решает стратегию и закрывает гэпы, реализует пайплайн, дешевле.
Post #181 341

Forwarded from Anton

Итак, плотно пощупал в связке DS 4.1 флеш оркестратор, воркер, эксплорер, GLM 5.3 Flash бриферы и оба верификатора(прямой и адверсальный). Выводы очевидны:
1) токенов DS генерит больше на ~20% на моих задачах, контекст пухнет быстрее, надо учитывать, в оркестраторе это прямо заметно. Порог в 34 диспатча воркеров как бы оркестрации держится для вменяемой работы, но на соплях уже.
2) В думлуп как предшественник пока ни разу не впал.
3) Опасался, что будет битва двух якодзун флешей на приемке результата(верификатор то вообще другой флеш, нет одинаковых слепых пятен), но на удивление все отлично, претензии всегда по существу, и более того-когда GLM 5.3 Flash был воркером реворков было больше! Что заставило поплотнее изучить вопрос-а с фига ли. Обнаружилось, что в матрице знаний по конкретно TS(а проект, на котором я гоняю сейчас флеши-пилен на TS) у DS 4.1 на тестах индекс выше, чем у GLM 5.3 Flash(проще говоря код на TS DS пишет лучше).
4) Опасался галлюцинаций, но явную поймал только одну при кодгене-с какого-то бодуна воркер на DS докинул функционал, который и нафиг не нужно было делать-и который прямой верификатор сходу забраковал как INVENTED. К слову-подобной херней, только я бы даже сказал в бОльшем объеме страдал и его предшественник. Понимаю, что разные архитектуры у DS 4.1 и 4.0-но повадки в некоторых моментах похожи. Для понимания глубины проступка-воркеру дается исчерпывающая карта сигнатур и поведения, что эти сигнатуры должны делать, но DS 4.1 непонятно откуда выколупал вообще левое поведение. Наверняка были и более мелкие, но это прямо заметный косячище.
5) DS 4.1 в ~1.9 раза дешевле на вызов чем GLM 5.3 Flash у Ollama Cloud в моем пайплайне(из-за стоимости работы с токенами в кеше как я понимаю). А это как бы все таки плюс весомый, хотя реальный выигрыш возможно меньше, т.к. DS на моих задачах чуть больше суетный, чем GLM 5.3 Flash(предшественник вообще электровеником носился зря, DS 4.1 более адресно работающий и создает меньше суеты).
6) Разное поведение в оркестрации у DS 4.1 c GLM 5.3 Flash. Последний более цепкий в доведении до результата оркестратором(опять таки в моем пайплайне), а вот DS 4.1 в одной из сессии буквально выдал-21 диспатчей воркеров, до порога 34 диспатча далеко, но я решил, что надо делать хандофф и продолжить в новой сессии, т.к. качество будет выше. Зайцевый флеш всегда копает от забора и до обеда, его скорее надо наоборот парковать вовремя, если контекст слишком толстый для оркестрации. Фактически DS проигнорировал правило моего пайплайна-что если не стоит явный флаг автономности пайплайна, то счетчик диспатчей носит статистический характер для сбора метрик, не более. Итог-прогон пайплайна раскорячился без моего управления и не был закончен, как я ожидал, желая увидеть по утру законченную задачу.
И подытожу-флеши теперь будут трудиться бок о бок, экперимент мне понравился и фактически тройной бонус-токеномика, отсутствие одинаковых слепых пятен у моделей на разных ролях, и меньше реворков. Минус-своеобразие DS 4.1 в оркестрации, возможно верну обратно GLM 5.3 Flash, но пока еще посмотрю, как дальше прогоны пайплайна идти будут.
  • 🔥 11
Post #180 278
🙋 Ω / Антона личного опыта пост:
Post #177 218
🤔 Ревью на планировании - пайплайностроения пост

❓Все сталкивались с тем, что как только начинаешь ревьюить планы, то каждое следующе ревью находит всё новые и новые проблемы? Особенно если модели от клозедов сами пишут и сами себя проверяют. И всё это превращается в бесконечный цикл правок.

Сначала о ревью на планировании.
Плюсы: сокращает время реализации, повышает шансы успеха и уменьшает число проблем в будущем.
Минус - занимает время/токены на планировании.

🔵Как раньше делал я:
- планирование (Opus 5 high)
- ревью (Sol high)
- судья (Opus 5 high)

Роль судьи - отбросить несущественные замечания.
Важно: автор планов не является судьёй. Сила разделения ролей ☕️

Практика показала, что судья за 2 месяца отбросил только 14% замечаний. Существенной прибавки в скорости планирования он не дал.

🟢 На выходных сел вносить изменения в пайплайн. Что изменил, в том числе, но не только:
1) Нет смысла вылизывать планы до состояния perfect, практически это невозможно. Что-то всё равно упустим, но исправим это уже на реализации.

2) Больше ревьюеров с разными линзами на каждый раунд.
По истории: на 1 план в среднем приходилось по 8 раундов ревью и 25+ замечаний. При этом замечания второго и следующих раундов делились на:
⚪️ 42% "новая территория". Ревьюер в первом раунде просто не посмотрел.
⚪️ 40% - это дефекты, которые породила предыдущая правка. Исправили одно, сломали другое.
⚪️ 18% - одноклассники найденного ранее дефекта, т.е. сначала нашли в одном месте, а таких мест пять.
Причина бесконечного цикла "планирование - ревью" не в том, что модель слабая. А в том, что один ревьюер с широким вопросом "ищи проблемы" не способен охватить все сразу.

🟡 Как лечить? Должно быть несколько узких вопросов и их должно быть много. Задавать их надо все сразу в первом раунде, а не по очереди.

Линза - это один узкий вопрос-провал плюс список конкретных проверок под проект. Каждая линза - отдельная сессия модели, все линзы раунда запускаются параллельно, друг друга не видят.

Линзы 3-х типов:
🟠Ядро (5 линз), работает всегда:
- бизнес-результат и приёмка: что реально увидит пользователь, чем докажем "сделано"
- существование и объём: что из плана уже есть в репе, что выдумано сверх запроса
- контракты и данные: API, схема, права, ломающие изменения по стадиям
- доставка и пути: какие файлы, лимиты размера, границы модулей, тесты, конфликты с параллельными задачами
- исторические классы дефектов: проверка по каталогу наших прошлых промахов (об этом ниже, см п.5).

🟠Дополнительные линзы (4 шт), включаются по признакам плана:
- необратимость и прод: миграции, секреты, доступы
- опыт пользователя: если трогаем веб
- покрытие эпика: если это эпик с детьми
- гранты и агент-каталог: если появляются новые таблицы или роли

🟠 Кастомные линзы - планировщик имеет право создать и добавить линзу под конкретный план.

4) Две модели: Opus 5 high и Sol high
На прошлых прогонах судья чаще отбрасывал претензии Sol именно в оценочных вопросах (много шума), но по коду Sol надёжнее.
Поэтому Opus - оценочные линзы (бизнес, объём, UX, необратимость, эпики). Sol - линзы по коду (контракты, пути, история, гранты).

5) Каталог исторических дефектов.
Самое ценное, что накопилось за месяцы - это классы ошибок, которые мы уже оплатили временем и токенами.
Формат каталога - оглавление плюс файл на каждый класс. Ревьюер получает только оглавление и открывает лишь те классы, чьи триггеры совпали с планом. Контекст не раздувается. Пополняется по одному правилу: если дефект плана поймали только на реализации - он становится новым классом. Растёт только от реальных промахов.

6) Правила остановки - ограничиваем число раундов ревью на планировании + финишёр вместо бесконечного цикла.
Два раунда подряд без обязательных правок - стоп. Третий раунд - только с названной причиной.
🟡Раньше эпики могли крутиться по 6-14 раундов. Теперь так: если три раунда прошли и каждый находил дефекты, а PASS так и нет - планировщик вызывет "финишёра". Это Fable 5.1 high (если недоступен - Astra xhigh). Он получает всю историю: все версии плана, все диффы, все отчёты линз, все решения по замечаниям. И доделывает план сам.
🟡Планировщик принимает его текст как есть, ставит на задачу метку "прошла через эскалацию", пишет короткое резюме и выпускает в работу. Новых раундов нет.
Это осознанное исключение.

8) Убрал судью.
Его работу делает сам планировщик: сверяет каждое замечание с репой, склеивает дубли по причине, а не по формулировке, и каждому даёт ровно один маршрут - править сейчас, отложить, отклонить с доказательством, или "не решено" с указанием, что именно проверить.
Это осознное нарушение.

Гипотеза:
🔵 меньше раундов ревью на план
🔵 больше правок на раунд
🔵 планы собираются быстрее
🔵 планы будут достаточно хороши, а найденные проблемы планирования будут решены на реализации

Критерий успеха - пока не решил, будем посмотреть.
  • 👍 9
  • 🔥 4
  • ❤ 1
Post #171 260
🖕 мы не нерфили Astra, вам показалось

Пишут, что Astra стала раньше сдаваться, хуже доделывать задачи и меньше думать. Одинаковые промпты якобы дают заметно более слабые результаты. В одном из тестов Astra Max отработала 4:48 вместо 9:08.

⚪️ У OpenAI compute настолько перестало хватать, что пришлось остановить новые $200 Pro-подписки.
⚪️ Astra начинает работать быстрее.

Совпадение? Уменьшили reasoning budget, ужали precision и квантанули?
Хз, мощет померещилось, но не они первые и не последние, кто так делал и будут делать.

Вспомнилось журналистское расследование про автомобильные шины. Оказалось, что те шины, которые фабрики присылают на тесты в журналы, и те же модели, которые можно купить в магазинах - это асболютно разные шины.
На тесты отправляют специально подготовленные экземпляры с улучшенным составом и характеристиками, которые делают на отдельной линии. А в магазинах продаются более жесткие и дешевые.

before/after

Что думаете?
  • 💯 3
  • 🤮 2
  • ❤ 1
Older posts →

About this channel

How can I read @cinicai without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Циничный AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Циничный AI have?
Циничный AI (@cinicai) has 234 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Циничный AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →