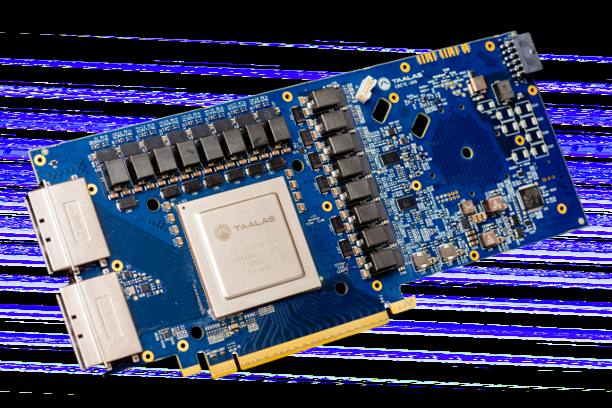
AI-чипы под одну модель: очень круто, но с нюансом
⠀
Taalas сделали необычную штуку: вместо универсального GPU они фактически "запекают" конкретную модель в чип.
⠀
Что заявляют:
• до 17 000 токенов/с на Llama 3.1 8B
• до 20 раз дешевле в производстве
• до 10 раз ниже энергопотребление
⠀
Почему это важно:
• для стабильных задач (саппорт, колл-центры, on-prem) это может очень сильно снизить цену инференса
• меньше задержка, быстрее ответы, проще масштабировать
⠀
Где ограничение:
рынок моделей сейчас меняется очень быстро.
За одну неделю могут выйти новые версии топовых моделей (Opus 4.6 / Sonnet 4.6 / Gemini 3.1), а железо, собранное под конкретную модель уже не переделаешь.
⠀
Что это значит на практике:
Taalas это не замена всем чипам Nvidia.
Это сильный инструмент для сценариев, где модель фиксированная и ключевыe метрики — скорость и цена. Но не для передовых универсальных моделей, которые выходят каждый день.
⠀
Анонс • Демо
Post #8218
1.84K