TGViewer
Channel Public Channel
ChatBLZN

ChatBLZN

@chatblzn

هوشِ مصنوعیِ جهان،
به زبانِ خودت
Subscribers
181
Photos
22
Videos
6
Links
25

Showing posts older than #13 · Back to latest

Older Posts 11 shown
Post #12 3.16K
🔥 و بالاخره بعد از چند روز انتظار...

غول جدید Z.ai — GLM 3.5 هم‌اکنون در هوشواره‌ی افق آبی در دسترس شماست.

⚡️ سریع، قدرتمند و آماده‌ی چالش‌های جدی
💳 با پرداخت امن ریالی

همین حالا امتحانش کنید:
chatblzn.com
  • ❤ 4
Post #11 325
راهنمای عملی Qwen3.8-27B: عمق استدلال را کنترل کنید و زمینه را تا 1 میلیون توکن گسترش دهید

‏reasoning_effort — عمق استدلال را بر اساس هر درخواست، کم یا زیاد کنید.

زمینه فوق‌العاده طولانی — 262 هزار توکن به صورت بومی، قابل گسترش تا 1 میلیون با YaRN.

‏1. reasoning_effort: کنترل عمق استدلال بر اساس هر درخواست

‏xhigh (پیش‌فرض): برای کارهای پیچیده‌ای که نیاز به تحلیل کامل دارند.

‏medium: برای ایجاد تعادل بین دقت و سرعت.

‏low: برای استدلال کارآمد که سرعت و هزینه را در اولویت قرار می‌دهد.

2. پردازش زمینه‌های فوق‌العاده طولانی: 262 هزار بومی، تا 1 میلیون با YaRN

فریم‌ورک‌های متن‌باز YaRN ایستا را پیاده‌سازی می‌کنند — عامل مقیاس‌گذاری بدون توجه به طول ورودی ثابت می‌ماند، که می‌تواند عملکرد را در متون کوتاه‌تر کاهش دهد. YaRN را فقط زمانی فعال کنید که واقعاً به زمینه‌های طولانی نیاز دارید.

عامل را با طول زمینه معمول خود تنظیم کنید. اگر حجم کاری شما معمولاً حدود 524,288 توکن است، عامل را به جای 4.0 روی 2.0 تنظیم کنید.

آن را به روش خود مستقر کنید

vLLM: https://recipes.vllm.ai/Qwen/Qwen3.8-27B

SGLang: https://docs.sglang.io/cookbook/autoregressive/Qwen/Qwen3.8-27B

TokenSpeed: https://lightseek.org/tokenspeed/recipes/models#qwen3-8

Unsloth: https://unsloth.ai/docs/models/qwen3.8

— Qwen Developers
🔗 https://x.com/QwenDevs/status/2088289608031510811
recipes.vllm.ai Qwen3.8-27B on vLLM — Serve command for GB300 NVL4, RTX 5090, RTX 5090, RTX Pro 6000, DGX Spark (GB10), Ascend 950PR 27B-parameter dense hybrid-attention model with linear attention on 48 of 64 layers, a vision tower, a built-in MTP draft head, 262K native context window and extensible to 1M context
  • ❤ 4
Post #10 203
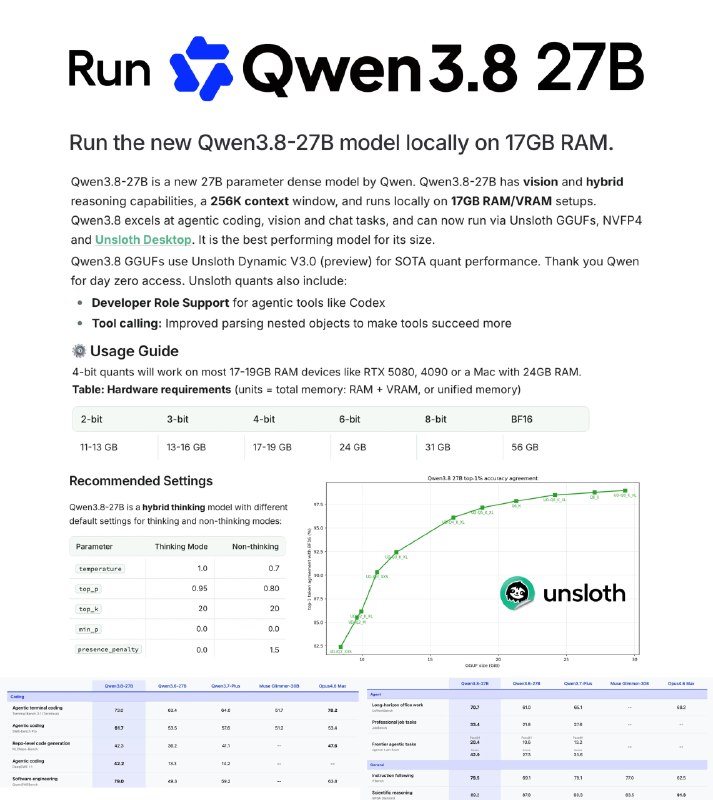
‏Qwen3.8-27B اکنون می‌تواند به صورت محلی اجرا شود! 🚀

با استفاده از Unsloth Dynamic GGUFs روی ۱۷ گیگابایت رم اجرا کنید.

‏Qwen3.8-27B تا کنون قوی‌ترین مدل در اندازه خود است. ما همچنین کوانت‌های NVFP4 را آپلود کردیم.

GGUF: https://huggingface.co/unsloth/Qwen3.8-27B-GGUF…
راهنما: https://unsloth.ai/docs/models/qwen3.8…

— Unsloth AI
🔗 https://x.com/UnslothAI/status/2088281537427235320?s=20
  • ❤ 3
Post #9 194
  • ❤ 2
Post #8 231
ما قول وزن‌های باز برای Qwen3.8 را داده بودیم. حالا وقت ملاقات با آن‌هاست! 🚀

🌟 Qwen3.8-27B:
- یک مدل چندوجهی بومی متراکم. با تنها 27 میلیارد پارامتر، در مجموع از Qwen3.7-Plus بهتر عمل می‌کند و در کارهای واقعی کدنویسی و اداری می‌درخشد.
- 262 هزار زمینه بومی، که به راحتی از طریق YaRN تا 1 میلیون توکن قابل گسترش است.
- برای توسعه‌دهندگان ساخته شده است. بسیار کارآمد، با کیفیت بالا و تحت مجوز Apache 2.0.

✨ وزن‌های باز برای Qwen3.8-2.4T-A95B (سطح حداکثر) نیز اخیراً منتشر شده‌اند.

چه در حال ارسال برنامه‌های سبک با Qwen3.8-27B به صورت محلی باشید و چه در حال ساخت عامل‌ها با Qwen3.8-2.4T-A95B، اکنون آن‌ها مال شما هستند!

دانلود کنید، مستقر کنید و چیزی بسازید که هنوز تصورش را نکرده‌ایم. ⬇️🛠💡
- Hugging Face:
https://huggingface.co/collections/Qwen/qwen38…
- ModelScope:
https://modelscope.cn/collections/Qwen/Qwen38…

— Qwen
🔗 https://x.com/Alibaba_Qwen/status/2088280182356611304?s=20
huggingface.co Qwen3.8 - a Qwen Collection We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 🔥 1
Post #7 903
یک خبر فوق العاده برای رقابت بین غولها...

⚡️ Qwen3.8-27B

وزنهای مدل 27 میلیاردی Qwen 3.8 که هم قدرت Qwen 3.7 Pro هست منتشر شد و از هم اکنون بر روی سیستم‌های لوکال قابل اجرا است.

chatblzn.com
  • ❤ 2
Post #1
Channel created
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →