TGViewer
Channel Public Channel
Клуб CDO

Клуб CDO

@cdo_club

Сообщество профессионалов в области работы с данными, искуственным интеллектом и разработкой сложных ИТ систем.

Поделиться контентом: @shaman_sw
Поддержка канала и сообщества:
Subscribers
4.09K
Photos
758
Videos
44
Links
2K
Recent Posts 14 shown
Post #3078 298
  • 👍 5
  • ❤ 1
Post #3077 329

Forwarded from VTORNIK.Company

Роберт Солоу в 1987 году остроумно сформулировал парадок производительности:

You can see the computer age everywhere but in the productivity statistics.


Суть парадокса: технология может быть повсюду и при этом почти не отражаться в статистике производительности. Причина — не в самой технологии, а в том, что вокруг нее еще не перестроились инфраструктура, институты и организации. Весь свежий доклад McKinsey, по сути, — это объяснение, почему такой разрыв возникает и как его читать в случае ИИ.

Общие технологии (пар, электричество, интернет, теперь ИИ) не преображают экономику фактом изобретения. Нужны сопутствующие инновации, инфраструктура, правила, капитал и готовность людей менять способ работы — а эти части приходят не одновременно. Электричеству понадобилось физически перестроить заводы вокруг электромотора; интернету — построить сети, затем создать новые бизнес-модели, затем реорганизовать компании. Пик влияния на рост ВВП: пар — ~100 лет, электричество — ~40, компьютеры и интернет — ~25.

Центральная идея доклада — части системы движутся с несопоставимой скоростью:
• Возможности моделей растут экспоненциально (сложность задач удваивается ~каждые 4 месяца с 2023 г.).
• Физическая инфраструктура строится линейно, годами.
• Перестройка организаций идёт ещё медленнее и неравномерно.

Парадокс углубляется тем, что управление и безопасность отстают от внедрения: только ~30% организаций достигли зрелого уровня AI-управления, треть не проверяет системы на безопасность перед запуском, ответственность размыта между IT, юристами, HR и риском. А крупный сбой (кибератака или провал управления) способен вызвать откат и ужесточение регулирования, что затормозит отдачу ещё сильнее.

Подробнее читать в источнике: The AI economy: Interconnected forces, feedback loops, and speeds of change
September 10, 2026 | Discussion Paper
McKinsey & Company The AI economy: Interconnected forces, feedback loops, and speeds of change A systems view of the AI economy shows how capabilities, companies, infrastructure, and society advance at different speeds and shape one another through feedback loops.
  • 👍 3
  • 🔥 1
Post #3076 547

Forwarded from Реймер | AI Трансформация Бизнеса

GPT-6 Astra, привет!

1990-е - раз в неделю ты идешь через весь город к маме на работу, потому что у нее в отделе есть 1 компьютер и в перерыв ты играешь в Prince of Persia. в другие дни играют другие дети...

2026 - GPT-6 сделай клон Prince of Persia

html файл с игрой в комментарии - можно скачать

P.S. а Anthropic сбросили лимиты. привет Fable 5.1
  • 💯 3
  • 🔥 2
Post #3075 536
Наконец то кто то использовал LLM для реально полезных вещей :)

PS сейчас как раз читаю книгу Prince of Persia - дневник автора оригинальной игры, так что прям в тему этот html :)
  • 👍 3
  • 🔥 1
Post #3074 569
А если вы приехали на мероприятие выше и думаете как провести вечер - очень рекомендую вот эту лекцию, если там есть еще билеты.

Редакция идет туда сегодня :)

https://unionchapel.org.uk/whats-on/carlo-rovelli-lessons-on-physics-and-philosophy
unionchapel.org.uk Union Chapel Union Chapel is a church, live entertainment venue and charity drop-in centre for the homeless in Islington, London, England. Built in the late 19th century in the Gothic revival style, the church is Grade I-listed. It is at the top end of Upper Street, near…
  • 🔥 2
Post #3073 569
Коллеги, некоторые из участников канала сегодня так же будут на BigDataLND

Редакция сегодня пропустит день, но если вы хотите встретится с коллегами и друг с другом - используйте комментарии к этому посту что бы дать об этом знать!

https://www.bigdataldn.com/en-gb.html
Bigdataldn Big Data LDN | London Olympia
  • 👍 3
Post #3066 692
Сегодня всей редакцией традиционно побывали на Big Data LDN.

По ощущениям, в этом году стендов и людей было меньше. Хотя, возможно, просто выдалась хорошая погода и все выбрали другие занятия :) Так же традиционно вендоры снова переобулись: теперь основная часть контента не про агентов, а про контекст, семантический слой и онтологии.

Индустрия нащупала новую нишу между LLM и корпоративными данными, и все устремились туда со своих текущих позиций. Об этом говорили и BI-вендоры, и дата-платформы, и те, кто раньше делал каталоги данных.

И проблема действительно реальная: как эффективно соединить корпоративные данные с LLM, пока не знает никто, и подходов столько же, сколько вендоров. Удалось послушать пару интересных докладов - расскажу о них позже.

А пока оставлю к посту слайд от Atlan. Кажется, нашей аудитории его даже не нужно пояснять, а многим он пригодится для собственных презентаций :)

А ещё мы встретились с участниками канала, которые тоже заехали на мероприятие. Должен сказать: аудитория у нас - настоящие профессионалы, и это очень круто!
  • 👍 8
  • 💯 7
Post #3064 638
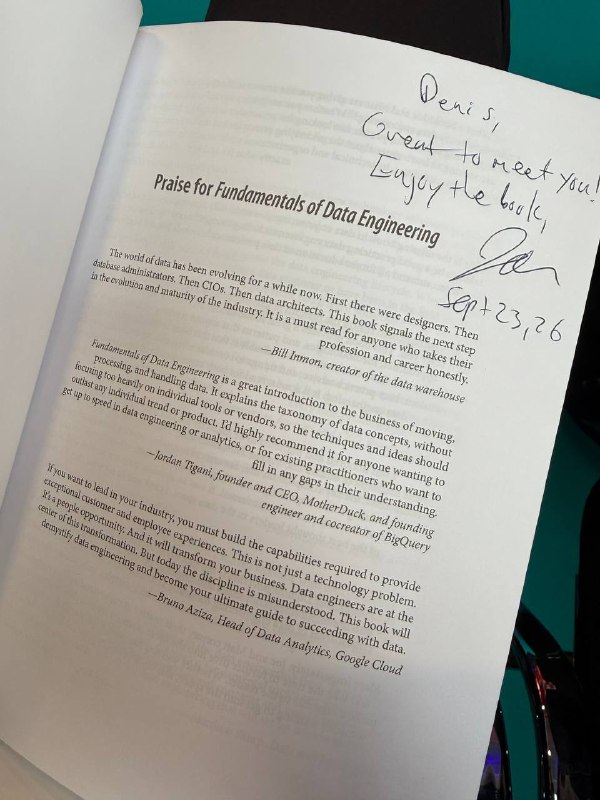
Всем привет от Joe Rais, автора этой замечательной книги
  • 👍 18
  • 🔥 11
Post #3063 652

Forwarded from C++ Academy

«Я про бэкенд»: как устроены AI-системы под капотом бигтеха

🗓 3 октября, Москва и онлайн

О чём: как разработчики высоконагруженных рекомендательных и генеративных систем справляются с нетривиальными вызовами. Доклады в 6 направлениях — от архитектуры систем с AI/ML до MLOps и работы на стыке бэкенда с железом.

Часть спикеров:
🎤 Михаил Цветков (Алиса AI и Умные устройства) — как устроен инференс генеративных ответов Алисы в Поиске
🎤 Алина Шестакова (Positive Technologies, Cloud SIEM) — вердикт за минуту: ML-фильтр и LLM на потоке более 40 тысяч событий в секунду
🎤 Андрей Аксёнов (Авито) — база векторных баз
🎤 Егор Хайруллин (Рекламные технологии Яндекса) — как распределённо обрабатывать более 100 ГБ/с в реальном времени без потерь и дублей с помощью YTsaurus Flow
🎤 Владислав Тюльбашев (Яндекс) — как надежно раздавать конфиги на 200к хостов при отказе [n-1] ДЦ
🎤 Алексей Логинов (Алиса AI и Умные устройства) — как сделать агентную платформу надёжной

Кроме того, зрителей ждет традиционный лайв, где бэкенд-инженеры Яндекса спроектируют архитектуру сложного сервиса в реальном времени. В этот раз задачу для эфира можете задать вы: участвуйте в проекте «2718», отправляйте свои кейсы, а организаторы выберут среди них самый сложный для открытого разбора.

Полная программа и регистрация
я про бэкенд я про бэкенд — Конференция про вызовы бэкенд-разработки в эпоху роста нагрузки и развития AI
Post #3062 629

Forwarded from Stas Karamushko

💡Пройти исследование и узнать свой Индекс доверия к данным

Мы много говорим про Data Governance, качество данных, каталоги, архитектуру, AI и data-driven управление.

Но между наличием данных и решением есть ещё один слой — доверие.

Поэтому в исследовании «Управление данными в России 2026» мы решили измерять не только практики управления данными, но и то, насколько данные действительно помогают организациям принимать решения, координировать действия и проводить трансформацию.

В этом году исследование проходит онлайн.

Каждый участник добавляет свой профессиональный контекст в общую «ткань доверия»: отрасль, регион, роль и собственный взгляд на то, как работают данные в организации.

Уже представлены 9 регионов и 10 отраслей. Чем шире выборка, тем интереснее становится сравнивать не отдельные компании, а разные профессиональные среды.

И здесь есть две причины участвовать.

1. Для себя:
пройти диагностику и узнать свой Индекс доверия к данным.

2. Для рынка:
добавить ещё одну точку в общую картину того, как сегодня устроено доверие к данным в российских организациях.

Мне особенно интересны различия между ролями: одинаково ли воспринимают данные CDO, руководители бизнеса, архитекторы, аналитики и консультанты?
Ответ появится только тогда, когда будет достаточно разных голосов.

автор методики - Станислав Карамушко

👉 Пройти исследование и узнать свой Индекс доверия: https://datatrustmaker.ru

⏱Исследование открыто до 31 октября 2026.

Данные сами по себе ещё не создают решения. Между данными и действием всегда есть доверие.

#DataTrustMaker #УправлениеДанными #DataGovernance #DataTrust
  • 👍 3
Post #3061 1.4K
Интересный сдвиг происходит в data-стеке. Мы сейчас начали делать ассистентов, которые работают с BI и данными, и наглядно видно, что для того, чтобы они были эффективными и полезными, надо создавать отдельный онтологический слой, который будет показывать не только какие поля что означают, но и отражать связи между сущностями, процессами и смыслом. По сути это задача по превращению знаний, которые раньше были в голове у людей и объединялись с отчётами при их прочтении, в вербализированные артефакты.

Вот попалась сегодня в рассылке неплохая статья, которая более детально раскрывает эту проблематику, а заодно даёт информацию, чем на самом деле занимается Palantir :)

Тезисы такие:

- Новый вид ценности - бизнес-логика, определения метрик и рабочие процессы компании не должны арендовать место в проприетарной облачной базе вендора. Это ваша ключевая интеллектуальная собственность, и она должна быть суверенным активом.
- Новый вид мета-семантики: агенту для рассуждений нужны и математика метрик, и контекст связей между сущностями.
- Переход от статичного описания к динамически развивающейся системе. Важно не просто создать хорошо работающее решение, а создать решение, которое будет постоянно расширяться и совершенствоваться. В традиционном BI семантические слои статичны: это схемы, написанные один раз, которые медленно гниют, пока дата-инженер не почистит их вручную.

https://medium.com/@Joannahe/beyond-the-semantic-layer-engineering-the-agentic-data-stack-98fbaee9ad10
  • ❤ 6
  • 👍 3
  • 🔥 2
Post #3060 656

Forwarded from proVenture (проВенчур)

🚀 Сегодня на Product Hunt выходит тул для поиска и аналитики, объединяющих все лучшее от Elastic и ClickHouse

Пока у канала кризис жанра выручают классные фаундеры, которые делают лонч. Хочется верить, что вам интересно читать про них и еще интереснее поддерживать!

Команда SereneDB (ребята из Берлина, в прошлом году подняли $2.1M пре-сид от HTGF и Entourage) сегодня релизит именной релиз "Krummelanke" — первую production-ready версию своей поисково-аналитической СУБД.

👉 Ссылка на лонч на Product Hunt, если вы уже заинтересовались: https://www.producthunt.com/products/serenedb-krummelanke

Подробнее?
Это технический проект на стыке двух индустрий - поиска и аналитики. Поисковые движки, как Elastic, не умеют в тяжёлую аналитику, и аналитические БД, как ClickHouse, не очень-то могут искать. SereneDB сливает full-text/vector search и OLAP-аналитику в один Postgres-совместимый движок — и делает ставку на то, что именно это нужно AI-агентам, которые задают "гибридные" вопросы (найти + посчитать) на машинной скорости.

Из релиза:
▪️ Open source, Apache 2.0, доступны на GitHub
▪️ Сделали альтернативу Lucene/Tantivy, которая работает в разы лучше
▪️ Опережают по производительности Elastic и ClickHouse в открытом бенчмарке на github.com/serenedb/searchbench
▪️ Поиск прямо по данным в S3 (без переноса) — то, чего пока не делал никто
▪️ Так как база Postgres-совместима и есть MCP к документации, можно очень быстро сделать проект на Claude/Codex

❗️Про бонусы за апвоуты, как обычно: open source доступен всем бесплатно, а команда обещает помочь всем, кто поддержит их запуск и назовёт пароль "proVenture". Пишите со-основателю Александру напрямую @malandin или же в админку Telegram-канал @serenedb, который они ведут.

Ребята делают что-то на мировом уровне и их точно не стыдно поддержать!

👉 Еще раз ссылка на лонч: https://www.producthunt.com/products/serenedb-krummelanke

#producthunt
Product Hunt SereneDB: Ultra-Fast Search & Analytics Database, Agentic AI ready | Product Hunt SereneDB is the result of 12 years of development - an open-source database that does ultra-fast full-text and fast analytics in one engine. Postgres- and Elastic-compatible: keep your SQL, your drivers, and your Elastic clients; drop the second system and…
Post #3059 726
куда же без классики
  • 👍 4
Post #3058 816
Дайджест статей

📰 Delta Lake 4.3: Выборочная замена данных и API‑интерфейсы каталога Unity Delta
🔗 https://habr.com/ru/articles/1081750/
💡 Замени replaceWhere на replaceUsing: пустой источник больше не сотрёт партицию.

📰 DATAREON Platform под нагрузкой: настройка высоконагруженной интеграции DATAREON + PostgreSQL + REST
🔗 https://habr.com/ru/companies/w_code/articles/1082460/
💡 Храни is_current явно и раздавай пачки воркерам через FOR UPDATE SKIP LOCKED.

📰 Как хранить данные так, чтобы их можно было успешно анализировать
🔗 https://habr.com/ru/companies/lansoft_career/articles/1082584/
💡 Федерацию бери при многих источниках; стабильные отчёты оставь на OLAP-кубах.

📰 Обычного RAG было недостаточно и мы построили AI-консультанта по архитектуре
🔗 https://habr.com/ru/companies/alfa/articles/1082348/
💡 Связи между системами клади в граф, документы в вектор, выбор отдай роутеру.

📰 Самое сложное в AI: как RAG-пилот на три недели затянулся на три месяца
🔗 https://habr.com/ru/companies/psm_unlim/articles/1083012/
💡 До RAG наведи порядок в версиях документов, иначе автоматизируешь бардак.

📰 Данные построчно правильные, а итог неверный: ошибки JOIN и гранулярности в аналитике
🔗 https://habr.com/ru/companies/otus/articles/1079620/
💡 Агрегируй дочерние таблицы до JOIN, иначе fan-out раздует суммы.

📰 Платформа данных на минималках. Часть 3. Вычислительный движок
🔗 https://habr.com/ru/companies/selectel/articles/1082852/
💡 Выбирай движок по конкурентной нагрузке, а не по одиночным бенчмаркам.

📰 Как выбирать BI-систему под реальные ограничения организации
🔗 https://habr.com/ru/articles/1082098/
💡 Сначала отсей BI по блокирующим ограничениям, в PoC проверь upgrade и restore.

📰 Apache Iceberg: Индиана Джонс и Каталог судьбы в Lakehouse
🔗 https://habr.com/ru/articles/1084334/
💡 Выбирай каталог тщательнее формата: у кого указатель, у того и lock-in.

📰 Agentic Systems and Design Patterns
🔗 https://dzone.com/articles/agentic-systems-design-patterns
💡 Начинай с одного ReAct-агента и лимита итераций; multi-agent - когда окупится.

📰 The Trinity of Modern Data Architecture
🔗 https://dzone.com/articles/trinity-of-modern-data-architecture
💡 Ограничивай агента workflow-гейтами и корми событиями, а не ночным батчем.

📰 Почему внедрение BI не заканчивается публикацией дашборда
🔗 https://habr.com/ru/articles/1082112/
💡 Мониторь не статус job, а данные: строки, свежесть, ключи, контрольные суммы.

📰 Data Governance for the Agentic Era
🔗 https://dzone.com/articles/data-governance-agentic-era
💡 Передавай агенту identity пользователя и логируй промпты и чанки для аудита.

📰 Data mart vs semantic layer when do you need both aedbad
🔗 https://medium.com/@kausik.kb.bhowmik/data-mart-vs-semantic-layer-when-do-you-need-both-ae625db547ad
💡 Пиши контракт метрики (грейн, время, агрегация) до покупки semantic layer.

📰 From Messy Data Models to Agentic Data Catalogs: Building an AI Data Architect with OKF and Gemini
🔗 https://medium.com/google-cloud/from-messy-data-models-to-agentic-data-catalogs-building-an-ai-data-architect-with-okf-and-gemini-75a20caee9ed
💡 Храни метаданные как Markdown в Git - агент пройдёт lineage по ссылкам.
  • 👍 3
Older posts →

About this channel

How can I read @cdo_club without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Клуб CDO: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Клуб CDO have?
Клуб CDO (@cdo_club) has 4.09K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Клуб CDO know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →