Concurrency, Synchronization and Consistency. Пост №2. Узкое место архитектуры Фон Неймана. Эволюция компьютера.
В прошлом посте по верхам прошлись по тому как устроен компьютер который мы все так любим.
В этом посте хочется продолжить экскурс в историю и ретроспективно посмотреть какие попытки предпринимались умельцами, с целлью сделать компьютер быстрым и эффективным.
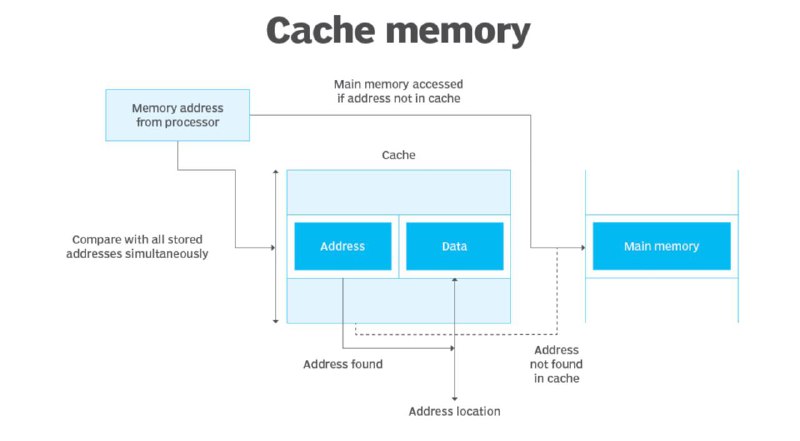
Кэширование. Когда то в процессорах не было собственных кешей. Появились они именно как улучшение ситуации вокруг того самого бутылочного горлышка. Наличие кеша означает что можно реже обращаться ко внешнему устройству и складывать данные и инструкции у себя и обращаться к ним быстрее, так как они рядом.
В типичной конфигурации CPU 3 уровня кэша L1, L2 и L3. Располагаются они между ядром процессора и основной памятью.
- Кэш L1 - маленький и быстрый.
- Кэш L3, который используется несколькими ядрами процессора, - большой и медленный.
- Кэш L2 находится где-то посередине между ними.
Размеры кешей зависят от конкретной железки.
Предварительное извлечение (Prefetch). Инструкции и данные, которые должны быть использованы в первую очередь, заранее помещаются в кэш, чтобы быть доступными сразу же при необходимости.
Спекулятивное выполнение. Программа может выполнить задачу, которая может оказаться ненужной. Работа выполняется до того, как станет известно, действительно ли она необходима, чтобы предотвратить задержку, которая может возникнуть при выполнении работы после того, как станет известно, что она необходима. Если очень по простому - процессору дешевле заранее сделать работу на основе выгруженных из памяти инструкций, чем дойти до условного перехода, прыгать по указателям в памяти и понять что тот кусок кода все равно нужно было исполнить.
Многопоточность. Тут даже комментарии излишни, все мы знаем что это такое🤪
Новые типы оперативной памяти. Текущие разработки в области оперативной памяти обещают помочь решить хотя бы часть проблем, связанных с узкими местами, за счёт ускорения передачи данных на шину.
Near Data Processing. Подход когда вычисления переносятся ближе к данным. Практических применений не встречал, это то что активно ресерсчится сейчас, в том числе чтобы справиться с вызовами роста количества данных во всем мире.
Аппаратное ускорение. Означает перенос обработки данных на другие устройства, чтобы снизить нагрузку на CPU и зависимость от системной шины. Базовый пример реализации подхода - создание GPU как отдельного устройства оптимизированного под вычисления.
Система на кристалле (system-on-a-chip (SoC)). Один кристалл содержит процессор, память и другие системные ресурсы, и как следствие CPU может реже обращаться к системной шине и меньше простаивать в ожидании данных и инструкций делая все самостоятельно. Мобильные устройства и встраиваемые системы широко используют технологию SoC. Cейчас эта технология проникает и в ПК, и царит здесь Apple Silicon.
В общем работа была проведена колоссальная. Кеширование, prefetch, потоки и разные трюки с выполнением так вообще стали тем без чего процессор трудно представить😊.
На этом всё, спасибо что читали, пишите в комментарии, какие оптимизации я мог упустить в своем посте, мб что-то новое связанное с AI прошло мимо меня. И обязательно поставьте реакцию на пост, чтобы мне понимать как откликаются у вас посты😊
Полезные ссылки:
- Latency Numbers Every Programmer Should Know - методичка показывающая как эволюционировала задержка в CPU, RAM, дисках и сети. Полезно посмотреть ретроспективно.
Post #392
2.6K
- 🔥 10
- 👍 7
- ❤ 1
- 👎 1