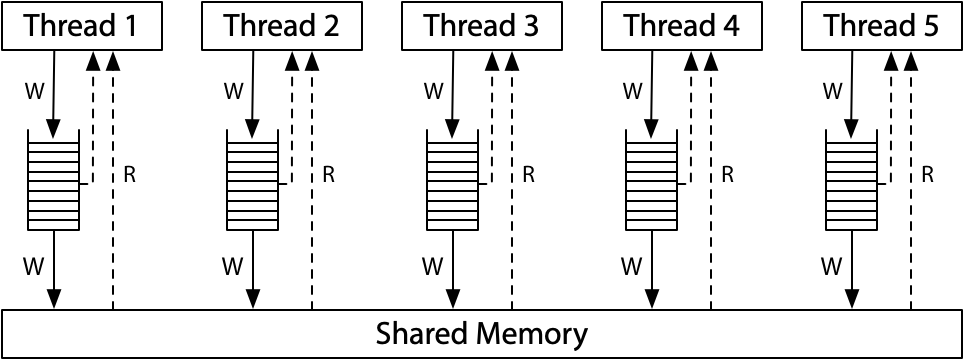
Модель памяти для современных систем x86 соответствует схеме:
Все процессоры по-прежнему подключены к одной общей памяти, но каждое поток/ядро процессора пишет данные в выделенную для него очередь операций. Процессор продолжает выполнять инструкции, пока записи из очереди применяются к общей памяти. Операция чтения памяти на конкретном ядре процессора проверяет локальную очередь записи перед обращением к основной памяти, но не может читать данные из очередей на других ядрах. В результате процессор видит свои записи раньше, чем другие. Но — и это очень важно — все процессоры согласовывают (общий) порядок, в котором операции записи (сохранения) достигают общей памяти, что дает модели название: общий порядок сохранения, или TSO. В тот момент, когда запись достигает общей памяти, любое будущее чтение на любом процессоре увидит ее и будет использовать это значение (пока оно не будет перезаписано более поздней записью или, возможно, буферизованной записью из другого процессора).
Очередь записи представляет собой стандартную очередь «первым вошел — первым обслужен»: записи в память применяются к общей памяти в том же порядке, в котором они выполнялись процессором.
Давайте разберемся на примере кода:
#include <pthread.h>
#include <stdio.h>
#include <stdlib.h>

// gcc pthreads.c
// while true; do ./a.out; done

volatile int x, y, r1, r2;

void* f1(void* vargp)
{
    x = 1;
    r1 = y;
    return NULL;
}

void* f2(void* vargp)
{
    y = 1;
    r2 = x;
    return NULL;
}

int main()
{
    pthread_t t1, t2;
    pthread_create(&t1, NULL, f1, NULL);
    pthread_create(&t2, NULL, f2, NULL);

    pthread_join(t1, NULL);
    pthread_join(t2, NULL);

    printf("r1 = %d, r2 = %d\n", r1, r2);

    return 0;
}
Какие выходные значения в теории могут быть?
- 1, 0
- 0, 1
- 1, 1
- 0, 0
Если бы наше устройство поддерживало описанную ранее модель Sequential Consistency то мы бы увидели в выводе программы первые три варианта. Вариант №4 недоступен в силу строгости модели.
Но мы запускаем программу на модели X86-TSO. И программа время от времени помимо первых 3х вариантов может выдать два нуля как результат.
Почему? Операции записи попадают в буфер перед тем как попасть в общую память, и при параллелизме (у каждого потока свое ядро процессора и буфер) потоки не увидят измененных значений и вычитают из общей памяти нули.
Неочевидно - да. Быстро ли работает подобная модель - да. Именно такая модель используется в большинстве процессоров. Наличие дополнительных фишечек и оптимизаций зависит от поколения процессоров и производителя.
На этом всё, завтра будет пост про модель ARM. Очень хочу до НГ закрыть перед вами долги и как минимум завершить рассмотрение аппратной части связанной с конкурентностью. Благо осталось не так много.
Спасибо что читали, поддержка в любом виде приветствуется😇