
SpecEdit: Training-Free Acceleration for Diffusion based Image Editing via Semantic Locking
[код пока нет, обещают]
Работа про ускорение диффузионного редактирования изображений без дообучения. Не новая модель, а надстройка над уже существующими редакторами вроде Qwen-Image-Edit и FLUX.1-Kontext.
Проблема
При редактировании не все области картинки одинакого важны. Не важные регионы можно сначала редактированть в низком разрешении, а потом апсемплить. При этом, стандартные методы динамического разрешения обычно решают, какие токены апсемплить, по низкоуровневым признакам: границам, дисперсии каналов и т.п., что работает плохо.
Метод
Авторы вдохновляются LLM спек деком и делают пайплайн:
1. Сначала запускают дешёвое редактирование в сильно пониженном разрешении (16х downsampling).
2. Сравнивают фичи драфта с исходным изображением.
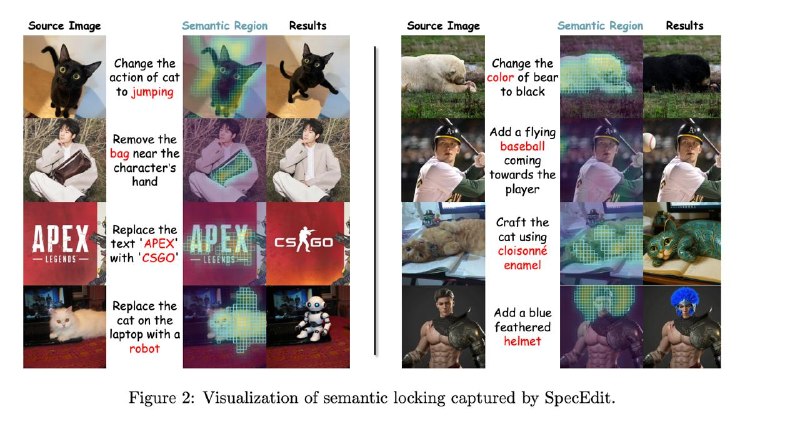
3. Находят токены, где возникло семантическое изменение.
4. Только эти токены поднимают в высокое разрешение для дальнейшего денойзинга.
5. Остальные области оставляют в низком разрешении, плюс добавляют разреженную равномерную сетку токенов для глобальной стабильности.
Это они называют semantic locking: не просто “сэкономить токены”, а зафиксировать именно те области, где правка должна/не должна произойти. Драфт при этом не участвует в финальной траектории денойзинга, он нужен только как дешёвый способ понять, где нужно сделать изменение.
Результаты:
• Qwen-Image-Edit: 3–6х при близком качестве.
• FLUX.1-Kontext-dev: до 7× ускорения.
• В комбинации с дистилляцией по шагам — до 13×.
• На GEdit-Bench и ImgEdit-Bench качество в целом держится, хотя на самых агрессивных режимах ожидаемо проседают сложные категории вроде замены и стилизации.
В целом, идея работы логичная: давайте найдем регион для изменения и будем работать только с ним. Для редактирования это важнее, чем для обычной генерации, потому что часто бОльшая часть изображения должна остаться неизменной.
Ограничения тоже понятные. Метод сильно зависит от качества драфт: если дешёвый проход неправильно понял инструкцию, фичи будут шумными. В статье нет отдельного раздела с failure cases, но по аблейшенам видно, что результаты могут быть не стабильными.
Post #298
708
- ❤ 6
- 🔥 1