[код есть]
В генерации изображений обычно платишь за пиксели: больше разрешение - больше токенов - больше FLOPS. Сами DiT обрабатывают все токены одинаково, будь то детальная текстура шерсти или просто белый фон. Это неэффективно. Авторы из Rice University и Snap представляют ELIT (Elastic Latent Interface Transformer) — метод, который отвязывает вычислительный бюджет от разрешения картинки и позволяет управлять соотношением качество/скорость.
Идея и метод: Latent Interface
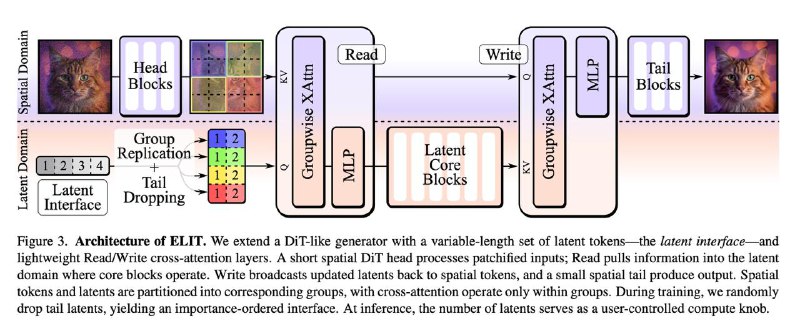
Вместо того чтобы прогонять все пространственные токены через стек DiT блоков, ELIT вводит промежуточный Latent Interface — набор латентных токенов (количество которых K можно менять).
Архитектура
• Short Spatial Head: несколько начальных слоев DiT обрабатывают исходные патчи (spatial tokens).
• Read Layer: слой cross-attention, который засасывает информацию из пространственных токенов в компактный набор латентных токенов (
K). Это ключевой момент перераспределения вычислений: attention сам решает, на какие регионы изображения потратить бюджет латентных токенов.• Latent Core: основной стек трансформерных блоков работает уже в этом сжатом латентном пространстве.
• Write Layer & Tail: обратный cross-attention проецирует обновленные латенты обратно в пространственную сетку для финального декодирования.
Обучение
Чтобы модель работала с любым количеством токенов
J <= K, во время обучения случайно выбирается J, и все токены после J-го отбрасываются. Это заставляет модель упорядочивать информацию по важности: первые токены несут глобальную структуру, последующие — детали.На инференсе можно просто выбрать желаемое число J латентных токенов. Хотите быстро? Возьмите мало токенов. Хотите качественно? Возьмите все.Результаты
ELIT превосходит стандартные DiT, U-ViT и HDiT по соотношению FLOPS/Quality. На ImageNet-512 модель ELIT-DiT-XL улучшает FID на 53% по сравнению с DiT-XL при том же бюджете обучения. Одни и те же веса работают в широком спектре бюджетов инференса. Это дает лучший trade-off, чем просто уменьшение числа шагов сэмплинга.
Поскольку модель может работать в слабом режиме (мало токенов), это открывает возможность для дешевого guidance. Вместо того чтобы прогонять полноценную unconditional модель, можно прогнать ту же модель, но с урезанным числом токенов (скажем, 25%). Это дает эффект Autoguidance, ускоряя генерацию на ~33% и улучшая качество.
Применение к Qwen-Image: Авторы масштабировали метод на 20B MM-DiT (Qwen-Image) и показали, что ELIT позволяет ускорить его в 2.7 раза с минимальной потерей качества, просто урезая число токенов.