
Усреднение весов моделей улучшает качество
Статья с ICML 2022 с супер понятным названием:
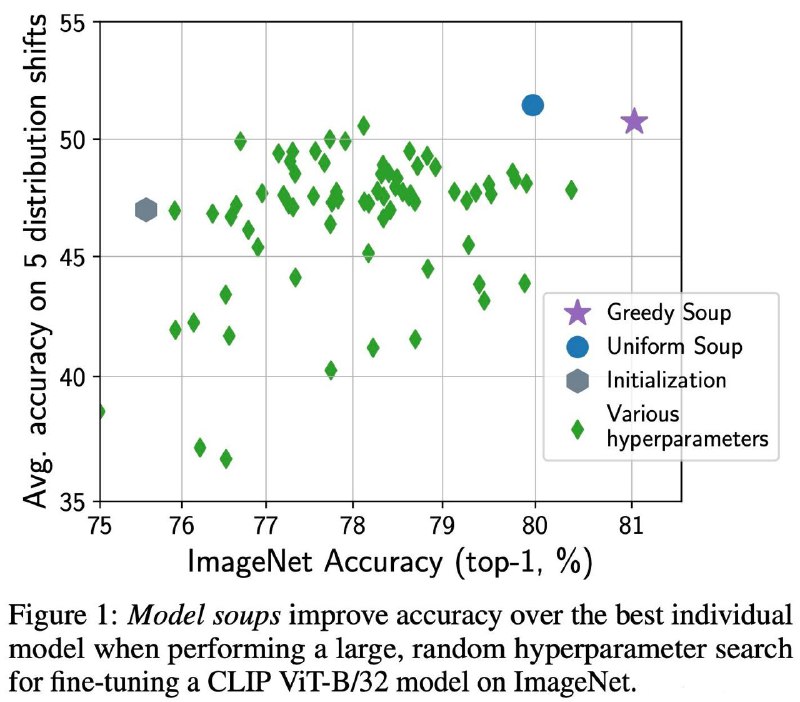
"Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time".
Всё, как и написано: усреднили веса, получили профит.
Усреднять лучше не все имеющиеся модели (uniform soup), а только те, которые добавляют качество на валидации, причем пытаться добавлять сначала те, которые имеют лучшее качество (greedy soup). Метрики на тесте выходят лучше, чем у отдельно взятых моделей, а работает так же быстро. Обучать дополнительно ничего не надо, так как все делают hyperparameter search.
Качество, кстати, получается хуже, чем у ансамбля, но ансамбль и инферить в k раз дольше; а тут одна модель.
Post #12
416
- ❤ 1
- 🔥 1