
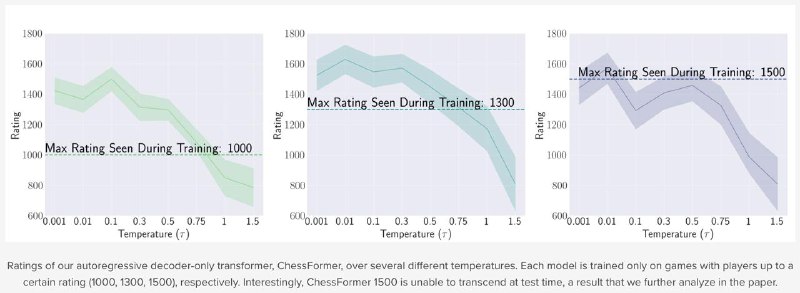
Классный пример того, как модель может превзойти качество данных, на которых она обучалась.
Статья с пафосным названием Transcendence: Generative Models Can Outperform The Experts That Train Them.
В чем суть?
Взяли LLM и дообучили на шахматных партиях в формате
1.e4 e5 2.Nf3 Nc6 3.Bb5 ... 1/2-1/2. Было 3 датасета: партии игроков до 1000 рейтинга, до 1300, и до 1500.И оказалось, что с температурой ближе к нулю (ближе к жадной генерации), LLM играет на рейтинг выше, чем в обучающем датасете (рисунок 1 - графики для 3 датасетов).
Но есть нюанс, что такой скачок происходит только на датасетах до 1000 и до 1300.
Можете подумать, почему такое происходит. Ниже их объяснение.
Разнообразие в датасете. Игрок на 1500 + случайные ошибки ~= игрок на 1300. Поэтому, дообучаясь на победных ходах + разнообразных ошибках, LLM научилась больший вес давать правильному ответу. И при жадной генерации мы всегда выбираем именно этот ход.
Пример. Если мы усредним игрока, который выбирает в 40% верный ход А и в 60% неверные ходы B, и игрока, который выбирает в 40% верный ход А и в 60% неверные ходы C, то получим 40% на верный ход и по 30% на неверные. Что при 0-ой температуре даст строго верный ход.
Блогпост с картинками, формулами, кодом, датасетом, моделями.
@building_singularity