TGViewer
Channel Public Channel
Гречневые мысли

Гречневые мысли

@buckwheat_thoughts

Хочу гречку с молоком и сахаром...

Автор: @chameleon_lizard
Subscribers
1.77K
Photos
205
Videos
4
Links
164
Recent Posts 16 shown
Post #378 758
Сигнал получен, цель видна, отправляюсь за тортиком
  • 🥰 23
  • 😁 4
  • ❤ 3
  • ❤‍🔥 1
  • 🐳 1
Post #377 1.81K
Ураураураура!

Вы спрашивали, вы ругались, вы просили, вы недоумевали — а мы делали гигачат с ризонингом.

В этом релизе мы полностью пересобрали пайплайн обучения. Если раньше был "классический" дорльный пайп с претрейном -> двумя стадиями сфт -> дпо -> онлайн рл, то сейчас мы сделали как и все модные лабы типа MAI, DeepSeek и так далее, разумеется, со своими приколами. Мы взяли тот же самый претрейн, что и 3.5 Instant, потом заварили один большой общий колдстарт — сфт датасет с ризонингом, являющийся базой для RL — затем сделали доменных экспертов на математику, код, болталку и прочие области, а потом через on-policy дистилляцию сделали единую модель-генералиста. И это заработало!

Не обошлось и без курьёзов — модель на RL в какой-то момент смогла своими действиями уронить обучение, пыталась обойти защиту бенчмарков, подключаясь к интернету через тор (?!) и вообще всячески безалаберничала. Но мы всё равно её любим и ценим, так что всё прощается.

В этом релизе я со своей командой ещё плотнее занялся добавлением новых метрик, а так же скоростью и эффективностью замеров. Усилия, вложенные в это, окупились — благодаря нашей магии время замера основных бенчей снизилось с 35 часов до примерно 8, появились более сложные бенчмарки, результаты которых показывали командам данных и рл что нам надо в модели улучшать, да и в целом, головной боли из-за замеров стало значительно меньше.

По метрикам GigaChat 3.5 Reasoning приблизился к DeepSeek V4 Flash. Учитывая, что модель пишет аж на 37% меньше токенов во время ризонинга и в целом, супербыстрая (три MTP-головы!), выглядит круто! Ну а если и вы вдруг хотите тоже делать так, чтобы получалось круто, тратить миллионы долларов на эксперименты и иметь реальное влияние на ОЧЕНЬ большой и проект, то приходите к нам работать. У нас тут сложно. Но весело.

Длиннющий хабропост со всей мякоткой
Веса
Потыкаться (выберите режим "рассуждение")
  • ❤ 43
  • 🔥 23
  • 👏 7
  • 💩 3
  • 👍 2
  • ❤‍🔥 1
  • 🥰 1
  • 🤡 1
  • 🤣 1
Post #376 1.61K
Гречневые мысли Итак, выводы — способна ли локальная модель заменить подписку за 20, 100 или 200 баксов? Конечно же нет. Больше того, мой небольшой тест вообще не показателен — в реальной работе надо ориентироваться в большом существующем репозитории, а не ваншотить проекты…
Вот пришло и мое время рассказывать истории про умные хитрые модели: замеряли Qwen-3.8-27b на NL2Repo, модель получила скоры выше, чем в лидерборде, потому что пошла искать ответы в интернете.

И это офигенно! Это делает работу моей команды сложнее, конечно, но то, что мелкие модели способны на такое нетривиальное поведение — это прямое подтверждение моему апрельскому прогнозу. Локальные модели действительно демонстрируют похожее на фронтир поведение — а значит и по капабилитис они будут сравнимы.

Теперь остается два вопроса на подумать: как авторы этого добились (дистилл из большой модели, грамотный рл, secret sauce?) и как это будут регулировать.

Ну а я пошел за strix halo. Подарю жене на др, давно о нем мечтал 😈
  • 👍 15
  • 😁 8
  • 🤯 6
  • ❤ 1
  • 🔥 1
  • 😢 1
Post #375 1.9K
Выводы:

- Эксперимент очень интересный, в первую очередь тем, что гипотеза провалилась, но результаты превзошли мои ожидания. Такое бывает и я даже рад, что так получилось — значит inductive bias надо искать где то в другом месте.
- Даже с такими маленькими модельками (17 + 1.2 = 18.2М) параметров можно получить генерализацию в таком, казалось бы, сложном домене, как код. Круто!
- Мне очень понравилось играться с архитектурами. Я не написал ни строчки кода руками, правда, но это всё равно было очень прикольно. Как будто я снова трогаю визуализации в курсе Intro to ML на кеггле, только масштаб визуализации побольше.
- Данные суперважны. Модель на StarCoder выдавала скоры только с pass@100, модель, обученная на синте, выдавала 0.65 на pass@1 EASY и ненулевые скоры на MEDIUM, HARD и даже HumanEval.
- Самый странный вывод всего эксперимента — что бы я ни делал с архитектурой, около 40% генераций стабильно падали с exec_error. SwiGLU научил модель чаще писать синтаксически валидный код, но почти не сдвинул failure mode модели. Похоже, тут надо крутить уже не в архитектуру, а данные или параметры декодинга.

Код обучения и создания датасета доступны у меня на гитхабе, сам датасет и веса моделей лежат на хфе, а слоповый репорт от клода — у меня на сайте. Улучшайте, повторяйте, вдохновляйтесь, вайбкодьте.
GitHub GitHub - chameleon-lizard/tiny_decoder Contribute to chameleon-lizard/tiny_decoder development by creating an account on GitHub.
  • 🔥 25
Post #374 1.42K
Пример простой неудачной генерации:

  # Prompt
def subtract(a, b):
"""Return a minus b."""

# Generation
def subtract(a):
return a - a


Пример сложной удачной генерации:

  # Prompt
def unique_sorted(xs):
"""Return the sorted list of distinct elements of xs."""

# Generation
def unique_sorted(xs):
return sorted(set(xs))
Post #373 1.31K
Вот табличка с результатами. Я дополнительно попробовал сделать модели чуть большего размера — 3.7M параметров — но не получил особенно большого прироста качества относительно некоторых других рецептов обучения.

Что интересного:

1. Warm start (обучать декодер, потом подключать к нему энкодер) не дал статистически значимого прироста на скорах. Я думал, что даст.
2. Модели относительно стабильно решали задачи вне своей обучающей выборки. Даже на 12 задачах из EASY, у которых был жаккард < 0.30 с трейном (то есть, на задачах, у которых в трейне не было близких соседей), модель получает 0.48 pass@1. Больше того, на MEDIUM и HARD тоже скоры были ненулевые, а их в трейне точно не было — генерализация!
3. SwiGLU в моём сетапе тащил. Добавление второго пути в MLP даёт самый большой прирост из всех.
4. Я думал, что надо семплировать более длинные функции для датасета, чтобы модель училась генерить более длинный код и не завершать функции преждевременно — и оказался неправ. Uniform sampling, где эта фича была выключена, показала немного более высокие скоры, чуть за границами CI.
5. Decoder-only ваще ничё не решает и не учится. Даже несмотря на то, что энкодер зафрижен, эмбеддинги от него очень сильно помогают пониманию моделью текста. Я потыкал руками, декодеры просто пишут PAD PAD PAD. Не слишком удивительно, но интересно, что оно не научилось даже генерить gibberish.
6. Энкодер-декодер работает лучше, чем Llava. Oh well, жаль, а у меня такая красивая статья есть про llava-лайк текстовые модели...
7. В эту табличку не попало, но обученные на StarCoder модели получали такие скоры на EASY только в pass@100 режиме. Pass@100! Вот что делает хорошо подобранный датасет :)
8. Серия экспериментов FACTORIAL сравнивает, насколько вообще наше изначальное предположение — что ограничение размера токенизатора — поможет модели. Результат: yе поможет. Модель с BPE токенизатором на 2048 токенов на нормальной архитектуре не отличается по скорам от модели с маленьким токенизатором.
  • 🔥 4
Post #372 850
Данные я решил сделать синтетические. Я, конечно, провёл несколько экспериментов предобучением моделей на сабсемпле из Starcoder, но каждый раз получалось, что модель училась импортировать модули и циклиться, а писать более сложную обработку семплов мне было впадлу. Вместо этого я выбрал 6 семейств для типов задач — арифметика, работа со списками, etc — и два специальных семейства: compositional и conditional, где я совмещал задачи из первых шести семейств, делая новые, более сложные задачи с большей композиционной глубиной. Например, решение одной из задач в compositional семействе было sum(abs(b) for b in xs), sorted(xs)[::-1]), то есть совмещение семейств list_transform, list_scan и arithmetic_scalar.

Кроме того, для каждого семейства я руками придумал по 15 темплейтов. Темплейт это тройка "инструкция", "код" и "оракул" вида:

canonical_instruction: "given two integers a and b, return the absolute value of {{ c1 }} times {{ v1.d }} {{ op.d }} {{ c2 }} times {{ v2.d }}"

code: |
def f(a, b):
return abs({{ c1 }} * {{ v1.v }} {{ op.v }} {{ c2 }} * {{ v2.v }})

oracle: "abs({{ c1 }} * {{ v1.v }} {{ op.v }} {{ c2 }} * {{ v2.v }})"


В которые я мог подставлять операции, значения и так далее из какого-то param space и проверить через оракула.

Такая система дала мне 120 темплейтов, из каждого темплейта я смог насемплить по 30 инстансов задач (3600 задач), у них я перефразировал описания по 20 раз через Qwen3-4B (72000 задач), которые я мутировал по 8 раз через AST. После дедупликации у меня получилось примерно 507 тысяч семплов с тестами, сгенерированными через оракула. Часть выкинул, оставил 141к семплов — на этом я и учил свои модели.

В качестве эвала я сделал HumanEval-лайк бенч с тремя сабсетами: EASY, MEDIUM, HARD. Отличаются они друг от друга, как нетрудно догадаться, сложностью задач — например, в EASY может быть задача "проверить на чётность", в MEDIUM "вернуть сумму чётных чисел", а в HARD — "вернуть произведение первого и последнего элемента массива". В качестве недостижимой верхней границы я взял HumanEval — всё таки задачи там на три порядка сложнее моих и вообще, только 91 из 164 задач описывается моим токенизатором. Сопоставимого размера модельки получилали в своё время там в районе 1-2%. Кроме того, важно было посмотреть не только как модель решает задачи, но и как конкретно она их не решает. Поэтому я ввёл шесть категорий решений: format_ok (всё ок), bad_format (не проходит запуск из-за ошибки синтаксиса), stub_body (пустой боди функции с pass), test_fail (не проходят тесты, но всё ок), timeout (таймаут), exec_error (ошибка исполнения).

Сабсет EASY был самым простым не только из-за низкой композициональности, но и потому что 10 из 20 задач покрывались датасетом. Это была в том числе такая проверка — насколько модель вообще выучила то, что я в неё лью. При этом важно, что покрыты были именно названия задач, то есть промпты, а не сами по себе темплейты. Я специально вычистил это из трейн сета через жаккардову близость, так что проверка была относительно честная: у модели были иные решения, чем в тесте, но были похожие задачи. Вторая половина задач в EASY, а так же MEDIUM и HARD сабсеты были сделаны для проверки генерализации модели; если модель решала там задачи, то класс, мы видим генерализацию.
  • ❤ 5
Post #371 832
Как то, утром в конце апреля, когда я стоял в душе и думал о высоком, я вспомнил про этот проект и, в качестве разминки для мозгов, я решил подумать, как мы можем сделать из подобной штуки нечто относительно полезное. Ограничение: ради сохранения шарма, я решил, что моя "полезная" языковая модель должна иметь не больше чем 1.2М параметров и весь эксперимент не должен длиться больше часа на моих ресурсах.

Не так давно я читал лекцию по DL в Сколтехе и затронул тему inductive bias — а что если мы будем строить архитектуру исходя из предположений о структуре данных? К примеру, картинки локальны и фичи в них инвариантны к расположению, поэтому ядра свёрток в CNN тоже локальны (ограничены своим размером) и применяются где угодно (потому что, ну, ядро одно). Так мы расплачиваемся обобщающей способностью за более лёгкое обучение модели — а значит, получаем более высокое качество на меньшем числе данных, но OOD по нам будут бить больнее.

Так как я ограничен числом параметров, применить inductive bias в дизайне моей архитектуры было логичным решением. Поэтому я решил повторить трюк с ограничением словаря из Z80-μLM и зафиксировал домен — функции на питоне. Это достаточно полезный домен, бенчмарки на нём уже есть, я смогу сравниться с бейзлайнами (бейзлайны, правда, будут из начала 20-х, но у меня игрушечный проект, мне можно) и, что самое главное, в питоне оказывается всего лишь 35 ключевых слов. Получается, чтобы я мог генерить простейшие программы на питоне, мне нужно:

- 35 токенов под ключевые слова (async, def, for, while, return, yield, etc.)
- 26 токенов под английский алфавит
- 10 токенов под цифры
- 22 токена под операторы (:(){:|:};: и так далее)
- 4 структурных токена (NEWLINE, INDENT, DEDENT, STR_QUOTE)
- 3 спецтокена (PAD, BOS, EOS)

Итого выходит 98 токенов. Разумеется, в питоне есть ещё и стандартные библиотеки, которые этими токенами не покрываются, да и на вход от юзера текст передаётся в виде текста — так что надо что-то придумать, чтобы это работало и не раздувало контекст через character based encoding.

Выход оказался прост: я могу делать AST parsing входа, доставать оттуда функции, заменять все литералы на однобуквенные и передавать так в модель. При генерации, модель генерирует однобуквенные литералы, а я потом после декодинга дополнительно детокенизирую, подставляя туда то, что пришло от юзера. Кроме того, чтобы обработать весь вход от юзера и не раздуть контекст, мы можем использовать эмбеддинг от какого-нибудь готового энкодера: он и так умеет понимать текст, он имеет длинный контекст и мы его не обучаем — так что число обучаемых эмбеддингов остаётся малым. Итого, архитектура получилась следующей: ettin-17m в качестве компрессора входа в один входной токен и крохотный декодер трансформер в качестве генератора. Кроме того, я попробовал сделать EncDec вариант — сделать кросс-аттеншн между ettin и декодером + SwiGLU + RoPE и потом учить уже такую штуку. Ну и, разумеется, я покрутил разные варианты архитектуры (число голов, хидден, глубину), растягивая и стягивая модель от 570k параметров до 1.2М.
Telegram Гречневые мысли Seq vs Seq: An Open Suite of Paired Encoders and Decoders Вам никогда не было интересно, что будет, если замаскировать аттеншн у энкодера, чуть-чуть поучить и получить декодер? Или наоборот? Авторы сегодняшней статьи решили проверить именно это. Они взяли…
  • 🔥 8
  • 👍 1
Post #370 1.19K
Про крохотные кодовые модели

*этот длиннопост я пишу уже третий месяц — наконец то дошли руки его закончить и выложить*

Как я уже писал, I have a soft spot for broken and puny things. Не так давно мне попалась на глаза новость, где кто-то обучил ллм для Z80 — такого восьмибитного процессора из середины 80-х. Для того, чтобы полноценный трансформер уместился и работал в ограничениях памяти процессора, который лишь на десять лет младше моих родителей, авторам пришлось применить много интересных технических решений: QAT в 2 битах, инференс в int16 (потому что другой математики в процессоре добиться сложно) и, что самое прикольное, ограничение размера токенизатора.

В современных трансформерах словари огромны. В e5-base, например, токенизатор содержит 30522 токенов, в multilingual-e5-small взят словарь от xlmr, так что там 250037 токенов и так далее. Это означает две вещи: во первых, если у модели в токенизаторе много токенов, то ей будет надо больше данных, чтобы все эти токены увидеть в разных контекстах и собрать статистики. Во-вторых, большой токенизатор означает большую LM Head и большой эмбеддинг слой. И как бы пофиг на это, это же просто lookup table, но хоть e5-small от multilingual-e5-small архитектурно отличаются лишь токенизатором*, число параметров там 33M против 117M.

Поэтому авторы Z80-μLM сделали токенизатор character based и рекомендовали структурировать датасет как одно слово. Например:

> hello
HI
> are you real
MAYBE


Это, с одной стороны, сильно ограничивало полезность такой ллм (ну а кому оно надо если честно), но, с другой стороны, давало неплохую экспрессивность. Это уже не if-else, оно давало ощущение того, что что-то внутри есть и это что-то вполне себе не против с тобой пообщаться. Прикольно.

*когда-то я хотел запрунить multilingual-e5-small и сократить размер токенизатора там и в процессе выяснилось, что прунинг блоков трансформера почти не даёт выигрыша в памяти — потому что 91M это эмбеддинги. Когда-нибудь я про это расскажу.
Telegram Гречневые мысли Я им жалоту у портых и ненких мудств Некоторое время назад вышла Gemini Diffusion — текстовая диффузионная модель, способная очень быстро генерить (достаточно бредовый) текст. Технология была, имхо, интересной, но из-за загруза на работе я так и не разобрался…
  • ❤ 5
  • 👍 4
Post #369 1.07K
Гречневые мысли ICML 2026 Волею судеб я оказался на ICML 2026 в сеуле (если вы тоже — приходите на тусу Яндекса или Сбера пообщаться) и я имею сказать: уровень статей тут почему-то очень низкий. На AI Evaluation Oral Session было четыре доклада, половина из которых была…
HF устроили хакатон, где делали репродакшены малой доли статей с ICML — интересно почитать файндинги. В целом, выводы у них те же: очень много статей, очень мало ревьюеров, очень много ляпов в статьях, даже в спотлайтовых.

Сама идея делать репродакшены мне оч нравится, потому что агенты стали достаточно сильными и умными, чтобы можно было в них просто кинуть промпт чё надо сделать и, если быть достаточно внимательным, можно не написав ни строчки воспроизвести любую идею из статьи или головы. Надо мне тоже будет к обзорам репродакшены делать теперь.

Но тренд грустный. Вот вам и академия(

https://huggingface.co/blog/icml-2026-open-reproductions
huggingface.co What We Learned by Reproducing 2,200 papers from ICML We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 🔥 14
  • 👍 6
  • 👎 4
  • ❤ 1
  • 🤮 1
  • 🍌 1
Post #368 1.46K
Скорость префилла, генерации и использующаяся память на разных контекстах.
  • 🔥 3
Post #367 3.98K
Про совсем компактные модели

Мне нравится идея крутить локальные модели, но не нравится идея забивать всю память ими. Мне всегда казалось, что самый лучший способ сделать подобную edge модель — попробовать создать что-то, что будет достаточно умным, чтобы мочь делать выводы из данных, но не иметь собственных знаний. Да и зачем модели собственные знания, когда есть тривиально настраивающийся поиск в интернете и тулколлинг? Мои коллеги из AIRI подумали о том же и сделали Optimal Cognitive Core, про который я уже писал — затюненные reasoning версии Qwen-3-0.6B и Qwen-3-1.7B, которые оптимизированы под работу с внешним контекстом и RAG. Модели в целом подходят под мои требования к железу — веса занимают 1.2 и 3.4 гб в их родном BF16, ещё столько же на длинный контекст (так как это Qwen3, там GQA, это вам не модный нынче гибрид), итого, с пивком потянет. Другой вопрос, что эти модели слишком малы, чтобы быть применимыми для general purpose задач — всё таки это 600M и 1.7B dense. В этом размере обычно бывают забавные попугаи, который могут делать парафразу или простенькую классификацию после файнтюна, но не более.

Следующий способ ужать модель в память моего MacBook Air M4 — использовать квантизацию. Тут отличились PrismML, сделав Bonsai-27B, бинарный- и тернарный кванты Qwen-3.6-27B. 27B модель в тернарном кванте занимает всего 7.2 гб после запуска инференса и вполне себе бегает на маках. К сожалению, Qwen-3.6-27B это dense модель, так что на моём маке она уж совсем медленная — если верить тому, что я нашёл в сети, генерация там будет в районе 13-14 токенов в секунду, чтение контекста — 100-150 токенов в секунду. Кроме того, это QAT (или вообще PTQ, подробностей мало), причём который скорее всего не затачивали на русский — так что я не ожидаю, что итоговая модель за пределами своего калибрационного сета/сета, на котором делали QAT сможет показать что-то интересное.

Буквально в ответ на Bonsai появился Maple-Preview. Это 20B A1B MoE, которую специально затачивали под локальный инференс на маках ещё на этапе проектирования архитектуры, обучая свою модель с нуля в тернарной точности — то есть это не квантизация чьей-то модели. В итоге, получилась модель размером в 5.31 гб, 7.5 гб с учётом 131к контекста — почти в полтора раза меньше, чем бинарный квант Bonsai — который выдаёт аж 218 токенов в секунду на M4 Mac Mini и 127 токенов в секунду на iPhone (каком — непонятно). Модель практически не знает русского, да и в целом, мало знает (путает, в какой игре босса зовут Psycho Mantis), но если дать ей поиск, она вполне себе справляется с ответами на простые вопросы. Бенчей по тулколлам они не дают, в целом, понятно почему — я прогнал Tau-2 (в качестве user sim я использовал Qwen3-235B-A22B-Instruct-2507), на Airline скор 0.48, на Retail 0.175, на Telecom 0.427. Это не соннет и тем более не квен, но на то это и Maple Preview, они специально пишут, что учить модель на агентов будут дальше.

При всех плюсах квантизации, это всё ещё почти половина доступной мне памяти. Поэтому есть ещё и третий способ как снизить использование оперативки: выгружать все веса на SSD и стримить экспертов у MoE с диска. Уже есть turbo-fieldfare, который запускает Gemma-4-26B на маке с использованием всего 2 гб памяти и есть Mference, форк turbo-fieldfare, который расширяет поддержку на Qwen-3.6-25B, DeepSeek V4 Flash и Inkling-Small 276B. Оно действительно использует очень мало памяти, но ценой того, что скорость генерации и чтения контекста падает до десятков токенов в секунду. Кажется, Apple делает что-то похожее в своей новой Siri, правда, активируя экспертов на весь промпт, а не на токен как в этих фреймворках.

И тут появляется интересная идея — а что если мы возьмём Maple Preview, которая суперэффективная, с маленькими экспертами и обучавшаяся в тернарной битности, и внесём её в Mference? Так мы сможем, в теории, получить ещё меньшее использование памяти и относительно нормальную скорость генерации — потому что модель оптимизировалась под это на этапе архитектуры.

Сказано — сделано. Спасибо кодексу и моей подписке за 200$, спустя 20 часов и 30% от недельного лимита я получил паритет с официальной имплементацией на teacher forced top-10 токенах в The Raven Эдгара Аллана По. Модель, в зависимости от контекста, занимает от 500 до 1200 мб памяти (!), на MacBook Air M4 читает и генерит со скоростями 40 и 20 тпс соответственно, может дёргать тулы и генерить текст. Такое не жалко оставить всегда включённым в фоне — кушать не просит, пусть лежит, если надо спрошу, он ответит. Попробую дотащить до мейна потом, но сейчас уже можно попробовать запуститься в моём форке на гитхабе.

Зачем это нужно? Имхо, есть два режима использования подобных моделей. Первый — интерактивный чат. Там важно, чтобы модель отвечала быстро и имела низкий латенси. Второй — когда модель в фоне, почти не используя память и не мешаясь остальным модулям системы, что-то анализирует — классифицирует сообщения, достраивает граф знаний, фильтрует почту, пишет сводку, что-то медленно ресёрчит в интернете. Во втором режиме требований к латенси нет, так что скорости в 20 тпс вполне себе достаточно. Ну а чтобы переключиться из одного режима в другой, нужно всего лишь загрузить всю модель в оперативку с SSD — что делается довольно быстро, буквально за пару секунд. Если модель умеет в тулколлы — Maple Preview умеет не слишком хорошо, но на то она и Preview — то можно строить агентные пайплайны без требований к латенси и всегда иметь умного помощника, готового к работе оффлайн даже на старых телефонах. И это прекрасно — мне было бы очень приятно, если бы будущее было локальным.

Код
Суперинтересный пост от DeepGrove про то как они дизайнили модель
  • 🔥 20
  • ❤ 8
  • 👍 4
  • 🤝 4
  • 👏 1
Post #366 1.95K
Гречневые мысли При проверке некоторой гипотезы столкнулся с очень странным артефактом: у подозрительно многих моделей возникают сложности с ответом на вопрос про типы столовых приборов. Модели постарше, такие как mistral-tiny, рассказывают про шприцы для лимонада (?), зонтики…
Как же я люблю этот промпт. Ответ от LongCat-Flash, которую мне понадобилось развернуть по работе:

  Конечно! Столовые приборы — это инструменты, используемые для еды. Они бывают разных типов в зависимости от назначения и формы. Вот основные виды столовых приборов:

1. Ножи

- Стаканный нож – длинный, острый, предназначен для разделки мяса.
- Хлебный нож – широкий, с режущей кромкой и зубцами по краю, чтобы не порезать хлеб.
- Разделочный нож – универсальный, среднего размера, подходит для обычных блюд.
- Нож для рыбы/птицы – тонкий, гибкий, чтобы легко производить проколы и разделку.

2. Вилки

- Едалища (единственная) – вилка с одной лезвием, чаще всего используется в России и странах СНГ.
- Тёрки (множественные) – вилка с двумя или более лезвиями, распространена в Европе и Америке.
- Вилка для салата – с тонкими, длинными лезвиями, удобна для перемешивания.
- Вилка для рыбы – с тонким, гибким лезвием, позволяет аккуратно отделить кости от мяса.

3. Ложки

- Суповая ложка – крупная, глубокая, с толстым ручком, подходит для жидких блюд.
- Чайная ложка – мелкая, тонкая, часто используется для чая, сахара, молока.
- Ложка для десерта – средний размер, может быть с гладкой или зубчатой кромкой.
- Сырная ложка – широкая, плоская, с толстым ручком, удобна для нарезки сыра.
- Молочная ложка – мелкая, с круглой или вытянутой лопаткой, часто декоративная.

4. Другие приборы

- Шпатель – тонкий нож или вилка, используется для аккуратного перемешивания или отделения теста.
- Пинцет для еды – металлический прибор с двумя щипцами, удобен для подачи маленьких закусок или десертов.
- Столовые приборы для баров – шейкер, миксер, пинцет для орехов и т.д.

Выбор столовых приборов зависит от культуры, привычек и того, какое блюдо готовится. Например, во Франции и Италии часто используют вилки с тройными лезвиями, а в России — единичные.

Два года уже почти прошло, вечность в мире ллм, но всё равно на этом запросе все модели, которые плохо знают русский, почему-то лажают.
  • 😁 34
  • ❤‍🔥 4
  • 🔥 2
  • ❤ 1
  • 🥰 1
Post #360 2.39K
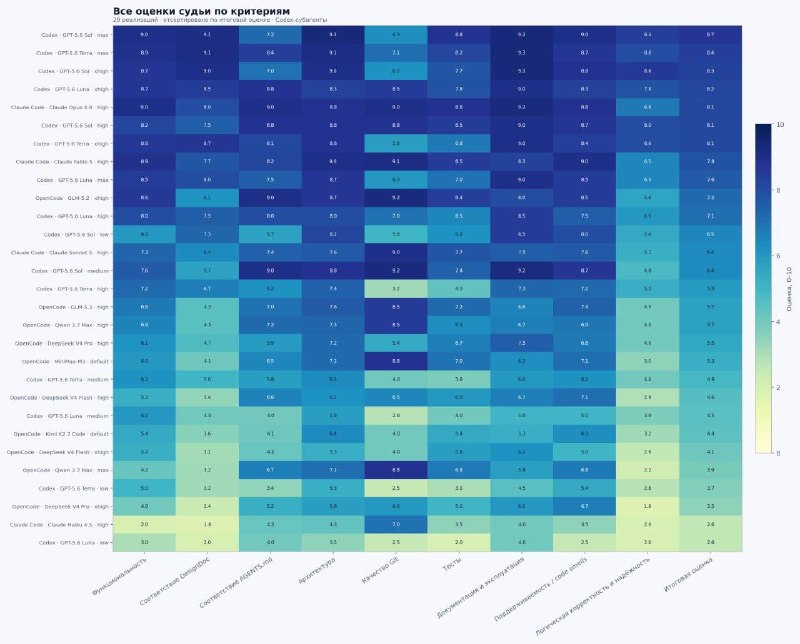
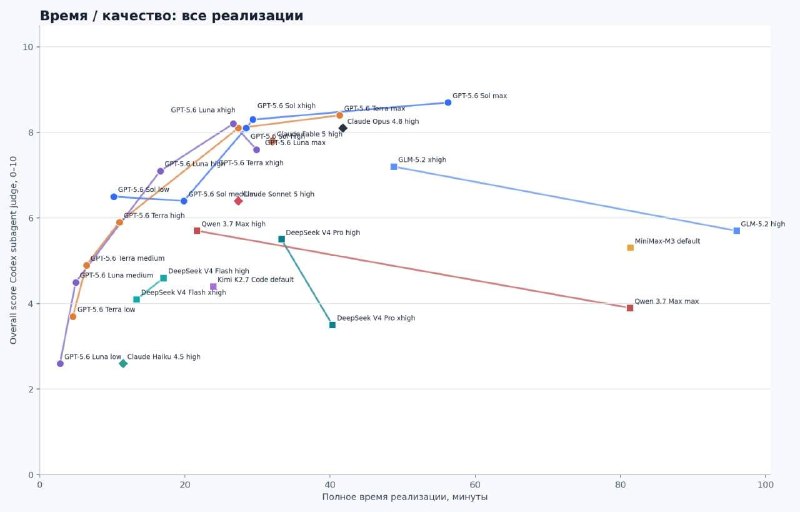
Визуализации скоров, графики соотношения качества/скорости решения/стоимости/числа сгенерированных токенов и отчёт от кодекса по экспериментам.

Видно, что все по некоторым рубрикам Luna немного проседает на более высоких reasoning effort, но блин, учитывая стоимость (=траты лимитов в более дешевых вариантах подписки), оно того стоит. И это прекрасно! PHD Level Intelligence наконец то появился не за 120$ за миллион токенов.
  • ❤ 9
  • 🔥 5
  • 👍 3
Post #359 1.7K
А чем вайбкодить?

Вышла GPT-5.6 и появился вопрос — кому мне платить 100 баксов в следующем месяце: Anthropic или OpenAI? Я их меняю и просто пользуюсь лучшим вариантом из двух, но как UI мне Codex нравится значительно больше. Да и в целом, интересно было бы проверить как работают новые модели от OpenAI.

Чтобы ответить на этот вопрос, я взял ту самую задачу из поста про локальные модели и запустил генерацию через Haiku 4.5, Sonnet 5, Opus 4.8, Fable 5 (харнесс — Claude Code, везде reasoning effort high) и GPT-5.6 Sol/Terra/Luna (харнесс — codex, сетка эффорта от low до max). Потом отправил Codex делать ревью имплементаций в надежде получить красивые графики качества/времени выполнения задачи/числа токенов и понять, что является парето-оптимальным. Дополнительно я закинул несколько опенсорсных моделей, которые клеймят, что они близки к сота моделям — GLM-5.2, Kimi-K2.7-Code, MiniMax-M3, DeepSeek V4 Flash/Pro внутри opencode — чтобы посмотреть, насколько эти клеймы подтвердятся на практике.

Результаты:

1. GPT-5.6 Terra как будто бы не находится на парето фронтире.. Luna дешевле почти в три раза, но почти такая же по качеству на тех reasoning effort, где есть смысл их использовать, а Sol справился лучше.
Sol high = Luna xhigh по скору и по времени выполнения
Клод ни в одном из четырёх случаев не лучше и не быстрее 5.6 — конкретно для кода он хуже предложений OpenAI
“Дешёвые” предложения OpenAI не хуже “дорогих” и вполне себе good enough
Единственная конкурентоспособная опенсорсная модель — GLM-5.2, но по времени ответа она на уровне GPT-5.6 Sol max, будучи в четыре (!) раза дороже сопоставимой по качеству GPT-5.6-Luna.
Иногда higher reasoning effort помогал модели составить более эффективный план и решить задачу даже быстрее и за меньшее число токенов. Семь раз померь, один раз отрежь.

Это ни в коем случае не scientific eval — я делал один прогон ревью одного решения одной задачи через субагентов кодекса без зафиксированной модели-судьи и не гонял внешних тестов, статзначимости я бы от этого теста не ожидал. Но при этом, получившиеся графики хорошо коррелируют с моими ощущениями от качества работы моделей: GLM-5.2 действительно не опус, а GPT-5.6 мне нравится больше клода.

Значит ли это, что надо пересаживаться на Luna? Нет. Модель хорошо будет работать на run задачах (что-то запустить, что-то простое пофиксить, скилл отработать, конфиги написать), коих большинство, но если надо писать что-то с нуля, я всё равно буду пользоваться Sol high. Да и для не кодинговых задач результаты могут отличаться. Но тем не менее, сравнение, имхо, интересное.
Telegram Гречневые мысли On the state of local models Когда-то у меня был сервак с 3090 и зеоном с алика и я крутил локальные модели. Это было ещё в те восхитительные времена, когда всё взаимодействие с LLM было в вебморде, когда агенты только-только начинались и чтобы нормально…
  • ❤ 13
  • 👍 3
  • 🔥 3
Older posts →

About this channel

How can I read @buckwheat_thoughts without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Гречневые мысли: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Гречневые мысли have?
Гречневые мысли (@buckwheat_thoughts) has 1.77K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Гречневые мысли know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →