TGViewer
Channel Public Channel
BRAIn Lab: Optimization and Beyond

BRAIn Lab: Optimization and Beyond

@brainlaboratory

Канал лаборатории фундаментальных исследований ИИ.
В фокусе: оптимизация в ML, GenAI, математика ИИ, ИИ для науки, федеративное обучение.
Научный руководитель: Александр Безносиков @abeznosikov
Subscribers
1.16K
Photos
261
Videos
8
Links
78

Showing posts older than #68 · Back to latest

Older Posts 9 shown
Post #63 847
Вот мы и на AAAI в Сингапуре 🇸🇬🌴

Перелёт через Китай, встреча с коллегами из Пекинского университета, посещение Запретного города и Великой китайской стены - все это привело нас из -12 в +30 к первому дню презентаций с очными докладами и постерами на конференции AAAI-26.

❕На конференцию было подано более 24 тыс статей.

Интересный факт: конференция американская, сабмитов из Китая - около 18 тыс, а из США - 3 тыс.


Напомним, что из нашей лаборатории прошли 2 статьи 🔥🔥

💪💪Сегодня статью “Bant: Byzantine Antidote via Trial Function and Trust Scores” освещали ее первые авторы - Глеб Молодцов и Даниил Медяков.

Вокруг постера всегда было оживленно, с коллегами рисовали формулы и вели подсчеты на планшетах, потому что не всегда легко было достигнуть консенсуса, общаясь только на английском. После доклада также развернулась дискуссия.

Если кратко: Сингапур нравится, отель хороший, погода теплая, да и сама конференция на уровне с отечественными: AI Journey, Data Fusion и ISP RAS (больше, но не лучше)!


Пишите в комментариях, что вам было бы интересно узнать о конференции и докладах, а завтра мы покажем!
  • 🔥 42
  • 👍 1
Post #62 972
“Давайте после новогодних” наступило

На первой рабочей неделе года наша лаборатория уже собирается на конференцию.
И едем мы в Сингапур на AAAI-26

Если вы еще не разогнались, рекомендации от нас на бодрый старт в январе:

🟣поставьте научные цели на год
🟡задумайтесь, хотите ли попасть на стажировку
🔵запланируйте участие в конференциях (лично с докладами, как зритель или участник)
🟢решите, на какой кафедре вы хотели бы оказаться и с каким научным руководителем работать, какими темами хотите заниматься


✅Оставайтесь с нами, совсем скоро мы покажем атмосферу на одной из ведущих A* конференций и расскажем про статьи, которые презентуем там
  • 🔥 25
  • 👍 3
Post #55 1.32K
Уже скоро наступит новый 2026 год! 🎄

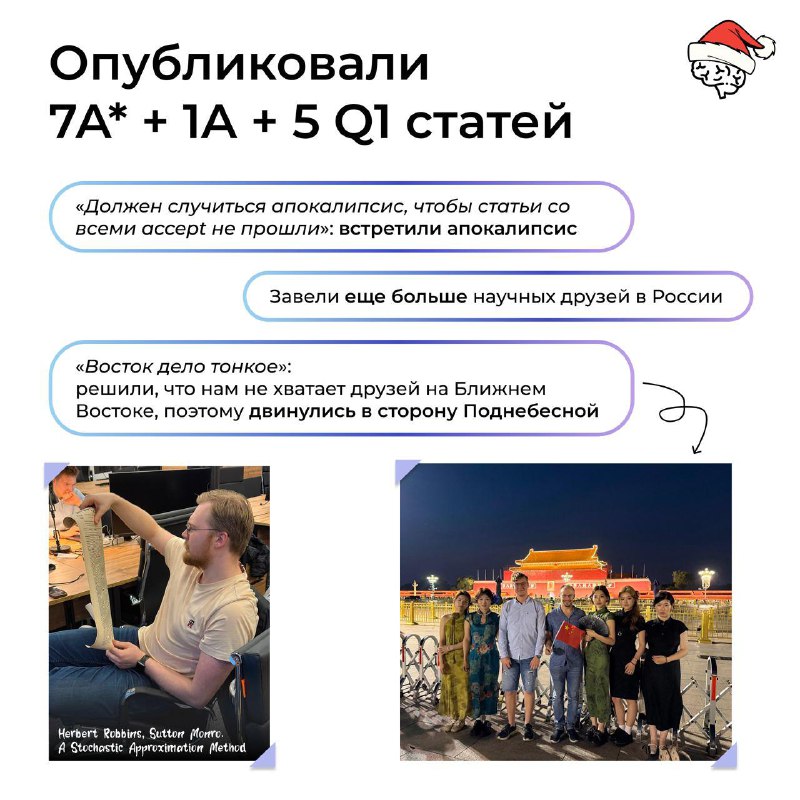
Уходящий год был очень насыщенным для нас - на карточках постарались основные события в жизни лаборатории! 🎅

Всех с наступающим! Дальше только интереснее! 🎉
  • ❤ 25
  • 🎄 9
  • 🎉 7
Post #53 2.24K
Сегодня вечером приходят радостные новости из Яндекса!
Сотрудник нашей лаборатории Александр Богданов стал обладателем Yandex ML Prize!
Саша это тот человек, труд которого, возможно, незаметен, но очень важен! Он отвечает за все наши образовательные активности, а их немало! Только в этом году мы запустили курс по оптимизации в Центральном Университете, курс по ML в МФТИ и ИСП РАН! Наряду с этим мы продолжаем совершенствовать наш большой курс по оптимизации на Физтехе, преображаем новую кафедру «Программные исследования и разработка» в одну из сильнейших баз ФПМИ, завершаем верстку 500-страничного пособия по численными методам! Все эти проекты стали возможны благодаря титаническим усилиям Саши!

Саша, ты большой молодец! Мы все за тебя рады! Желаем вывести образование на новый уровень, ну и выспаться!
  • 🔥 62
  • ❤ 14
  • 👍 1
Post #52 1.51K
Семинар: Memory-efficient LLM training — существующие методы для эффективной тренировки больших языковых моделей

🗓 Когда: 13 ноября, 18:35
🎙 Докладчик: Егор Петров — студент 4 курса бакалавриата МФТИ, сотрудник BRAIn и Yandex Research

О чём пойдёт речь?
Вы хотите обучить мощную языковую модель, но доступная память на GPU строго ограничена, а стандартные оптимизаторы вроде AdamW тратят гигабайты на состояния и градиенты. Как же быть в условиях ограниченных ресурсов? Это классическая проблема для LLM — тренировка требует огромных вычислительных мощностей, но существует множество инновационных подходов, чтобы обойти эти ограничения.

Мы разберём ключевые идеи из свежих статей — GaLore, FRUGAL, Fira, LDAdam, Apollo, AdaMem, Lomo и AdaLomo, — где предлагаются решения вроде low-rank проекций градиентов, разделения обновлений на state-full и state-free компоненты, адаптивных learning rate с минимальным overhead и даже слияния вычисления градиентов с обновлением параметров.

На семинаре обсудим:
🔵Какие подходы и идеи существуют для тренировки больших моделей в условиях ограниченных ресурсов;
🔵Как эти идеи эволюционировали со временем — от GaLore до FRUGAL;
🔵Тонкости сравнения и особенности экспериментальных сетапов — от pre-training на C4 до fine-tuning на GLUE и SuperGLUE.

Ссылка для подключения:

https://us06web.zoom.us/j/85248717255?pwd=Py0aex6j95MmuKVCHocp5INpv6qwkn.1

Приходите, будет интересно!

P. S. Если не сможете присутствовать — запись семинара появится на нашем Rutube-канале через неделю. А пока можно посмотреть предыдущие выпуски!
  • 🔥 11
  • 👍 2
Post #51 1.07K
Ночью пришли результаты конференции AAAI-2026 (топ-4 A* в области ИИ по версии Google Scholar), которая пройдет в январе в Сингапуре!

От нас на конференцию прошло две работы:

[Oral] Gleb Molodtsov, Daniil Medyakov, Sergey Skorik, Nikolas Khachaturov, Shahane Tigranyan, Vladimir Aletov, Aram Avetisyan, Martin Takáč, Aleksandr Beznosikov

Bant: Byzantine Antidote via Trial Function and Trust Scores

Статья доступна на [arxiv]

Для Глеба и наших друзей: Сережи, Николаса, Шагане и Арама - это первый А*! И сразу oral! Для Даниила с Вовой - формально это тоже первый accept!


Vladimir Solodkin, Andrey Veprikov, Alexander Chernyavskiy, Aleksandr Beznosikov

Methods for Optimization Problems with Markovian Stochasticity and Non-Euclidean Geometry

Статья доступна на [arxiv]

Для ребят это тоже первый А*!

Скоро расскажем про статьи здесь в телеграмме!

P.S. У Глеба сегодня еще и день рождения! Так получилось, что первый подарок пришел в 2 ночи!
  • ❤ 34
  • ❤‍🔥 17
  • 👍 5
Post #49 1.39K
✨ В следующую среду состоится семинар с уникальным гостем Cong Fang — ресерчер из Peking University. Встреча пройдёт на английском языке. Также обращаем внимание: при входе в конференцию необходимо авторизоваться под своим именем и фамилией — участников с ником «Гость» мы не сможем пропустить.

Seminar: Implicit Regularization of SGD in High-dimensional Linear Regression

🗓 When: October 29, 11:00 AM
🎙 Speaker: Cong Fang, Researcher at Peking University

What will the talk cover?
Stochastic Gradient Descent (SGD) is one of the most widely used algorithms in modern machine learning. In high-dimensional learning problems, the number of SGD iterations is often smaller than the number of model parameters, and the implicit regularization induced by the algorithm plays a key role in ensuring strong generalization performance.

In this seminar, we will:
🔵 Analyze the generalization behavior of SGD across different learning scenarios;
🔵 Compare learning efficiency under various scales — depending on data size and dimensionality;
🔵 Discuss the effects of covariate shift;
🔵 Present theoretical insights that inspire memory-efficient training algorithms for large language models (e.g., GPT-2)

Join link: https://us06web.zoom.us/j/89195790461?pwd=HmgS42lBtBe25a5Oa9baLMUacC9x4L.1

Come join us!
  • ❤ 13
  • 👍 4
  • 🔥 4
  • 🕊 1
Post #48 1.36K
Семинар: LoRA meets Riemannion: Muon Optimizer for Parametrization-independent Low-Rank Adapters

🗓 Когда: 16 октября в 18:30
🎙 Докладчик: Алетов Владимир — сотрудник лаборатории BRAInLab, студент МФТИ и Моложавенко Александр — сотрудник лаборатории MTML HSE, аспирант МФТИ

О чём пойдёт речь?
Современные большие языковые модели (LLM) требуют колоссальных вычислительных ресурсов при полном дообучении. Поэтому методы малопараметрической настройки, такие как Low-Rank Adaptation (LoRA), стали стандартом для задач дообучения. Однако классическая LoRA страдает от фундаментальной проблемы — неоднозначности параметризации: одно и то же обновление весов может быть представлено множеством пар матриц (A, B), и выбор конкретного разложения влияет на качество обучения.

Мы предлагаем полностью «риманову» формулировку задачи, которая устраняет эту неоднозначность и позволяет использовать геометрию адаптеров при оптимизации моделей. Новый оптимизатор Riemannion обобщает идею Muon (2024) на многообразие фиксированного ранга, сохраняя эффективность и обеспечивая инвариантность к выбору параметризации.

На семинаре обсудим:
🔵 Как некоторые представления LoRA могут привести к неэффективности обучения;
🔵Как работает Muon-оптимизатор и его представление в виде задачи LMO;
🔵Что такое многообразие фиксированного ранга и как на нём можно оптимизировать адаптеры напрямую;
🔵LOI (Locally Optimal Initialization) — как выбрать начальные параметры LoRA на основе римановой геометрии;
🔵Сравнение с другими методами (DoRA, LoRA+, LoRA-GA, RPrecAdamW) и результаты на Llama 3-8B и Stable Diffusion 2;
🔵Практическую реализацию и почему Riemannion почти не увеличивает время обучения, но стабильно улучшает метрики

Ссылка для подключения: https://telemost.360.yandex.ru/j/9200324622

Приходите, будет интересно!

P. S. Если не сможете присутствовать — запись семинара появится на нашем Rutube-канале через неделю. А пока можно посмотреть предыдущие выпуски!
  • 🔥 10
  • 🤩 2
  • ❤ 1
  • 👍 1
  • 🙏 1
Post #47 1.02K
✨ В этот четверг состоится очередной семинар, но он пройдёт на английском языке. Также обращаем внимание: при входе в конференцию необходимо авторизоваться под своим именем и фамилией — участников с ником «Гость» мы не сможем пропустить.

Seminar: Benchmarking the Continuous Gromov-Wasserstein Problem: Towards Reliable Solvers with NeuralGW

🗓 When: October 9, 6:35 PM
🎙 Speaker: Xavier Aramayo — PhD Student, Skoltech

What will the talk cover?
The Gromov-Wasserstein Optimal Transport (GWOT) problem aims to find structural correspondences between distributions without requiring point-to-point alignment. While continuous GWOT holds great potential for machine learning, most current solvers rely on discrete approximations. These methods often fail to generalize, restrict applicability to highly correlated datasets, and struggle with scalability.

In this seminar, we will:
🔵 Review the challenges and limitations of existing GWOT solvers;
🔵 Present a systematic benchmark across diverse experimental settings;
🔵 Introduce NeuralGW, a continuous, gradient-based solver that avoids discrete constraints and better captures intrinsic distributional structure

Join link: https://telemost.yandex.ru/j/19488788295412

Come join us!

P.S. If you can’t attend live, the recording will be made available afterward here. In the meantime, feel free to check out our previous seminars!
  • 🔥 6
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →