


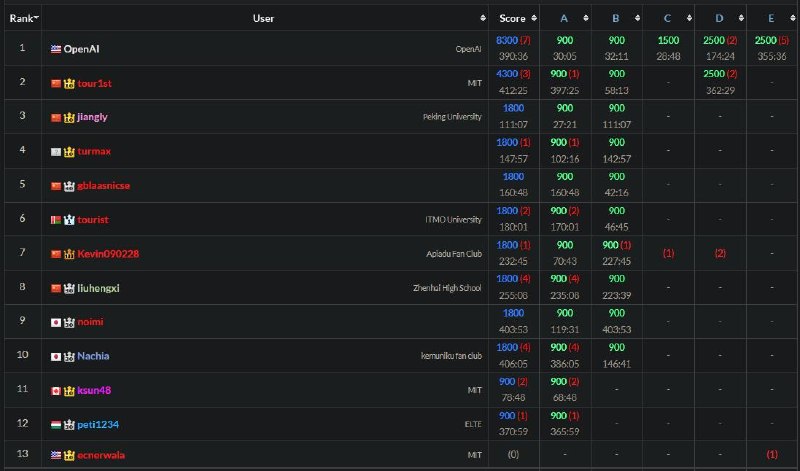
Год назад я писал про соревнования по программированию AtCoder, где система от OpenAI долгое время лидировала, но под конец поляк Psyho смог вырвать победу, став последним человеком, кому удалось обойти машину в подобного рода состязаниях. За 12 месяцев модели (снова) шагнули далеко вперёд, и теперь выиграли без шансов в двух разных раундах.
Первый — эвристический, где точное лучшее решение задачи неизвестно из-за огромного количества потенциальных комбинаций (часто это задачу на оптимизацию со множеством условий). Здесь нужно придумать, перебрать и совместить ... эвристики, как понятно из названия. В период соревнования было 50 тестов, лучшее решение на каждом получало миллиард очков, с решения ниже получали меньше пропорционально логарифму (поэтому "огромный" отрыв на деле может быть не таким гигантским). После окончания соревнования делали полную проверку на 2000 тестов, охватывающий более широкий набор однотипных условий для задач. Решение OpenAI было лучшим на 1997 из них 👨🦳
Борис, сотрудник OpenAI на месте соревнований и автор @bminaiev_blog, сказал, что не был полностью уверен, что машина сможет обойти человека в эвристиках— а вот во втором раунде, алгоритмическом, ожидал победы. Собственно, там всё как в классических соревнованиях: есть N задач разной сложности, можно решать и отправлять в любом порядке; ответ для каждого теста всегда один, поэтому тут или засчитывают решение, или нет (нет сравнения по оптимальности, как у эвристик).
Было 5 задач, и авторы соревнований старались выбрать их специально так, чтобы AI не мог с ними справиться. Тут я не до конца уверен, что понимаю причину, так как не знаю, были ли разрешены LLM-ки (видимо, нет, раз не все решили первые 2 задачи? может авторы просто боялись читерства?). Две последние задачи были крайне сложными и оценивались в 2500 условных баллов — для сравнения, в прошлом году были сложные задачи по 1400 и 2000, а за год до этого — две по 2000.
Модель тоже очень долго тягалась с ними, потратив на последнюю 6 часов, но смогла решить всё. Как вы можете видеть по последней картинке лишь один человек смог решить одну из этих сложных задач — на вторую не осталось времени. Другие участники, в том числе легендарный Геннадий Короткевич aka tourist (самый титулованный спортивный программист планеты), осилили по 2 задачи (или даже меньше).
Борис говорил, что они тестировали систему на задачах предыдущих лет, и все или почти все решались максимум за час — так что у авторов соревнований действительно получилось придумать челлендж для LLM. Также Борис добавил, что использовали модель, очень близкую к GPT-5.6 (как минимум для второго раунда, для первого не смог найти подтверждений), и харнесс поверх был тривиальным, может сделать каждый. Никак специальных сложных систем.
Результатов на IMO / IOI / IPhO и других конечно ждём, но думаю, что они предсказуемы 😕
Post #532
348