
NLP!
В ИБ - полезен.
Но как разобраться?..
Часть1.
#ml_для_иб
Начнем издалека, и подойдем к практике в конце)
Что это - NLP? Natural Language Processing - обработка естественного языка. Говоря кратким образом, обработка заключается в том, что слова очень хотелось бы представить в виде чисел, хоть как-то отображающих смысл, в этих словах заключенный. Смысл в словах, предложениях и целых текстах постулируется как разница между числами, векторами, матрицами. Развиваться область начала давно, аж с 1949 года. О ключевых вехах (text statistics, rnn, word2vec, ...) этого направления МЛ хорошо расписано тут (со ссылками на самые значимые статьи, доклады и релизы).
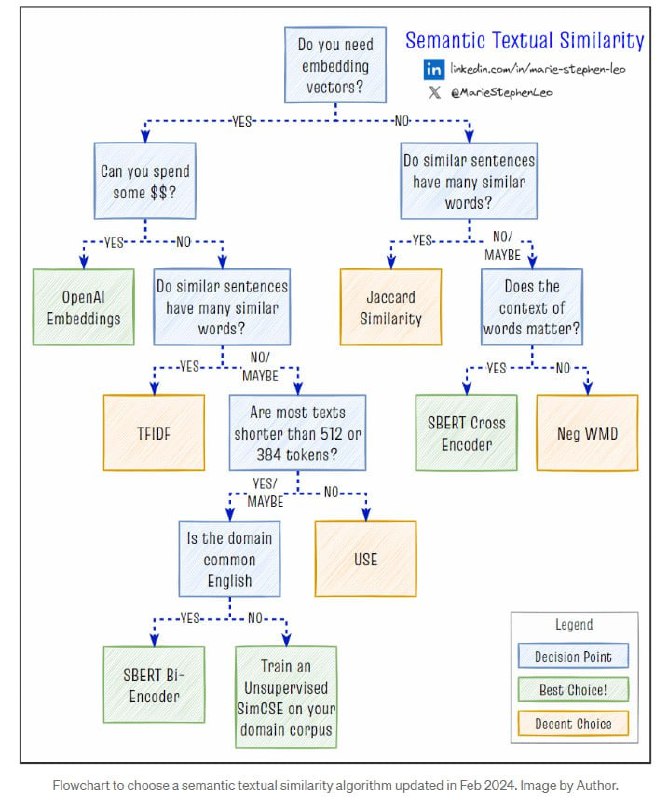
Как специалисту в мл начать путь в познании области NLP? Для начала - покопайтесь в математической лингвистике. Для чего и зачем делается лемматизация, приведение слов к нормальной форме, поиск стоп-слов в тексте, что такое токенизация и паддинг. После - я бы порекомендовал научиться считать слова. CountVectorizer из sklearn то бишь - вот первый шаг на этом пути. Далее следует TF-IDF, и некоторые надстройки над ним - например, выясните, зачем проводится L1 и L2 нормализация создаваемых этим алгоритмом весов. Отличную статью с NLP-алгоритмами в порядке усложнения можно найти на TowardsDataScience, но она под пейволом. Однако, при определенной ловкости рук с использованием этой ссылки, его можно обойти...
Следующим углублением в вопрос станет изучение в ручном режиме принципов работы первого и простейшего генератора эмбеддингов слов - Word2Vec от Google. Эмбеддинг - это вектор, обозначающий какую-то текстовую единицу - слово, словосочетание, текст целиком. И да, за вас это уже сделали вот в этой онлайн-таблице. Осталось только аккуратно повторить и разобраться. В ней также есть ссылка на статью на medium с разбором, обходить пейвол мы уже умеем.
Начало положено, в следующей части разовьем успех ссылочками на полезное по моделям эмбеддингов и LLM.
Post #80
272
- 👍 1