TGViewer
Channel Public Channel
سماموس: نوشته‌های یوسف مهرداد بی‌بالان

سماموس: نوشته‌های یوسف مهرداد بی‌بالان

@bibalan_com

این کانال برای اطلاع‌رسانی نوشته‌های وبلاگ سماموس (bibalan.com) ایجاد شده است. مطالب پس از انتشار در وبلاگ، در این کانال نیز منتشر خواهد شد. امیدوارم که مطالب آن برای شما مفید باشد و خوشحال خواهم شد تا نظرات و بازخوردهای شما عزیزان را دریافت کنم.
Subscribers
297
Photos
27
Videos
7
Links
353

Showing posts older than #287 · Back to latest

Older Posts 20 shown
Post #286 243
نخست مرتب‌ کنید (tidy first) (۲)

در مورد مرتب‌سازی (tidying)

سوال اصلی این است: “من می خواهم کدی را تغییر بدهم ولی ساختار کد به گونه‌ای است که تغییر آن دشوار است. آیا ابتدا باید کد را مرتب کنم؟” بِک ادامه می‌دهد “من در مورد بازسازی‌ (refactor) کدهای بزرگ صحبت نمی‌کنم. من در مورد تقسیم کدهای بزرگ و یک‌تکه به مایکروسرویس‌ها(microservice) و تصمیم‌های بزرگ و باشکوه در مقیاس بزرگ صحبت نمی‌کنم. من در مورد رابطه‌‌ی خودم با خودم صحبت می‌کنم. آیا برای خودم این ارزش قائل هستم که کارم را راحت‌تر کنم؟”با این اوصاف، برنامه نویسی نباید کاری اضطراب آور، دلهره‌آور و اعتماد به نفس خراب‌کن باشد. در نتیجه، قبول یک مساله‌ی پیچیده و شکستن آن به مساله‌های کوچکتر که درک آنها آسان‌تر است، عادت بی‌نهایت مفیدی است. او می‌گوید”اصطلاحی است که تقریباً ده سال پیش آن را پیشنهاد کردم: – MCETMEC تغییر را آسان کنید و بعد تغییر آسان را انجام دهید (Make the Change Easy Then Make the Easy Change).آسان کردن تغییر، قلمروی اصلی طراحی نرم افزار است. بنابراین به جای اینکه بخش‌های سخت و پیچیده را تغییر دهید که برای انجام آن هم مجبورید به صورت همزمان 100 جای سیستم را تغییر دهید، می‌توانید ابتدا کدها را مرتب کنید، هزینه ایجاد همه آن تغییرات را کم کنید و سپس یک تغییر آسان را انجام دهید.”

در توسعه نرم‌افزار، زمانی‌که از یک ایده (مثلا”من به یک دکمه در سیستم برای ویرایش اطلاعات نیاز دارم”) به تغییر(UX، گردش‌ کار و بک‌اند (backend) پشت آن) می رسیم، رفتار سیستم یعنی ویژگی‌های قابل مشاهده بیرونی آن -را تغییر می‌کنیم. تغییر در رفتار برنامه معمولا باعث ایجاد چرخه‌ای می‌شود که در آن، پیاده‌سازی هر ویژگی جدید باعث تولید مثل و تولد ویژگی‌های جدیدتری می‌شود. از سوی دیگر یک مسیر موازی و پنهان نیز وجود دارد که بخش ساختاری نرم‌افزار است (شبیه به کوه یخی که قسمت‌هایی از آن در زیر آب پنهان است). یکی از نکات زیبا و قشنگ در اینجا این است که ساختار نیز به‌تنهایی می‌تواند برای کارهای قابل انجام در سیستم، ایده‌‌هایی را پیشنهاد کند. و اگر بتوانید تمام این حلقه‌های بازخورد را با هم اجرا کنید، می‌توانید به سرعت کشف کنید که چگونه نرم‌افزار شما می‌تواند ارزش بیشتری خلق کند.

https://bit.ly/3CMMNVw

در چنین شرایطی ممکن است اختلالاتی هم رخ دهد. برخی از سبک‌های توسعه (development styles) روی حلقه “ایده → رفتار → ایده” تمرکز می کنند که باعث می‌شود دور باطلی از پیاده سازی ویژگی‌ها بدون توجه به ساختار سیستم ایجاد گردد. (مترجم؛ چرخ همستر یا دور باطل به فعالیتی گفته می‌شود که با انجام آن، شخص همیشه مشغول است اما هرگز به دستاورد مهم و ارزشمندی دست پیدا نمی‌کند و از سوی دیگر پایانی نیز برای آن فعالیت وجود ندارد.)

https://bit.ly/3Q5VJIj

یکی دیگر از اختلالات، زمانی رخ می‌دهد که قبل از هر گونه پیاده‌سازی، تمام تلاش‌ها صرف تهیه‌ی یک طراحی کامل و بی‌نقص می‌شود (طراحی بزرگِ قبل از پیاده‌سازی، سلام! (Big Design Upfront)) در پی این تلاش‌ها، ساختارهای زیبا و خوش ساخت زیادی ایجاد می‌شوند در حالی که هیچ کاربرد و اهمیتی در پیاده‌سازی رفتارهای مورد نیاز کاربران ندارند. این روش سرمایه‌گذاری روی ساختارها، شما نه‌تنها بازده و منفعتی از سرمایه‌گذاری خود کسب نمی‌کنید بلکه بازخوردها را نیز به تاخیر می‌اندازید.

https://bit.ly/3AFB73W

کنت بک طرفدار و مدافع این موضوع است که یک تکرار ( iteration) سریع باید در تمام حلقه‌های بازخورد بالا وجود داشته باشد. شما باید بتوانید ایده‌ها را به سرعت امتحان کنید، ساختار را به شکلی که برای رفتار جدید مناسب‌تر است تغییر دهید و سپس تغییر رفتار را کامل کنید و به پایان برسانید (گاهی تغییرات طراحی باعث پیشنهاد شدن ایده‌های جدیدی برای سیستم می‌گردد و شما را به مسیر جدیدی هدایت می کند). توانایی انجام این تغییرات در قالب بخش‌ها و تکه‌های کوچک است که ارزشی فوق العاده‌ خلق می‌کند. (مترجم؛ کنت بک اعتقاد دارد پروژه‌ها باید به صورت بخش‌ها و تکه‌های کوچک انجام شوند و درست مانند رانندگی روی یخ، ذره ذره پیش رفت.)

گزیده:
پیشنهاد می‌کنم ۱۰ تا ۲۰ درصد از کل زمان توسعه خود را صرف سرمایه‌گذاری [روی برنامه‌نویسی استراتژیک] کنید. این زمان آن قدر کم است که تأثیر چندانی بر برنامه‌‌ریزی‌ها ندارد، اما آن قدر بزرگ است که بتواند به مرور و در طول زمان، نتایج قابل‌توجهی به بار آورد.»
از کتاب فلسفه طراحی نرم افزار نوشته‌ی جان اوسترهات،

پ.ن.
به دلیل تعدد تصاویر همراه متن، پیشنهاد می‌کنم برای راحتی بیشتر، متن را از وبلاگ مطالعه بفرمایید.

https://www.bibalan.com/?p=4071
https://t.me/bibalan_com
  • ❤ 2
  • 👍 1
Post #285 1.08K
Agile Software Development for Developers

در ابتدای سال ۲۰۲۰ که کووید همه‌گیر شده بود و همه از دانشگاه‌ها و شرکت‌ها به خانه‌ها نقل مکان کرده بودیم، به پیشنهاد و همراهی دوست عزیزم آقا رضای رحمتی و کوشش‌های دوست عزیزم محمد آقای نادی، دوره‌ی «متدهای چابک برای توسعه‌دهندگان نرم‌افزار» را برای کانون برنامه‌نویسان ایرانی مقیم کانادا برگزار کردم.

برای این دوره، بخش‌هایی از متدهای چابک را انتخاب کردم که به گمانم بیشتر مورد استفاده برنامه‌نویسان و توسعه‌دهندگان قرار می‌گیرد. دوره‌ی بسیار جالبی بود؛ هم از این بابت که اولین بار بود که در بسترهای ارتباطی آنلاین دوره‌ای برگزار می‌کردم و هم اینکه مخاطبان دوره، عزیزانی از شرق، مرکز و غرب کانادا بودند.

ویدیوهای این دوره در یوتیوب در دسترس همگان قرار دارد و می‌توانید از طریق آدرس‌های زیر به آنها دسترسی داشته باشید.

در پایان جا دارد از کمک‌های عزیزان و سروران گرامی‌ام آقایان و خانم‌ها، فائزه اشراق، رضا مقدس جعفری، حسین نصیری، رضا رحمتی و محمد نادی برای برگزاری این دوره تشکر و قدردانی نمایم.


Session 1: Agile Software Development in a Nutshell and Cynefin (https://youtu.be/yZLfrMTez4g)
Session 2: Scrum Overview and Product Backlog (https://youtu.be/sJ7V8xgJTv4)
Session 3: Estimation (Part 1) (https://youtu.be/mq_fJ3EjfQE)
Session 4: Estimation (Part 2) (https://youtu.be/TgAJcGHU-C4)
Session 5: Velocity and Release Planning (https://youtu.be/kQypG2RL3lk)
Session 6: Sprint Planning.(https://youtu.be/RBHWDv60Nno)
Session 7: Sprint Execution (https://youtu.be/GtZdiybHJQQ)

گزیده:
«اندازهٔ واقعی آموزش‌یافتگی تو، آن چیزی نیست که می‌دانی، بلکه این است که چطور دانسته‌هایت را با دیگران سهیم شوی.» کنت نربرن

https://www.bibalan.com/?p=4063
https://t.me/bibalan_com
YouTube روشهای چابک برای توسعه دهندگان جلسه 1 Agile for Developers Yousef Mehrdad Bibalan Sprint 1 (Farsi) 𝐀𝐠𝐢𝐥𝐞 𝐒𝐨𝐟𝐭𝐰𝐚𝐫𝐞 𝐃𝐞𝐯𝐞𝐥𝐨𝐩𝐦𝐞𝐧𝐭 𝐢𝐧 𝐚 𝐍𝐮𝐭𝐬𝐡𝐞𝐥𝐥 𝐚𝐧𝐝 𝐂𝐲𝐧𝐞𝐟𝐢𝐧 یوسف مهرداد بی بالان روشهای چابک برای توسعه دهندگان نرم افزار 1 در کانون برنامه نویسان ایرانی در کانادا Agile for Developers Mehrdad Yousef Bibalan Sprint 1(Farsi) 04:38 Quiz 09:30 Manifesto 17:44 Agility…
  • ❤ 6
  • 👍 5
  • 👏 2
  • 🎉 1
Post #284 715
نخست مرتب‌ کنید (tidy first) (۱)

پیش‌گفتار:
مدت‌هاست که می‌خواستم درباره‌ی Tidy First (با تلفظ تایدی) مطلبی بنویسم و این نگرش زیبا و جالب‌توجه را به دوستان عزیزم و خوانندگان وبلاگ معرفی کنم. با این‌که مدت‌هاست آن را دنبال می‌کنم ولی بخت و اقبال در راه ترجمه‌ی آن با من یار نبود. خوش اقبال بودم که حمید آقای عزیزم کمک کرد تا این خواسته جامه‌ی عمل پوشانده شود. با سپاس از ایشان،‌ از شما دعوت می‌کنم که این سری از نوشته‌ها را دنبال نمایید.

گفتار:
کنت بک (Kent Beck) مهندس نرم‌افزار و متولد آمریکا است، او خالق اکس پی (xp یا Extreme Programming )، سخنران اصلی و الهام‌بخش بسیاری از گردهمایی‌ها و کسی است که توسعه‌ی آزمون محور ( TDD یا Test-Driven Development) را دوباره کشف و متحول کرد.

بیت‌روت (Beetroot) مفتخر است که آقای بک، سخنران مهمان یکی از رویدادهای رایگان تک‌تاک‌پلاس (# TechTalk) است. با الهام از دیدگاه او درباره‌ طراحی نرم‌افزار و از آنجا که بهبود مداوم کیفیت توسعه نرم‌افزار در خون ماست، تصمیم گرفتیم برخی از نکات کلیدی صحبت‌های او در این رویداد را با شما در میان بگذاریم. حتما در وبلاگ کنت عضو شوید تا فصل‌های جدید کتاب او را دریافت کنید.

در مورد طراحی نرم افزار
“طراحی نرم افزار فعالیتی در حوزه‌ی روابط انسانی است”. این اولین خطی بود که کنت بک برای عنوان سخنرانی‌اش با عنوان”نخست‌ مرتب‌ کنید (Tidy First) چیست؟”- نوشت. در نگاه اول، توسعه نرم افزار ارتباط چندانی با روابط اجتماعی ندارد و درباره‌ی جفت‌شدگی (coupling)، چسبندگی(cohesion)، قانون توان(power law)، بازسازی (refactoring) و غیره و در یک کلام،‌ درباره‌ی کد است. آیا واقعا طراحی نرم‌افزار ارتباطی با روابط انسانی ندارد؟ با مشاهده طراحی نرم افزار از دریچه‌ی روابط انسانی می‌توان دامنه‌ی بررسی را کوچک‌ کرد و به بررسی تعاملات بین افراد فنی (افراد متخصص یا geek) و افراد غیر فنی (غیر متخصص یا non-geeks) پرداخت.

در شکل زیر، دایره بیرونی مرزی است بین چیزهایی که تحت کنترل افراد فنی است و چیزهایی که تحت کنترل آنها نیست. بِک آنها را “پیشخدمت‌ها” (waiters) و “تغییردهنده‌ها” (changers) می‌نامد. پیشخدمت‌ها درخواست می‌کنند تا در رفتار سیستم تغییری ایجاد شود، در حالی که تغییر کد عملا با تغییردهنده‌ها است. رابطه بین این دو دسته می‌تواند پرتنش باشد، به ویژه زمانی که دو طرف یکدیگر را درک نمی‌کنند. در داخل دایره، مجموعه‌ متفاوتی از روابط وجود دارد؛ در یک تیم نرم افزاری، توسعه‌دهندگان پیوسته با تصمیم‌های خود در طراحی نرم افزار، روی یکدیگر تاثیر می‌گذارند.

https://bit.ly/3PDXufw

نوع سوم رابطه، رابطه هر برنامه نویس با خودش است (برای همین صورتک خندان در وسط دایره قرار دارد). رابطه نامناسب با خودمان باعث می‌شود بارها و بارها کارهای سخت و دشوار را با ابزارهای کند و نامناسب انجام دهیم یا API های بد و نامناسب را تحمل کنیم و با آنها سر و کله بزنیم. به جای چنین‌ کارهایی باید بالاترین اولویت را به رابطه با خودمان اختصاص دهیم و بعد بقیه روابط را به صورت چشمگیری بهبود دهیم. کنت بک می گوید: «تا زمانی که به عنوان یک برنامه نویس با خودم رابطه سالمی نداشته باشم، احتمالاً نمی‌توانم حتی با سایر برنامه نویسان هم روابط سالمی داشته باشم. و این پایه و اساسِ موضوعی است که امروز درباره آن صحبت می‌کنیم، و همین‌طور موضوع کتابی است که مشغول نوشتن آن هستم.» (مترجم: به گفته‌ی جولی هنکس ارتباط سالم با خود (A healthy self-relationship) به معنای توانایی ارزش قائل شدن برای خود به‌عنوان یک انسان و پذیرش نقاط قوت و ضعف خود است.)

مترجم: حمید خاتمی

گزیده:‌
“مشکل دنیا این است که افراد باهوش پر از شک و تردید‌ند، در حالی که احمق‌ها پر از اعتماد به نفس‌اند.” چارلز بوکوفسکی


https://www.bibalan.com/?p=4059
https://t.me/bibalan_com
  • ❤ 5
  • 👍 2
Post #283 267
یادگیری ماشین برای همه (۸)

ادامه طبقه‌بندی …

ماشین‌ بردار پشتیبان (Support Vector Machines) یا SVM به راستی محبوب‌ترین روش طبقه‌بندی کلاسیک است. از آن برای طبقه‌بندی هر موجودی در جهان هستی استفاده می‌شود مانند طبقه‌بندی گیاهان بر اساس شکل ظاهری آنها در عکس‌ یا طبقه‌بندی اسناد بر اساس نوع آنها و…

ایده‌ی پشت SVM بسیار ساده است. SVM سعی می‌کند تا دو خط با بیشترین فاصله‌ی ممکن بین نقاط داده (data points) ترسیم کند. به تصویر زیر نگاه کنید.
https://bit.ly/3QfSaAg

یکی از کاربردهای جنبی و بسیار مفید طبقه‌بندی، تشخیص ناهنجاری (anomaly detection) است. هنگامی که یکی از ویژگی‌های داده در هیچ یک از طبقه‌ها قرار نمی‌گیرد(مترجم؛ مثلا در دسته‌بندی عکس‌ها به عکس سگ و عکس گربه،‌ عکسی از فیل وجود داشته باشد)، آن را برجسته و اعلام می‌کنیم. این روزها از تشخیص ناهنجاری در پزشکی و برای تصاویر MRI استفاده می‌شود. رایانه‌ها تمام مناطق مشکوک به بیماری یا متفاوت با حالت عادی آزمایش را برجسته و گزارش می‌کنند. بازارهای سهام از این تکنیک برای شناسایی رفتار غیرعادی معامله‌گران و پیدا کردن معامله‌گرانی که به صورت غیرقانونی به اطلاعات محرمانه‌ی شرکت‌ها دسترسی دارند استفاده می‌کنند. در اینجا، وقتی می‌خواهیم داده‌های درست را به کامپیوتر آموزش بدهیم در واقع داده‌هایی را به آن آموزش می‌دهیم که در واقع اشتباه و نادرست‌اند (مترجم؛ ما تصاویر پزشکی با علائم غیرعادی و مشکوک به بیماری و هم‌چنین اطلاعات معامله‌گران قانون‌گریز را به ماشین یاد می‌دهیم تا آنها را شناسایی کند).

امروزه معمولا برای طبقه‌بندی، بیشتر از شبکه‌های عصبی (neural networks) استفاده می‌شود. در حقیقت شبکه‌های عصبی اصلا برای همین کار به وجود آمده‌اند.

قاعده کلی (rule of thumb) این است: هر چه داده‌ها پیچیده‌تر، الگوریتم هم پیچیده‌تر. برای داده‌های متنی، عددی و جدولی، من روش‌های کلاسیک را انتخاب می‌کنم. زیرا در روش‌های کلاسیک، مدل‌ها کوچکترند و سریع‌تر یاد می‌گیرند و البته عملکرد آنها شفاف‌تر و قابل‌فهم‌تر است. برای تصاویر ، فیلم و بقیه کلان داده‌های (big data) پیچیده، من قطعاً شبکه‌های عصبی را انتخاب می‌کنم.

تا پنج سال پیش هم می‌شد یک طبقه‌‌بندی‌کننده (classifier) برای دسته‌بندی چهره‌های انسان پیدا کرد که با SVM ساخته شده باشد. اما امروزه برای انجام چنین کاری، راه آسان‌تر این است که از بین صدها شبکه‌ی عصبی‌ که از پیش آموزش دیده‌اند (pre-trained) یکی را انتخاب کنید. اما روش‌های به‌کار رفته در فیلترکننده‌های هرزنامه‌ها (spam filters) هیچ تغییری نکرده‌اند و کماکان با SVM نوشته می‌شوند. و تاکنون هیچ دلیل منطقی و مناسبی برای تغییر آنها پیدا نشده است.
حتی وب سایت شخصی من نیز برای شناسایی هرزنامه‌ها در بخش نظرات (comeents) از SVM استفاده می‌کند. ¯_(ツ)_/¯

مترجم: خانم سپیده مشایخی

گزیده:
از دید من، یادگیری ماشین ابزاری است برای رساندن ما از داده‌ها به احتمالات. اما برای رسیدن از احتمالات به درک واقعی، هنوز دو گام دیگر باید برداشته شود- دو گام بزرگ و مهم. یکی پیش‌بینی اثر اقدامات و دیگری تصور خلاف وابع

جودیا پرل (Judea Pearl)
منبع: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی
  • ❤ 2
Post #282 218
به سفر می روم و بسته به دل مهر وطن
رشته ای از پی باز آمدنم چون ماکو

نعمت هند فراوان بود، اما نرود
یاد گیلان ز دل و حسرت نان لاکو

سلیم تهرانی

عکس: بیجار (مزرعه‌ برنج) در بی‌بالان
عکس از مهدی مهرداد

پانوشت:
نان لاکو؛ نانی رایج در گیلان
https://t.me/bibalan_com
  • ❤ 9
  • 👍 1
Post #281 260
برنامه ۱۲ عاملی (۹)- عامل هشتم: همروندی

عامل ۸- همروندی (Concurrency)
برنامه را از طریق مدل پردازش (process model) مقیاس‌پذیر و بزرگ کنید

هر برنامه کامپیوتری پس از اجرا با یک یا چند پردازش (process) در سیستم عامل نمایش داده می‌شود. برنامه‌های وب شکل‌های مختلفی برای اجرای پردازش پیدا کرده‌اند. به عنوان مثال پردازش‌ها یا برنامه‌های PHP می‌توانند به عنوان فرزندی از پردازش‌های آپاچی اجرا می‌شوند البته در صورت نیاز (on demand) و بسته به میزان حجم درخواست (request). پردازش‌های جاوا رویکردی متضادی دارند، این رویکرد به کمک JVM و ابتدا با استفاده از پردازش غول‌پیکری که بخش بزرگی از منابع سیستم مانند CPU و حافظه را در ابتدا در اختیار می‌گیرد و سپس با مدیریت داخلی همروندی (concurrency) به کمک ریسمان‌ها(thread) انجام می‌شود. در هر دو نمونه یعنی PHP و جاوا، امکانِ دسترسی و مشاهده‌‌ی پردازش‌های در حال اجرا برای توسعه‌دهندگان برنامه در پایین‌ترین میزان خود قرار دارد.

https://bit.ly/3zzO9Qa

پردازش‌ها در برنامه دوازده عاملی اهمیت زیادی دارند و شهروندان درجه‌ یک به حساب می‌آیند. (مترجم؛ در زبان‌های برنامه نویسی، شهروند درجه یک عنصری از زبان است که از تمام عملیات موجود که برای سایر عناصر زبان پشتیبانی می‌کند). خط مشی پردازش‌ها در برنامه دوازده عاملی به شدت از مدل پردازش یونیکس (unix) برای دیمن‌های (deamon) سرویس‌های در حال اجرا اقتباس شده است. (مترجم؛ دیمن، پردازشی از نوع سرویس (service process) که در پس‌زمینه (background) اجرا می‌شود و وظیفه‌ی آن نظارت و رسیدگی به سیستم یا فراهم‌سازی خدماتی برای سایر پردازش‌هاست). توسعه‌دهندگان به کمک این مدل می‌توانند معماری برنامه خود را برای مدیریت اجرای کارهای متنوع و متفاوت به گونه‌ای طراحی کنند که هر نوعی از کارها را به یک نوع پردازش (process type) ویژه‌ محول کنند. به عنوان نمونه، درخواست‌های HTTP توسط یک پردازش وب (web process) مدیریت می‌شود و کاری که در پس‌زمنیه برای طولانی‌مدت باید اجرا شود توسط یک پردازش کارگر(worker process) انجام می‌شود.


چنین رویکردی در مورد تقسیم زمان و تسهیم منابع (multiplexing) داخلیِ پردازش‌های مستقل استثنا قائل نمی‌شود. (مترجم؛ ایجاد منابع متعدد منطقی از یک منبع فیزیکی را مالتی پلکس گویند) . این کار معمولا به کمک ریسمان‌های (thread) داخل ماشین مجازی (VM) یا به کمک مدل async/evented که در ابزارهایی مانند EventMachine، Twisted یا Node.js وجود دارند مدیریت می‌شوند. نکته مهم این است که اندازه‌ی ماشین مجازی می‌تواند تا حد مشخصی افزایش یابد (افزایش عمودی)، بنابراین برنامه باید بتواند با چندین پردازش که روی چندین ماشین فیزیکی در حال اجرا هستند نیز کار کند.

وقتی که زمان مقیاس‌پذیری افقی (scale out) فرا برسد تازه اهمیت مدل پردازش نمایان می‌شود (مترجم؛ scale in به معنای افزایش عمودی منابع و scale out به معنای افزایش افقی آنها است.). اصل «اشتراک‌گذاری صفر»(share-nothing) و ماهیت تقسیم‌پذیری افقیِ پردازش‌های برنامه دوازده عاملی به این معنی است که افزایش همروندی (concurrency) عملیاتی ساده و قابل اتکا است. آرایه ای از نوع پردازش (Process type) و تعداد پردازش‌های موجود از هر نوع با نام شکل گیری پردازش (process formation) شناخته می‌شود.

پردازش‌‌ها در برنامه دوازده عاملی هرگز نباید دیمن‌سازی کنند (daemonize) یا فایل‌های PID (process identifier) را دست کاری کنند (مترجم؛ دیمن‌سازی یک برنامه یا اسکریپت به معنای آماده‌سازی آنها برای اجرا در پس‌زمینه (background) و تبدیل کردن آنها به یک دیمن است).. در عوض، برای مدیریت خروجی‌ها، رسیدگی به پردازش‌های از کار افتاده و مدیریت راه‌اندازی‌های مجدد و خاموش‌ کردن‌هایی که توسط کاربر انجام می‌شوند، باید از مدیریت پردازش‌های سیستم عامل استفاده کنند. از جمله‌ی این ابزارهای مدیریت پردازش‌ می‌توان به systemd در لینوکس، مدیر پردازش توزیع‌شده در پلتفرم‌های ابری یا ابزارهایی که برای توسعه‌دهندگان ساخته‌ شده‌اند مانند Foreman اشاره کرد.

مترجم: حمید آقای خاتمی

گزیده:
«از اژدهای هفت‌سر مترس، از مردم نمام بترس که هرچه وی به ساعتی بشکافد، به سالی نتوان دوخت.» قابوسنامه

https://www.bibalan.com/?p=4040
https://t.me/bibalan_com
  • 👍 1
Post #280 186
یادگیری ماشین برای همه (۷)

ادامه طبقه‌بندی …

بیایید نمونه‌ی عملی دیگری از طبقه‌بندی را با هم بررسی کنیم. فرض کنید شما می‌خواهید مبلغی از بانک وام یا اعتبار بگیرید. چگونه بانک تشخیص می‌دهد که شما وام‌ را بازپرداخت خواهید کرد یا نه؟ قطعا هیچ راهی برای کسب اطمینان صد در صدی وجود ندارد. اما بانک پرونده تعداد زیادی از مشتریان را دارد که قبلا وام گرفته‌اند. بانک اطلاعات مربوط به سن، تحصیلات، شغل و حقوق و مهم‌تر از همه این‌که وام را بازپرداخت کرده‌اند یا خیر را دارد.
با استفاده از این داده‌ها می‌توانیم روش یافتن الگوها (pattern) و پیدا کردن پاسخ این سوال را به ماشین آموزش دهیم. در اینجا مشکل خاصی برای پیدا کردن پاسخ وجود ندارد. موضوع اصلی این است که بانک نمی‌تواند کورکورانه به پاسخ ماشین اعتماد کند. زیرا ممکن است خرابی سیستم (system failure) یا حمله هکرها اتفاق افتاده باشد یا حتی ممکن است کارمند سالخورده‌ای که در
وضعیت سرخوشی (drunk) است با راهکار سریع‌اش برای رفع خطا (quick fix) باعث خرابی سیستم شده باشد.

https://bit.ly/3zEGSQb

برای حل این گونه مسائل از درخت تصمیم (Decision Tree) استفاده می‌شود (اینجا را هم ببیند https://bit.ly/3PZNLRl ).

تمام داده‌ها به صورت خودکار به سوالات بله/خیر تقسیم می‌شوند برای مثال «آیا درآمد وام‌گیرنده بیش از ۱۲۸.۱۲ دلار است؟». چنین کاری ‌می‌تواند از نگاه انسان‌ها کمی عجیب به نظر برسد. با این
حال، ماشین چنین سوالاتی را مطرح می‌کند تا داده‌ها را در هر گام به بهترین شکل تقسیم کند.

با این روش، درخت تصمیم ساخته می‌شود. هرچه ارتفاع درخت بیشتر باشد (مترجم؛ به شکل نگاه کنید) به این معناست که سوال‌ها گسترده‌تر هستند. هر تحلیلگری می‌تواند درخت را ببیند و آن را توضیح دهد. ممکن است منطق آن را درک نکند اما به راحتی می‌تواند آن را توضیح دهد! (منظور من تحلیل‌گرهای معمولی‌اند)
درخت‌ تصمیم به طور گسترده‌ای در حوزه‌های پرمسئولیتی مانند تشخیص بیماری، پزشکی و امور مالی استفاده می‌شوند.
امروزه به ندرت از درخت تصمیم به تنهایی و بدون ترکیب با سایر تکنیک‌ها استفاده می‌شود. با این حال، آنها معمولا پایه و اساس سیستم‌های بزرگ را تشکیل می‌دهند و ترکیب گروهی از آنها حتی بهتر
از شبکه‌های عصبی کار می‌کند. بعداً در این مورد صحبت خواهیم کرد.

وقتی عبارتی را در گوگل جستجو می‌کنید دقیقا گروهی درخت تصمیم وجود دارند که دنبال طیف وسیعی از پاسخ‌ها می‌گردند. موتورهای جستجو به دلیل سرعت بالا، عاشق درخت‌‌های تصمیم هستند.
دو مورد از الگوریتم‌های معروف برای ساختن درخت CART و C4.5 هستند.

مترجم: خانم سپیده مشایخی

گزیده:
من به تازگی از توماسو پوجیو، یکی از پیشگامان علم عصب‌شناسی مدرن، پرسیدم که آیا نگران نیست که رایانه‌ها با قدرت پردازشی فزاینده‌ای که دارند به زودی بتوانند به تقلید از کارکرد مغز انسان بپردازند؟ او پاسخ داد: هیچ بختی ندارند.

ست لوید (Seth Lloyd)
منبع: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی

https://www.bibalan.com/?p=4034
https://t.me/bibalan_com
  • 👍 3
Post #279 191
یادگیری ماشین برای همه (۶)

۱-۱-۱-طبقه‌بندی (Classification)
تعریف:‌ طبقه‌بندی عبارت است از تقسیم اشیاء بر اساس یکی از خصیصه‌های (attribute) از پیش تعیین‌شده. برای نمونه تقسیم جوراب‌ها بر اساس رنگ آنها، تقسیم اسناد و مدارک بر اساس زبان نوشتاری یا تقسیم آهنگ‌ها بر اساس ژانر (genre) آنها

https://bit.ly/3yZKpHk

کاربردها:
– شناسایی و فیلتر هرزنامه‌ (Spam filtering)
– تشخیص زبان (Language detection)
– پیدا کردن اسناد مشابه (A search of similar documents)
–تحلیل احساسات (Sentiment analysis)
– شناسایی حروف و اعداد دست‌نویس (Recognition of handwritten characters and numbers)
– تشخیص تقلب (Fraud detection)


الگوریتم‌های محبوب:
بیز ساده (Naive Bayes)
درخت تصمیم (Decision Tree)
رگرسیون لجستیک (Logistic Regression)
کی-نزدیکترین همسایه (K-Nearest Neighbors یا K-NN)
ماشین بردار پشتیبان (Support Vector Machine یا SVM)

از اینجا به بعد می‌توانید با اطلاعات خود در مورد این بخش‌ها اظهار نظر کنید. اگر دوست داشتید می‌توانید نمونه‌ها و مثال‌های خود را درباره‌ی هر یک از کارها و وظایف (task) یادگیری ماشین بیان کنید. این بخش بر اساس تجربیات شخصی‌ام نوشته شده است.

یادگیری ماشین معمولا درباره طبقه‌بندی موضوعات است. در طبقه‌بندی، ماشین مانند کودکی است که در حال یادگیری مرتب کردن اسباب بازی‌های خود است: این یه رباته، این هم یه ماشینه، (با دیدن ماشین بدون راننده) این هم یه … این چیه؟ … اوه! اوه! صبر کنید. اشتباهه! اشتباهه!
در طبقه‌بندی، شما همواره به یک معلم نیاز دارید. داده‌ها‌ باید با ویژگی‌ها (features) برچسب‌گذاری شوند تا ماشین بتواند دسته‌ها (class) را بر اساس آنها تعیین کند. همه چیز را می‌توان طبقه‌بندی کرد: طبقه‌بندی کاربران را بر اساس علایق (مانند کارکرد فیدهای الگوریتمی) (مترجم. فیدهای الگوریتمی یا algorithmic feed، الگوریتم‌های شبکه‌های اجتماعی‌اند که مطالب مورد علاقه‌ی کاربر را پیش‌بینی می‌کنند. به عبارت دیگر به جای نمایش پست‌های جدید به ترتیب زمان انتشار آنها، شبکه اجتماعی مطالبی را به کاربر نشان می‌دهد که بر اساس علایق وی پیش‌بینی و انتخاب کرده است) ، طبقه‌بندی مقالات بر اساس زبان و موضوع (topic) (که برای موتورهای جستجو با اهمیت است) ، طبقه‌بندی موسیقی مبتنی بر ژانر (مانند لیست پخش Spotify) و حتی طبقه‌بندی ایمیل‌های شما

https://bit.ly/3zpeG3v

در شناسایی و فیلتر هرزنامه‌ها از الگوریتم بیز ساده (Naive Bayes ) به شکل گسترده‌ای استفاده شده است. ماشین تعداد تکرار نام یک واژه غیرمجاز را در هرزنامه‌ها و ایمیل‌های عادی می‌شمارد و
احتمال (probability) آنها را حساب می‌کند. سپس با استفاده از معادله بیز آنها را ضرب و جمع انجام می‌دهد و تعیین می‌کند که پیام دریافتی هرزنامه است یا یک پیام عادی. خوب تمام شد و ما به یک مدل یادگیری ماشین دست پیدا کردیم (مترجم. اساس معادله بیز، احتمال شرطی است که در آن از داده‌هایی مانند احتمال وجود یک کلمه در پیام‌های عادی و در هرزنامه‌ها و هم‌چنین احتمال اینکه یک پیام، هرزنامه باشد یا پیام عادی استفاده می‌شود).


بعدها ارسال‌کنندگان هرزنامه یاد گرفتند که چگونه با افزودن تعداد زیادی کلمه‌ «خوب» در پایان ایمیل، فیلترهای بیز رو به رو شوند. به کنایه به این روش، مسمومیت بیز (Bayesian poisoning) گفته می‌شود. بیز ساده به عنوان ظریف‌ترین و از نظر کاربردی اولین الگوریتم در تاریخ ثبت شد. اما اکنون از الگوریتم های دیگر برای شناسایی و فیلتر هرزنامه‌ها استفاده می‌شود.

مترجم: خانم سپیده مشایخی

گزیده:
بهترین شطرنج‌بازان جهان، نه رایانه‌ها هستند و نه انسان‌ها، بلکه انسان‌هایی هستند که با رایانه‌ها کار می‌کنند.
جان بروکمن

منبع گزیده: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی
https://bit.ly/3o46tv9

https://www.bibalan.com/?p=4027
https://t.me/bibalan_com
  • 🤩 1
Post #278 186
گپ و گفت‌های هوش مصنوعی (۲)

من کاربران بسیاری را دیده‌ام که می‌گویند «خوب [مدل] کار می‌کند اما نمی‌دانم چرا.» اگر یادگیری عمیق را بر روی حجم عظیمی از داده‌ها به کار بندید، پویایی خاص خودش را دارد. خودش را اصلاح و بهینه‌سازی می‌کند و در اغلب اوقات نتایج صحیح را در اختیارتان می‌گذارد. اما اگر چنین نکرد، شما سرنخی ندارید که چه چیزی اشتباه بود و چه چیزی باید درست شود. به ویژه، شما نمی‌دانید که اشتباه در برنامه بود یا در روش و یا به خاطر این که عوامل محیط تغییر کرده‌اند. ما باید نوع دیگری از شفافیت را هدف قرار دهیم.

از دید من، یادگیری ماشین ابزاری است برای رساندن ما از داده‌ها به احتمالات. اما برای رسیدن از احتمالات به درک واقعی، هنوز دو گام دیگر باید برداشته شود – دو گام بزرگ و مهم. یکی پیش‌بینی اثر اقدامات و دیگری تصور خلاف واقع. تا وقتی که دو گام آخر را برنداشته‌ایم، نمی‌توانیم ادعا کنیم که به درک واقعیت نائل آمده‌ایم.

جودیا پرل (Judea Pearl)

منبع: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی، فصل ۲
نوشته جان بروکمن، ترجمه استاد گرامی ابراهیم نقیب‌زاده مشایخ

آدرس کتاب:‌
https://bit.ly/3o46tv9


https://www.bibalan.com/?p=4021
https://t.me/bibalan_com
  • ❤ 1
Post #277 210
گپ و گفت‌های هوش مصنوعی (۱)


در میان بسیاری از موضوعات مطرح شده در کتاب «استفاده انسانی از انسان‌ها» [The Human Use of Human Beings] نوشته وینر (۱۹۵۰) [Norbert Wiener] که هم‌اکنون نیز مربوطند، مهم‌ترین آنها برای پژوهشگران هوش مصنوعی این احتمال است که انسان، کنترل خود بر روی سرنوشتش را به ماشین واگذار کند.

وینر ماشین‌های آینده نزدیک را خیلی محدودتر و ضعیف‌تر از آن می‌دانست که بتوانند کنترل جهانی را به دست گیرند. در عوض، تصور او چنین بود که ماشین‌ها و سامانه‌های کنترل ماشینی توسط انسان‌های نخبه برای استفاده ابزاری از توده مردم به کار گرفته خواهد شد.

استوارت راسل

منبع: کتاب تراوش‌های ذهنی، ۲۵ شیوه نگرش به هوش مصنوعی، فصل ۳
نوشته جان بروکمن، ترجمه استاد گرامی ابراهیم نقیب‌زاده مشایخ


آدرس کتاب:‌.
https://bit.ly/3o46tv9


https://www.bibalan.com/?p=4017
https://t.me/bibalan_com
Post #276 204
یادگیری ماشین برای همه (۵)

نقشه‌ی دنیای یادگیری ماشین
اگر حوصله خواندن مطالب طولانی را ندارید، برای فهمیدن مفاهیم به تصویر زیر نگاهی بیندازید.

https://bit.ly/3atjsn6

یکی از نکات مهمی که همواره باید به خاطر داشت این است که برای هر مساله در دنیای یادگیری ماشین، فقط و فقط یک راه‌حل وجود ندارد. معمولا چندین الگوریتم مناسب برای مساله وجود دارد و شما باید انتخاب کنید که کدام یک از آنها بهتر است. بی‌شک همه مسائل را می‌توان با شبکه‌های عصبی حل کرد اما چه کسی هزینه‌ی تامین GeForceها را پرداخت کند. [برای استفاده از شبکه‌های عصبی نیاز به پردازنده‌های بسیار قوی است و GeForce یکی از این پردازنده‌ها است که محصول شرکت Nvidia است؛ مترجم].
بیایید با مرور کلی دنیای یادگیری ماشین شروع کنیم. امروزه چهار شاخه اصلی در یادگیری ماشین وجود دارد.

۱- یادگیری ماشین کلاسیک (Classical Machine Learning)
اولین روش‌های یادگیری ماشین در دهه ۵۰ میلادی از آمار نظری پدید آمدند. آنها مساله‌های ریاضی آکادمیک مانند جستجوی الگوها (patterns) در اعداد، محاسبه‌ی نزدیکی نقطه داده‌‌ها ( proximity of data points) و محاسبه جهت بردارها (vectors) را حل کردند.

امروزه نیمی از اینترنت بر اساس این الگوریتم‌ها کار می‌کنند. وقتی موقع خواندن اخبار و مقالات با انتخاب گزینه‌ی “بعدی” فهرستی از اخبار و مقالات به شما نشان داده می‌شود یا وقتی کارت‌تان توسط بانک به دلایل امنیتی و به خاطر استفاده در پمپ بنزینی وسط ناکجاآباد مسدود می‌شود، احتمالا کار یکی از همین رفقای فسقلی است.
شرکت های بزرگ فناوری طرفدار دو آتیشه شبکه‌های عصبی‌اند. برای آنها بهبود ۲ درصدیِ دقت مدل به معنای افزایش ۲ میلیاردیِ درآمد است. اما برای شرکت‌های کوچک چنین موضوعی منطقی به نظر نمی‌رسد. من داستان‌هایی درباره تیم‌هایی شنیده‌ام که یک سال از وقت خود را صرف پیاده‌سازی الگوریتم جدیدی کرده‌اند تا در صفحه‌ی اصلی وب سایت، محصولاتی را برای خرید به کاربران پیشنهاد کند و بعد از یک سال متوجه‌ شده‌اند که ۹۹٪ ترافیک سایت‌ از موتورهای جستجو می‌آید. الگوریتم‌های پیاده‌سازی‌شده عملا بی‌فایده بودند چون بیشتر کاربران حتی صفحه اصلی سایت را باز نمی‌کردند.
با وجود محبوبیت، رویکردهای کلاسیک آن قدر ساده‌اند که می توان آنها را به راحتی به کودکان توضیح داد. آنها شبیه ریاضیات پایه‌اند و ما بدون آنکه فکرمان را درگیر آنها کنیم، هر روز از آنها استفاده می کنیم.

۱.۱- یادگیری تحت نظارت (Supervised Learning)
یادگیری ماشین کلاسیک اغلب به دو دسته تقسیم می‌شود: یادگیری تحت نظارت (Supervised Learning) و یادگیری بدون نظارت (Unsupervised Learning)
در یادگیری تحت نظارت،‌ ماشین یک «سرپرست»(supervisor) یا «معلم»(teacher) دارد که تمام پاسخ‌ها را در اختیارش قرار می‌دهد برای مثال برای هر عکس مشخص می‌کند که این عکسِ گربه است یا عکس سگ. معلم قبلاً داده‌ها را به دو دسته‌ی عکس گربه‌ها و عکس سگ‌ها تقسیم‌ کرده است (برچسب‌ یا label زده است ). و ماشین از این نمونه‌ها برای یادگیری استفاده می‌کند: یکی یکی و سگ‌ها جدا گربه‌ها جدا.
یادگیری بدون نظارت به این شکل است که انبوهی از عکس حیوان‌ها را در اختیار ماشین قرار می‌دهیم و وظیفه‌ی ماشین این است که به تنهایی و بدون معلم،‌ عکس هر حیوانی (عکس‌های مشابه) را پیدا کند. در این روش، داده‌ها برچسب‌ (label) ندارند و معلمی هم وجود ندارد، ماشین تلاش می‌کند تا به تنهایی الگوها را پیدا کند. در مورد این روش‌ها در ادامه صحبت خواهیم کرد.
بدیهی است که ماشین با کمک معلم سریع‌تر یاد خواهد گرفت از این رو در کارهای (task) واقعی بیشتر از یادگیری تحت نظارت استفاده می‌شود. این کارها (tasks) به دو دسته‌ تقسیم می‌شوند: طبقه‌بندی (classification) که در آن، دسته‌ای که یک شی (object) به آن تعلق دارد پیش‌بینی می‌شود و رگرسیون (regression) که در آن، نقطه‌ای معین روی محور‌های عددی پیش‌بینی می‌شود.

مترجم: خانم سپیده مشایخی

گزیده:
«اگر بخواهم پیام این کتاب را در یک عبارت مختصر و مفید بیان کنم این است که شما باهوش‌تر از داده‌هایتان هستید. داده‌ها نمی‌توانند علت و معلول (causes and effects) را درک کنند، اما انسان‌ها می‌توانند.»
– جودیا پرل، کتاب چرا: علم جدید علت و معلول


https://www.bibalan.com/?p=4008
https://t.me/bibalan_com
  • ❤ 2
Post #275 185
به شکوفه‌ها ، به باران، برسان سلام ما را

https://bit.ly/3yNU5FK

این عکس زیبا و پیام پایین آن را یکی از دوستان بسیار عزیزم که جنوبی است برای من فرستاده. این عکس ورودی جاده بی‌بالان است. این دوست باصفا در سفری که به شمال داشت وقتی از اینجا رد می‌شده بزرگوارانه به یادم بود و این عکس را گرفته‌ و از طریق شبکه‌های اجتماعی برایم فرستاده‌ تا باعث خوشحالی‌ام شود. قابل گفتن نیست که با دیدن این عکس چقدر حالم خوب شد.
و اما بخوانید ادامه پیام‌های ما را:

من:‌ به‌به، به سلامتی و خوشی. کجا رفته بودید؟‌ ویزا داشتید؟ 🙂 🙂 (من به شوخی به دوستانم می‌گویم که برای ورود به بی‌بالان باید ویزا داشته باشید 🙂 )

دوستم: با ری‌بن بودم. کسی چیزی نپرسید 🙂 😉 . (برای دوست جنوبی و خونگرم من،‌ عینک ری‌بن جایگاه ویژه دارد)

من: می‌خواهم این عکس را در وبلاگ منتشر کنم. می‌توانم با اسم یا اسم خانوادگی یا هیچ‌کدام منتشر کنم.

دوستم:‌ می‌دونید که اسم کوچک من unique identifier است. فقط در قیاس با ترکیب اسم و فامیل که guid است، کمی بهتره 😀. هر جور صلاح می‌دونید.

توضیح: من تا حالا کسی همنام با دوستم ندیده‌ام! تو دنیای من واقعا «تکه» و «لنگه نداره»، هم از نظر شخصیت و هم از نظر اسم!

گزیده:
گیلان، ای سرزمین سبزه خوش‌رنگ
دورم من از تو، گر هزاران فرسنگ
زیر بلندآسمانِ آبی و زیبا
نیست دلم دور از آن بهشتِ دلارا

گلچین گیلانی

https://www.bibalan.com/?p=4001
https://t.me/bibalan_com
  • ❤ 8
  • 👍 1
  • 👏 1
Post #274 186
یادگیری ماشین برای همه (۴)

۳) یادگیری (Learning) در مقابل هوش (Intelligence)

یک بار در یکی از وب سایت های رسانه‌ای باکلاس مطلبی دیدم با عنوان “آیا شبکه های عصبی (neural networks) جایگزین یادگیری ماشین (machine learning) می شوند؟” معمولا رفقای رسانه‌ای معمولا به هر رگرسیون خطی ساده و بی‌اهمیتی مانند SkyNet هوش مصنوعی می‌گویند. شکل زیر تصویر ساده‌ای از دسته‌بندی‌ حوزه‌ی هوش مصنوعی نشان می‌دهد .

https://bit.ly/3P0dQPI

هوش مصنوعی (Artificial intelligence) نامی است که برای کل دانش این حوزه استفاده می‌شود. شبیه واژه‌های زیست شناسی [علم شیوه‌ی زندگی جانداران] یا شیمی [علم بررسی عناصر و مواد] که به کل دانش بشری در شاخه‌ای از علم اشاره دارند.

یادگیری ماشین (Machine Learning) بخشی از هوش مصنوعی است. البته یکی از بخش‌های مهم آن است ولی تنها بخش آن نیست.

شبکه‌های عصبی (Neural Networks) یکی از انواع یادگیری ماشین و البته یکی از انواع محبوب و پرطرفدار آن است. اما بچه‌های خوب دیگری هم در این گروه حضور دارند.

یادگیری عمیق (Deep Learning) روش مدرنی برای ساخت (build)، آموزش (train) و استفاده از شبکه‌های عصبی است. به طور کلی یادگیری عمیق یک معماری جدید در یادگیری ماشین است. امروزه عملا کسی تفکیکی بین یادگیری عمیق و “شبکه‌های معمولی” قائل نیست حتی از کتابخانه‌های (libraries) یکسانی برای پیاده‌سازی آنها استفاده می‌شود. برای آن که خیلی احمق و بی‌سواد به نظر نرسیم بهتر است در گفتار و نوشتار فقط نوع شبکه را بیان کنیم و از به کار بردن کلمات قلمبه سلمبه و مد روز پرهیز کنیم.

[برای نام‌گذاری این معماری جدید که بر اساس شبکه‌های عصبی طراحی شده بود از عبارت “عمیق” استفاده شد تا تفاوت آن را با “شبکه‌های معمولی” و موجود در آن زمان را نشان دهد؛ مترجم].

قاعده کلی برای مقایسه این است که مفاهیمی که در یک سطح (level) مشترک قرار دادند و اصطلاحا هم‌سطح‌اند با هم مقایسه شوند. به همین دلیل عبارت “شبکه‌های عصبی جایگزین یادگیری ماشین خواهد شد”.به این معنی است که “چرخ‌ها جایگزین خودرو‌ها خواهند شد.” رسانه‌‌ها‌ی عزیز! انتشار چنین مطالبی، آبرو و شهرت شما را واقعا به خطر خواهد انداخت.


خلاصه‌ای از توانایی و ناتوانایی ماشین‌ها به شرح زیر است:
ماشین می‌تواند پیش بینی کند (Forecast) ولی نمی‌تواند چیز جدیدی خلق کند (Create)
ماشین می‌تواند حفظ کند (Memorize) ولی نمی‌تواند خیلی سریع باهوش شود
ماشین می‌تواند دوباره تولید کند (Reproduce) ولی نمی‌تواند کاری فراتر از از وظیفه‌‌‌ی (task) تعریف‌شده‌اش انجام دهد
ماشین می‌تواند بهترین گزینه را انتخاب کند ولی نمی‌تواند انسان‌ها را بکشد

مترجم: خانم سپیده مشایخی

گزیده:
آنهایی که مالک داده‌اند مالک آینده‌اند.
(those who own the data own the future)
یووال نوح هراری، ۲۱ درس برای قرن ۲۱‌

https://www.bibalan.com/?p=3991
https://t.me/bibalan_com
  • 👍 4
  • ❤ 1
Post #273 378
برنامه ۱۲ عاملی (۸)- عامل هفتم: اتصال به پورت

عامل ۷-سرویس‌ها را از طریق اتصال به پورت (port binding) در اختیار استفاده‌کنندگان بیرونی‌ قرار دهید
[ مترجم؛ برگردان Port به فارسی درگاه است ولی در این متن همان واژ‌ه‌ی پورت استفاده شده است.]

گاهی برنامه‌های وب در داخل یک کانتینر سرویس‌دهنده‌ وب (web-server container) اجرا می‌شوند. برای مثال، برنامه‌های PHP می‌توانند به عنوان یک ماژول داخل apache HTTPD اجرا شوند یا برنامه‌های جاوا می‌توانند داخل Tomcat اجرا شوند.

برنامه‌های 12 عاملی کاملا خودکفا و بی‌نیاز از کانتینر سرویس‌دهنده‌های وب هستند (self-contained). آنها برای ایجاد سرویسی که در محیط اجرا از طریق وب در دسترس باشد (web-facing service) نیازی به سرویس‌دهنده وب (web server) که در زمان اجرا در اختیار آن قرار گیرد ندارند. برنامه وب ۱۲ عاملی، HTTP را به کمک اتصال به پورت (Port Binding) به‌ عنوان یک سرویس در اختیار استفاده‌کنندگان بیرونی قرار می‌دهد و سپس منتظر دریافت درخواست‌هایی می‌ماند که روی آن پورت ارسال می‌شوند.
[مترجم؛ در متن اصلی از واژه‌ی Runtime Injection برای فراهم کردن سرویس‌دهنده وب مورد نیاز برنامه استفاده شده است]

در محیط توسعه شخصی (local development environment)، توسعه‌دهندگان برای دسترسی به سرویسی که توسط برنامه‌ در اختیار استفاده‌کنندگان بیرونی قرار گرفته فقط به سراغ آدرسی شبیه به ‘http://localhost:5000/’ می‌روند. اما در محیط استقرار، یک لایه مسیریابی (routing layer) وظیفه‌ی هدایت درخواست‌های دریافتی روی یک نام میزبان عمومی (public-facing hostname) به برنامه را بر عهده می‌گیرد. ارتباط لایه‌ مسیریابی با برنامه توسط پورت مذکور برقرار می‌گردد.

معمولا برای پیاده‌سازی این ویژگی از اعلان وابستگی (dependency declaration) برای اضافه کردن سرویس‌دهنده‌ی وب به برنامه استفاده می‌شود. [برای اطلاعات بیشتر رجوع کنید به عامل دوم در برنامه‌های ۱۲ عاملی یعنی وابستگی‌ها؛ مترجم]
HTTP تنها سرویسی نیست که می‌توان به کمک اتصال به پورت در اختیار استفاده‌کنندگان قرار داد. تقریباً همه‌ی نرم‌افزارهای سرویس‌دهنده‌‌ (server software) می‌تواند به کمک اتصال به پورت و سپس انتظار و پاسخ به درخواست‌های دریافتی اجرا شوند. به عنوان مثال می‌توان به Redis یا Remote Dictionary Server اشاره کرد.
توجه داشته باشید که روش اتصال به پورت به این معناست که یک برنامه می‌تواند تبدیل به یک سرویس کمکی (backing service) برای سایر برنامه‌‌ها شود. برای این کار آدرس (URL) ارائه‌شده توسط برنامه‌‌ در قالب یک منبع (Resource Handle) در پیکربندی (config) برنامه‌‌ای که می‌خواهد از آن استفاده کند قرار داده می‌شود.

مترجم: حمید آقای خاتمی

گزیده:
طراحی خوب رایگان نیست و باید برای آن هزینه کنید. شما باید مداوم روی آن سرمایه‌گذاری کنید تا از انباشته‌شدن مشکلات کوچک و تبدیل آنها به مشکلات بزرگ جلوگیری کنید. خوشبختانه طراحی خوب در نهایت هزینه‌های خود را پرداخت می‌کند، زودتر از آن چه فکرش را می‌کنید.
جان اوسترهوت، فلسفه‌ی طراحی

https://www.bibalan.com/?p=3986
https://t.me/bibalan_com
Telegram سماموس: نوشته‌های یوسف مهرداد بی‌بالان این کانال برای اطلاع‌رسانی نوشته‌های وبلاگ سماموس (bibalan.com) ایجاد شده است. مطالب پس از انتشار در وبلاگ، در این کانال نیز منتشر خواهد شد. امیدوارم که مطالب آن برای شما مفید باشد و خوشحال خواهم شد تا نظرات و بازخوردهای شما عزیزان را دریافت کنم.
  • ❤ 3
  • 👍 1
Post #272 178
مدل پالم(PaLM) یکی از آخرین دستاوردهای گوگل در هوش مصنوعی و پردازش زبان طبیعی است. گوگل قصد دارد مدلی بسازد که نه‌تنها بتواند چندین کار را انجام دهد بلکه بتواند ترکیبی از کارها را نیز با هم بر عهده بگیرد. تا پیش از این مدل‌هایی که ساخته می‌شدند یا یک کار را انجام می‌دادند تا تعداد محدودی از کارها.

یکی از کارهایی که در زمینه یادگیری ماشین انجام می‌شود به حوزه‌ی برنامه‌نویسی بر می‌گردد. برای نمونه می‌توان به کارهای زیر در این حوزه اشاره کرد:
- دریافت مساله به زبان طبیعی و تحویل کد آن به یک زبان برنامه‌نویسی

- تبدیل کد از یک زبان برنامه‌نویسی به یک زبان برنامه‌نویسی دیگر

در تصویر بالا نمونه‌هایی از خروجی‌های مدل پالم را می‌توانید ببینید. نکته‌ی مهمی که در مورد این مدل غول‌آسا باید بدانیم این است که برای آموختن کارهای جدید به آن، بر خلاف گذشته نیازی به آموزش حجم زیادی از داده‌ها به مدل نیست و این مدل می‌تواند با اندک آموزشی کارهای جدیدی را یاد بگیرد.

حالا سوال اینجاست که با پیشرفت این تکنولوژی، در آینده‌ برنامه‌نویسی به چه سمت و سویی خواهد رفت.

عکس: bit.ly/3mIOzgT
https://t.me/bibalan_com
  • 🔥 2
  • 👍 1
Post #271 164
برنامه ۱۲ عاملی (۷)- عامل ششم: پردازش

عامل ۶: پردازش‌ها (process)

برنامه را به صورت یک یا چند پردازش بدون حالت (stateless processes) اجرا کنید.

برنامه‌ها در محیط اجرا به صورت یک یا چند پردازش اجرا می‌شوند.

در ساده‌ترین حالت، کد برنامه شامل چندین خط است که با یک زبان برنامه‌نویسی نوشته شد و به تنهایی و بدون نیاز به اجزای خارجی می‌تواند اجرا شود؛ محیط اجرای برنامه نیز لپ‌تاپ توسعه‌دهنده‌ای است که محیط اجرای آن زبان روی آن آماده ‌شده است؛ پردازش (Process) هم با نوشتن دستور در خط فرمان(command line) اجرا می‌شود. به عنوان مثال با نوشتن دستور python my_script.pyُ پایتون برنامه‌ی شما را با ایجاد یک پردازش جدید در کامپیوتر اجرا خواهد کرد. از سوی دیگر، استقرار یک برنامه‌ی پیچیده در محیط عملیاتی ممکن است به چندین نوع پردازش‌ نیاز داشته باشد. توجه داشته باشید که از هریک از انواع می‌تواند چندین نسخه در حال اجرا وجود داشته باشد .

پردازش‌های دوازده عاملی بدون حالت (Stateless) هستند و هیچ چیزی را با دیگران به اشتراک نمی‌گذارند (Share Nothing). اگر داده‌ای نیاز به ثبت و نگهداری داشته باشد،‌ باید آن را در یک سرویس کمکی (backing service) که دارای حالت است (stateful) ذخیره کرد. این سرویس کمکی معمولاً یک پایگاه داده (database) است.

توضیح تکمیلی از سایت ردهت (اینجا):
اصل پردازش‌ها که بهتر است آن را پردازش‌های بدون حالت (Stateless Processes) نامید، ادعا می‌کند برنامه‌ی ۱۲ عاملی باید به صورت مجموعه‌ای از پردازش‌های بدون حالت اجرا شود. این بدان معناست که هیچ پردازشی خبری از وضعیت پردازش‌‌های دیگر ندارد و به هیچ اطلاعاتی از سایر پردازش‌ها مانند وضعیت نشست (session state) یا وضعیت گردش‌کار (workflow state) دسترسی ندارد و آنها را دنبال نمی‌کند.
وجود پردازش‌های بدون حالت، مقیاس‌پذیری (scaling) را آسان‌تر می‌کنند. اگر پردازشی بدون حالت باشد می‌توان در هر لحظه، تعداد نسخه‌های در حال اجرای آن را اضافه یا حذف کرد و به کمک
آن بار (load) روی سیستم را مدیریت کرد. از آنجایی که هر پردازش مستقل از بقیه کار می‌کند، بدون حالت بودن کمک می‌کند تا از وقوع پیامدهای ناخواسته جلوگیری شود.

مترجم: حمید آقای خاتمی

گزیده:
هرگز به آینده اجازه نده که مزاحم امروز تو شود. تو با آینده، اگر مجبور باشی، با همان سلاح عقلانیتی که امروز سپر توست رو به رو خواهی شد.
مارکوس آئورلیوس

https://t.me/bibalan_com
https://www.bibalan.com/?p=3973
Telegram سماموس: نوشته‌های یوسف مهرداد بی‌بالان این کانال برای اطلاع‌رسانی نوشته‌های وبلاگ سماموس (bibalan.com) ایجاد شده است. مطالب پس از انتشار در وبلاگ، در این کانال نیز منتشر خواهد شد. امیدوارم که مطالب آن برای شما مفید باشد و خوشحال خواهم شد تا نظرات و بازخوردهای شما عزیزان را دریافت کنم.
  • 👍 2
Post #270 162
یادگیری ماشین برای همه (۳)

۲) سه مؤلفه یادگیری ماشین
۱-۲) داده‌ها (Data)
در نوشته قبل مطالعه نمایید.

۲-۲) ویژگی‌ها (Features)
ویژگی‌ها با نام پارامترها(parameters) یا متغیرها (variables) نیز شناخته می شوند. کارکرد خودرو، جنسیت کاربر، قیمت سهام، تعداد تکرار کلمه در یک متن نمونه‌هایی از ویژگی‌ها هستند. به عبارت دیگر،
ویژگی‌ها عامل‌هایی‌اند که ماشین برای پیدا کردن الگوها آنها را بررسی می‌کند.

وقتی داده‌ها در جدول ذخیره شده باشند، پیدا کردن ویژگی‌ها ساده است، هر ویژگی معادل یکی از ستون‌های جدول است. اما اگر 100 گیگابایت تصویر از گربه‌ها داشته باشید چه چیزهایی را به عنوان ویژگی‌ انتخاب می‌کنید؟ بی‌شک نمی‌توان هر پیکسل از تصویر را یک ویژگی در نظر بگیریم. به همین دلیل است که انتخاب ویژگی‌های درست معمولاً بیشتر از سایر بخش‌های یادگیری ماشین طول می‌کشد. و همین انتخاب ویژگی‌ها نیز یکی از دلایل اصلی بروز خطاها و اشتباهات در کارهای یادگیری ماشین است.

انسان‌ها معمولا بر اساس تفکر و تحلیل خود عمل می‌کنند.آنها فقط ویژگی‌هایی راانتخاب می‌کنند که به آنها علاقه دارند یا فکر می‌کنند “مهم تر” از بقیه‌اند. لطفا در انتخاب ویژگی‌ها تمایلات و احساسات انسانی را کنار بگذارید.

۳-۲) الگوریتم‌ها (Algorithms)
الگوریتم‌ها بدیهی‌ترین بخش یادگیری ماشین هستند. هر مساله‌ی یادگیری ماشین را می‌توان با روش‌های متفاوتی حل کرد. روش انتخابی شما بر دقت، کارایی و اندازه‌ی مدل نهایی تأثیرگذار خواهد بود.

به این نکته مهم دقت کنید: اگر داده‌ها نادرست باشند بهترین الگوریتم‌ها هم کمکی به حل مساله نخواهد کرد. به این نکته‌ی مهم گاهی به اختصار «ورودی آشغال-خروجی آشغال» (garbage in – garbage out) گفته می‌شود. بنابراین بیش از حد دنبال به دقت مدل (accuracy)که به صورت درصد بیان می‌شود توجه نکنید، تلاش کنید در ابتدای کار، داده‌های بیشتری آماده کنید.

مترجم: خانم سپیده مشایخی

گزیده:
با وجود تمام پیشرفت‌های انجام‌شده به نظر می‌رسد که تقریباً همه پرسش‌های مهم در هوش مصنوعی بی‌پاسخ مانده‌اند. حتی بسیاری از پرسش‌ها هنوز به درستی مطرح نشده‌اند.
فرانسوا شوله


https://t.me/bibalan_com
https://www.bibalan.com/?p=3966
Telegram سماموس: نوشته‌های یوسف مهرداد بی‌بالان این کانال برای اطلاع‌رسانی نوشته‌های وبلاگ سماموس (bibalan.com) ایجاد شده است. مطالب پس از انتشار در وبلاگ، در این کانال نیز منتشر خواهد شد. امیدوارم که مطالب آن برای شما مفید باشد و خوشحال خواهم شد تا نظرات و بازخوردهای شما عزیزان را دریافت کنم.
  • ❤ 1
Post #269 177
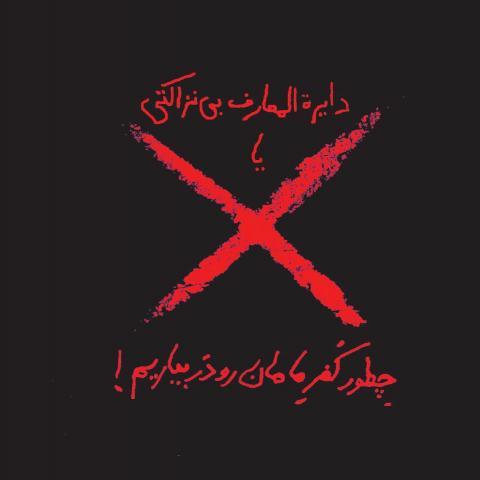
چطور کفر مامان رو در بیاریم

هفته پیش یک کتاب خیلی جالب خواندم. اسم این کتاب «دایره‌المعارف بی‏نزاکتی یا چطور کفر مامان رو در بیاریم» نوشته آر.جی.فیچر و ترجمه تبسم آتشین‏جان، چاپ ششم از نشر حوض نقره بود.
این کتاب سعی دارد تا نکات مهمی! را به کوچولوها بیاموزد.بخشهایی از آن را انتخاب کردم و تقدیم می‏کنم به «رها» کوچولو.

-می‏دونی همه جازیستهای [نوازنده‌ی جاز] موفق وقتی بچه بودن، موقع غذا خوردن مدام با قاشق می‏زدن روی ظرفشون 😂

-علم ثابت کرده وقتی غذا رو بمالی به صورتت خوش مزه‏تر می‏شه 😂

-اگه گفتی کاغذ توالت چند متره؟ 😂

– مامان عاشق نقاشی‏های توست. دیوارهای اتاقشو … 😂

-بعد از عبارت «تو دیگه بچه نیستی» منتظر شنیدن یه چیز ناخوش‏آیند باش 😂

-نذار کسی سرت شیره بماله. غذای تو بشقاب مامان و بابا خیلی خوش‏مزه‏تر ازغذای توی بشقاب خودته 😂

-یادت باشه که آدم قبل از اینکه قاشق داشته باشه، انگشت داشته 😂

-ته بستنی قیفی جایزه هست. اول ته شو بخور 😂

-می‏خوای گربه رو راحت‏تر پیدا کنی؟ به پاهاش شکلات بمال 😂

-سی دی مثل بشقاب پرنده است. می‏گی نه. امتحانش کن 😂

واقعاً مادرانمون چقدر برامون زحمت کشیدند و جداً بهشت براشون خیلی کمه.
خوش باشید.
بهمن ۱۳۸۵

پ.ن. رهای عزیزم الان خانمی شده برای خودش! برایش بهترین‌ها رو آرزومندم.

https://bit.ly/3NNd87O
https://www.bibalan.com/?p=916
https://t.me/bibalan_com
  • 😁 1
Post #268 193
محدودیت‌های دنیای من

پیش‌گفتار:
یکی از چشم اسفندیارهای زندگی در اینجا آشنایی با زبان و فرهنگ است. کم‌تر کسی را پیدا می‌کنی که خاطرات بامزه در این مورد نداشته باشد. یکی از اتفاقاتی که برای خودم پیش آمده را در اینجا (روزی که وایر ما کراس کرد!) نوشته‌ام.
چند روز پیش داستان زیر را از یکی از دوستانم شنیدم و آن قدر تکان‌دهنده بود که تصمیم گرفتم با کسب اجازه از ایشان، آن را اینجا بازگو کنم.

داستان:
یک نفر بود که می‌گفت همکلاسی‌ها و استادهای من خیلی نژادپرست هستند. توی جلسات علمی دانشگاه هر وقت که نوبت به من می‌رسه و من حرف می‌زنم بهم می‌گند:
I know where you are coming from
بعد بنده‌خدا می‌خواست سر این قضیه دانشگاهش رو ول کنه.

توضیح داستان:
معنی لغوی جمله‌ای که همکلاسی‌ها و استادهای ایشان می‌گفتند به فارسی می‌شود «من می‌دونم شما از کجا داری می‌آی (از کجا اومدی)» که مودبانه و محترمانه‌ نیست. راستش را بخواهید تحمل فشار روانی ناشی از این برخورد آن هم در یک فضای دانشگاهی برای هیچ‌کس ساده نیست.
اما حالا اجازه بدهید از گوگل و واژه‌نامه‌های آنلاین کمک بگیریم و معنی این جلمه را پیدا کنیم. معنی این جمله یا اصطلاح این است که «من رویکرد و دیدگاه شما [درباره این موضوع] رو می‌فهمم»!
با پیدا کردن معنی این جمله احتمالا شما هم به این نتیجه رسیده‌اید که این داستان فقط و فقط یک سوءتفاهم بوده است.

پس‌گفتار:
بسیاری از این دست اتفاقات زبان و فرهنگی معمولا به داستان‌های خنده‌دار و خاطرات ‌بامزه ختم می‌شوند ولی کم نیستند آنهایی که باعث آزار و اذیت یک نفر شده‌اند و حتی زندگی‌اش را به کلی تغییر داده‌اند.

گزیده:
محدودیت‌های زبان من به معنای محدودیت‌های دنیای من است.
لودویگ ویتگنشتاین

https://www.bibalan.com/?p=3961
https://t.me/bibalan_com
Telegram سماموس: نوشته‌های یوسف مهرداد بی‌بالان این کانال برای اطلاع‌رسانی نوشته‌های وبلاگ سماموس (bibalan.com) ایجاد شده است. مطالب پس از انتشار در وبلاگ، در این کانال نیز منتشر خواهد شد. امیدوارم که مطالب آن برای شما مفید باشد و خوشحال خواهم شد تا نظرات و بازخوردهای شما عزیزان را دریافت کنم.
  • ❤ 2
  • 👍 2
Post #267 174
یادگیری ماشین برای همه (۲)

۲) سه مؤلفه یادگیری ماشین
اگر از مطالب نادرست و احمقانه‌ درباره‌ی هوش مصنوعی بگذریم باید گفت که تنها هدف یادگیری ماشین، پیش‌بینی نتایج بر اساس داده‌های ورودی است. تمام وظایف (tasks) یادگیری ماشین را می‌توان به همین شکل (پیش‌بینی بر مبنای داده‌ها) بیان کرد و اگر مساله‌ای را نتوان به این صورت بیان نمود احتمالا آن مساله ارتباطی به یادگیری ماشین ندارد.
هر چه تنوع نمونه‌ها (samples) بیشتر باشد، پیدا کردن الگوهای مرتبط و پیش‌بینی نتیجه آسان‌تر است. برای یادگیری ماشین به سه مولفه (component) نیاز داریم: داده‌ها (Data)، ویژگی‌ها (Features) و الگوریتم (Algorithm)

داده‌ها (Data)
آیا می‌خواهید هرزنامه‌ها (Spam) را از بین ایمیل‌ها شناسایی کنید؟ پس باید تعدادی هرزنامه به عنوان نمونه‌ (sample) جمع‌آوری کنید. آیا می‌خواهید قیمت سهام را پیش‌بینی کنید؟‌ پس باید تاریخچه قیمت سهام را پیدا کنید. آیا می خواهید سلیقه و پسند کاربر را کشف کنید؟ پس باید فعالیت‌های وی را در فیسبوک جمع‌آوری و سپس تجزیه و تحلیل کنید (اوه! نه مارک زاکربرگ، جمع‌آوری اطلاعات کاربران را متوقف کن! بسه دیگه!) . هر چه داده‌ها ناهمگون و دارای تنوع بیشتری باشند نتیجه‌ بهتری به دست خواهد بود. وقتی صحبت از نیاز به داده‌ها می‌شود به خاطر داشته باشید که گاهی حتی ده‌ها هزار داده و نمونه، کم‌ترین تعداد مورد نیاز در یک مساله‌ی یادگیری ماشین است.

دو روش اصلی برای آماده‌سازی داده‌ها وجود دارد: روش دستی (manual) و روش خودکار(automatic) .
در روش دستی،‌ داده‌ها خطای بسیار کم‌تری دارند اما جمع‌آوری آنها به زمان بیشتری نیاز دارد و همین امر باعث می‌شود این روش به صورت کلی پرهزینه‌تر باشد. روش خودکار نسبت به روش دستی ارزان‌تر است. شما هر داده‌ای را که پیدا می‌کنید جمع آوری می‌کنید به این امید که این داده‌ها برای حل مساله‌ی شما کافی‌اند.
برخی از شرکت‌های عقل کل‌ [کسی که تلاش می‌کند به شکل آزاردهنده‌ای باهوش‌تر از دیگران به نظر برسد؛ مترجم] مانند گوگل به صورت رایگان از مشتریان خود برای برچسب زدن (label) و آماده‌ساز داده‌ها استفاده می‌کنند. حتما به خاطر دارید که ری‌کپچای شرکت گوگل ( ReCaptcha) شما را مجبور می‌کند تا “در تصاویر زیر علائم راهنمایی را انتخاب کنید”؟ [ری‌کپچا اطمینان حاصل می‌کند که کاربر استفاده‌کننده از کامپیوتر یک انسان است نه یک ربات؛ مترجم]. این دقیقا کاری هست که آنها می‌کنند و شما را به عنوان نیروی کار رایگان به خدمت می‌گیرند! چقدر عالی! به جای کارمندان این شرکت‌ها منِ کاربر شروع می‌کنم به یاد دادن تعداد بیشتر و بیشتری از علایم راهنمایی به ری‌کپچا. اوف …!
جمع آوری مجموعه‌ای با کیفیت از داده‌ها کار بسیار دشواری است. به یاد داشته باشید که به مجموعه‌ی داده‌ها، دیتاست (dataset) گفته می‌شود. اهمیت داده‌ها به حدی است که شرکت‌ها، شاید حاضر شوند الگوریتم‌های خود را در اختیار عموم قرار دهند اما به ندرت حاضر به انتشار دیتاست‌های خود می‌شوند.

مترجم: خانم سپیده مشایخی

گزیده:
درست مانند صد سال پیش که برق تقریباً همه چیز را متحول کرد، امروز هم واقعاً برایم دشوار است صنعتی را پیدا کنم که باور داشته باشم هوش مصنوعی آن را طی چند سال آینده متحول نخواهد کرد. اندرو اینگ

https://www.bibalan.com/?p=3955
https://t.me/bibalan_com
Telegram سماموس: نوشته‌های یوسف مهرداد بی‌بالان این کانال برای اطلاع‌رسانی نوشته‌های وبلاگ سماموس (bibalan.com) ایجاد شده است. مطالب پس از انتشار در وبلاگ، در این کانال نیز منتشر خواهد شد. امیدوارم که مطالب آن برای شما مفید باشد و خوشحال خواهم شد تا نظرات و بازخوردهای شما عزیزان را دریافت کنم.
  • 👍 2
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →