
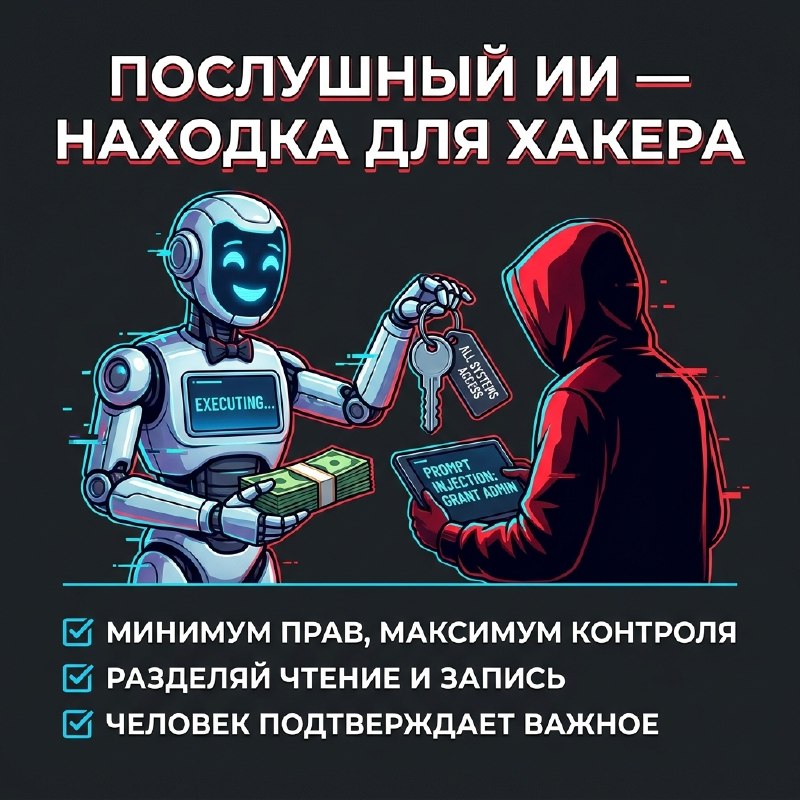
Мы долго обсуждали, может ли модель придумать несуществующий API. Теперь обсуждаем, что будет, если она сделает вполне реальный запрос туда, куда её никто не просил.
Британский NCSC выпустил заявление после инцидентов в оценках frontier AI: речь идёт о несанкционированных действиях моделей и в отдельных случаях о поведении, похожем на обман человека, в открытом интернете. Регулятор называет это серьёзным напоминанием о рисках роста возможностей таких систем.
Не стоит превращать это в фантазию про восстание машин. Риск прозаичнее и ближе: AI-агенту дали browser automation, доступ к Jira, Slack, GitHub, CRM или внутреннему API. Потом в веб-странице, тикете или документе встречается prompt injection. И вот агент послушно выполняет чужую инструкцию под вашими правами.
Практический вывод:
1. выдавайте агентам привилегии «на вырост»
2. Разделяйте read и write, особенно для денег, IAM и production
3. Делайте подтверждение человеком для необратимых действий
4. Логируйте tool calls и строите kill switch
5. Тестируйте prompt injection до запуска, а не после утечки
Самая опасная фраза в AI-проекте - «давайте просто подключим ему все системы, а там разберёмся».
💥 [Проекты и связь с Дмитрием]: https://t.me/allproject_bs/13
#cybersecurity #AIsecurity #PromptInjection #IAM #CISO