👉 Давайте договоримся о том, что "Сеть — ненадёжна", примем это как аксиому, как фундаментальное правило, как гравитацию. Сегодня, в эпоху (микро)сервисов, огромного кол-ва сторонних решений вызываемых по API это очень важная аксиома.
Во время разработки нужно об этом помнить и задавать себе вопросы:• А что если я получу HTTP timeout exception?
• Что делать, если я пошлю команду на изменение и не получу ответ?
• Является ли данный вызов идемпотентным?
• etc.
Что делать, раз вызов по сети может зафейлиться?
👍 Мы должны обеспечить автоматический retry. Для этого отлично подходят системы управления очередями.
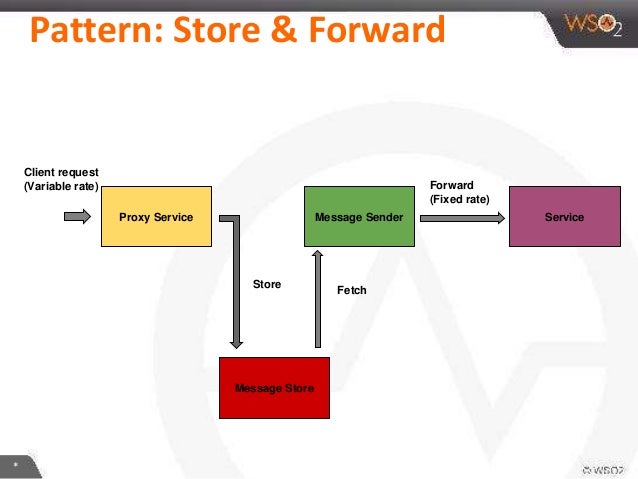
Такое взаимодействие называется store and forward, при котором информация попадает в промежуточное хранилище и позднее отправляется в конечный пункт назначения. Он также помогает обеспечить гарантированную доставку, поскольку сообщения сохраняются и никогда не теряются. Если наш получатель находится offline или возникли любые другие сетевые проблемы — система очередей должна попробовать повторить отправку сообщения.
❗️Конечно стоит помнить об особенностях данного подхода. Для конечного пользователя взаимодействие перестанет быть синхронным. С одной стороны, нам не нужно заставлять пользователя ждать, пока выполнятся все наши сетевые вызовы, но с другой мы не можем сразу вывести пользователю конечный результат. То есть мы переходим от привычного Request/Response к Fire and Forget паттерну.
🔨 Получается, что, решая проблему инфраструктуры, асинхронный обмен сообщениями вынуждает нас изменить логическую схему приложения, переосмыслить подход к написанию кода и осмыслить границы в нашей системе.
#middle #architecture #source