Ладно, проверим. Поставил
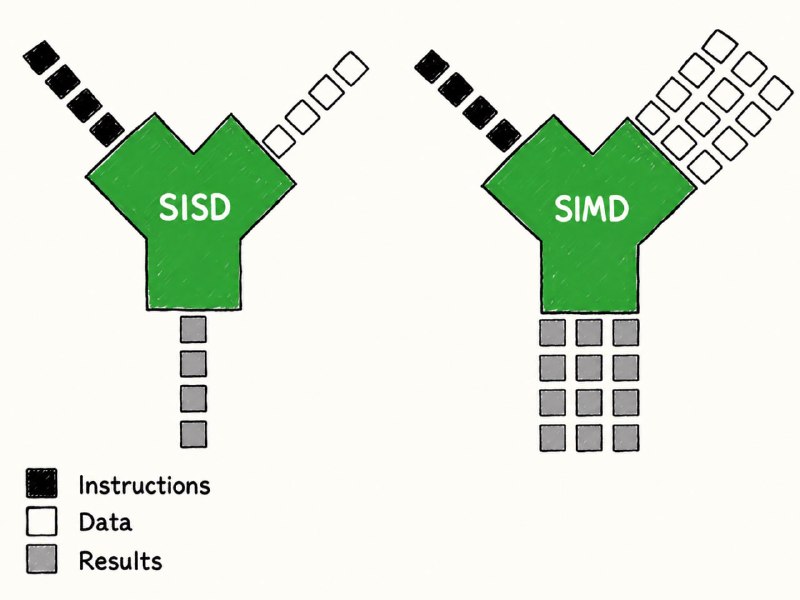
go1.27rc2, включил GOEXPERIMENT=simd и пошёл гонять бенчмарки на своём i9-14900KF.Полгода назад в разборе Go 1.26 SIMD у меня был одной строчкой анонса. С тех пор эксперимент дорос: в 1.27 появился переносимый пакет simd, а archsimd научился ARM64 и Wasm #73787. Главное: раньше SIMD в Go означал ассемблер в синтаксисе Plan 9. Теперь это обычный импорт и типы вроде Float32x8.
Задача из жизни: косинусная близость эмбеддингов, вектора по 768 float32. Скалярный цикл выдаёт 332 нс на пару. Переписал на Float32x8 с FMA и четырьмя аккумуляторами на каждую из трёх сумм, получил 341 нс. Вектор проиграл скаляру. Разобрался: на коротких векторах всю победу съедает обвязка, тот самый свод трёх сумм из полос в числа плюс хвост. А скаляр на 768 элементах и так неплох.
Где SIMD всё же стреляет, на тех же данных. Чистый dot product: 166 нс против 261 у скаляра, в 1.6 раза быстрее. Косинус на 12 тысячах элементов: 1.8 мкс против 5.1, почти втрое. Мораль дня: сначала померь на своих размерах, потом переписывай. Код при этом читается почти как обычный Go, числа идут пачками по 8.
Дёготь тоже есть: API ломается между rc, а интринсики archsimd паникуют если CPU не умеет в нужные инструкции. Проверку фич делаешь сам. В прод рано, а вот пет-проект самое то.
Эссе Хашимото рекомендую целиком, примеры там на Zig, но суть от языка не зависит...
Вот еще одно интересное обсуждение на Hacker News.