
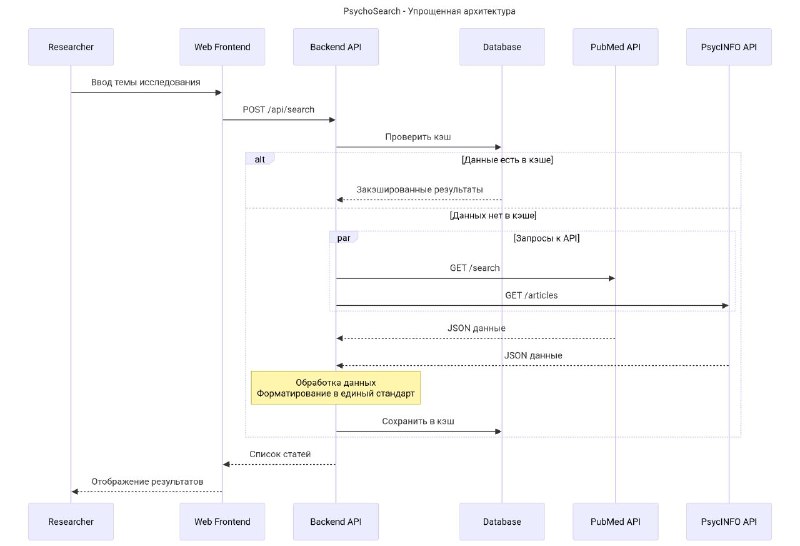
В качестве примера взяла создание сервиса по поиску научных публикаций в области психологии. Админу было лениво самой заполнять шаблон, поэтому попросила заполнить шаблон дипсика на основании моих вводных (и поплатилась за лень несколькими попытками доведения сценария и архитектуры до MVP). Также можно прогонять через ИИ такое описание на предмет поиска несоответствий, ошибок в логике или для оптимизации архитектуры.
❕ Для корпоративных целей используйте инстументы, разрешенные ИБ вашей компании.
Заполненный шаблон для сервиса поиска научных исследований:⚫️Бизнес-анализ & IT
1. Контекст проекта:
· Название системы/сервиса: PsychoSearch
· Основная цель системы: Сервис для поиска и предоставления списка научных исследований в области психологии по заданной теме в едином формате "дата — название — авторы".
· Для кого диаграмма: Я/команда разработчиков — Уровень детализации должен быть техническим, но минимально необходимым для MVP.
2. Участники процесса (Actors & Components):
· Инициатор (Actor): Исследователь (Пользователь)
· Основные компоненты системы: Web Frontend, Backend API, Database (для кэширования)
· Внешние сервисы/API: PubMed API, PsycINFO API
3. Ключевой сценарий для диаграммы:
· Название сценария: Успешный поиск статей по теме с кэшированием
· Пошаговое описание основного сценария:
1. Исследователь вводит тему исследования в поисковую строку Frontend и нажимает "Найти"
2. Frontend отправляет POST запрос с поисковым запросом на Backend API (/api/search)
3. Backend API проверяет наличие результатов в кэше (Database)
4. Если результатов в кэше нет, Backend API параллельно отправляет запросы к PubMed API и PsycINFO API
5. Внешние API возвращают результаты в своих форматах JSON
6. Backend API обрабатывает данные: объединяет результаты, убирает дубликаты, форматирует даты и авторов
7. Backend API сохраняет обработанные результаты в кэш (Database)
8. Backend API возвращает отформатированный список статей на Frontend
9. Frontend отображает результаты пользователю
4. Альтернативные потоки и обработка ошибок:
· Что должно произойти в случае ошибки? Если один из внешних API недоступен, система использует данные только от работающего API. Если оба API недоступны, но есть закэшированные данные - использует их.
· Логика повторов (retry): Нет, не показывать повторные попытки для упрощения
· Таймауты: Нет, не отображать таймауты на диаграмме
5. Требования к выходной диаграмме:
· Формат: Mermaid JS
· Уровень детализации: Включить основные HTTP-методы, показать проверку кэша и параллельные запросы к API
· Особые пожелания: Показать альтернативную ветку когда данные есть в кэше, акцент на простоте архитектуры