Post #31
177

Retry спасает от ошибок. И иногда превращает 10 000 запросов в 40 000
Сервис B начал тормозить под нагрузкой. Часть запросов падает по timeout, и сервис A начинает ретраить.
Казалось бы, retry здесь и нужен. Но именно в этот момент он может добить зависимость окончательно.
Если 10 000 запросов одновременно упали и каждому разрешено ещё три попытки, сервис потенциально получит до 40 000 запросов вместо 10 000. Причём дополнительная нагрузка прилетит тогда, когда он уже работает на пределе.
💾Самый простой вариант – повторять запрос через фиксированный интервал. Например, раз в секунду. Но если сотни клиентов получили ошибку примерно одновременно, через секунду они так же одновременно придут снова.
Поэтому интервал между попытками обычно увеличивают через exponential backoff. Это снижает частоту повторов, но не решает проблему полностью: клиенты всё ещё могут синхронизироваться.
Здесь появляется jitter – небольшое случайное отклонение в задержке. Оно разносит повторные запросы по времени и сглаживает пики. Но даже backoff с jitter не отвечает на другой вопрос: сколько дополнительной нагрузки мы вообще готовы создать ради retry?
Для этого нужен retry budget. Он ограничивает долю повторных запросов. Если бюджет закончился, сервис перестаёт бесконечно спасать каждый запрос и усиливать уже начавшуюся деградацию.
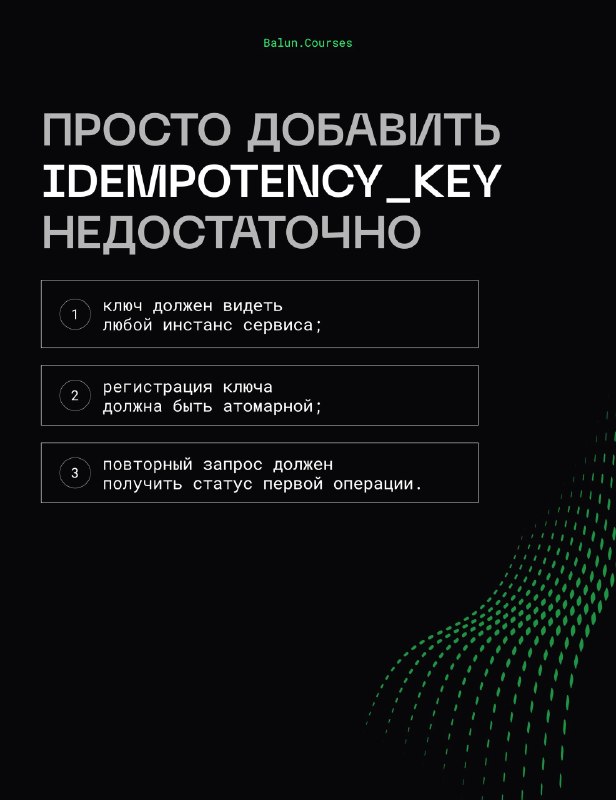
Есть и ещё один риск. Запрос мог успешно выполниться, а ответ – потеряться по дороге. Клиент увидит timeout и отправит его снова. Если операция не идемпотентна, можно получить два списания, два заказа или две одинаковые записи.
На курсе «Паттерны отказоустойчивости в микросервисах на Go» retry разбираем именно в таком контексте: когда повтор действительно помогает, когда начинает усиливать аварию и что должно быть рядом с ним, чтобы система переживала сбои, а не разгоняла их.
Сервис B начал тормозить под нагрузкой. Часть запросов падает по timeout, и сервис A начинает ретраить.
Казалось бы, retry здесь и нужен. Но именно в этот момент он может добить зависимость окончательно.
Если 10 000 запросов одновременно упали и каждому разрешено ещё три попытки, сервис потенциально получит до 40 000 запросов вместо 10 000. Причём дополнительная нагрузка прилетит тогда, когда он уже работает на пределе.
💾Самый простой вариант – повторять запрос через фиксированный интервал. Например, раз в секунду. Но если сотни клиентов получили ошибку примерно одновременно, через секунду они так же одновременно придут снова.
Поэтому интервал между попытками обычно увеличивают через exponential backoff. Это снижает частоту повторов, но не решает проблему полностью: клиенты всё ещё могут синхронизироваться.
Здесь появляется jitter – небольшое случайное отклонение в задержке. Оно разносит повторные запросы по времени и сглаживает пики. Но даже backoff с jitter не отвечает на другой вопрос: сколько дополнительной нагрузки мы вообще готовы создать ради retry?
Для этого нужен retry budget. Он ограничивает долю повторных запросов. Если бюджет закончился, сервис перестаёт бесконечно спасать каждый запрос и усиливать уже начавшуюся деградацию.
Есть и ещё один риск. Запрос мог успешно выполниться, а ответ – потеряться по дороге. Клиент увидит timeout и отправит его снова. Если операция не идемпотентна, можно получить два списания, два заказа или две одинаковые записи.
Поэтому retry – не кнопка «сделать надёжнее». Его нужно проектировать вместе с backoff, jitter, budget и идемпотентностью, иначе паттерн отказоустойчивости сам становится причиной инцидента.
На курсе «Паттерны отказоустойчивости в микросервисах на Go» retry разбираем именно в таком контексте: когда повтор действительно помогает, когда начинает усиливать аварию и что должно быть рядом с ним, чтобы система переживала сбои, а не разгоняла их.
- 🔥 3
- ❤ 1
- 😁 1