
Почему мы идем в Data Lakehouse?
В этом посте мы рассмотрим варианты построения аналитического хранилища данных и представим концепцию Data Lakehouse.
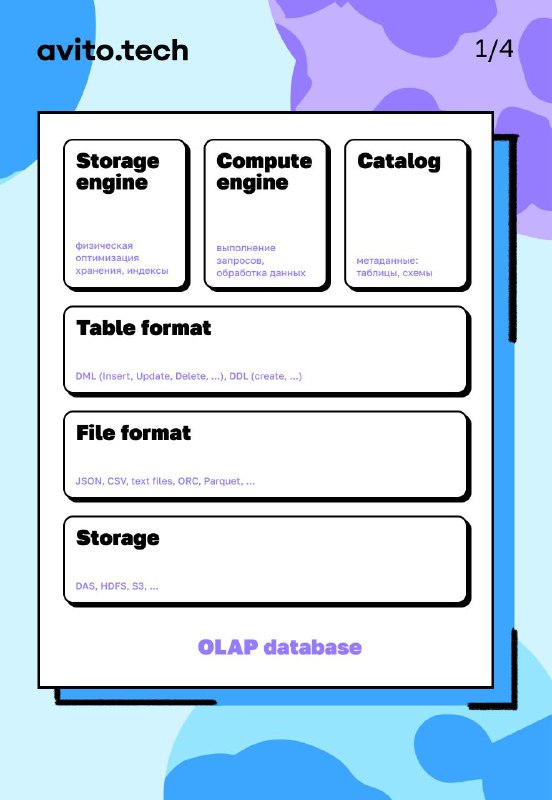
Хранилище данных — это ядро аналитической платформы, которое состоит из 6 компонентов:
- Storage — собственно, где хранятся данные.
- Storage Engine — движок, отвечающий за физическую оптимизацию хранения данных.
- Compute Engine — движок, отвечающий за выполнение запросов и обработку данных.
- Catalog — система хранения метаданных (таблицы, схемы).
- Table Format — система, обеспечивающая SQL-like синтаксис работы с табличными данными.
- File Format — формат хранения данных (колоночные, строковые, ...).
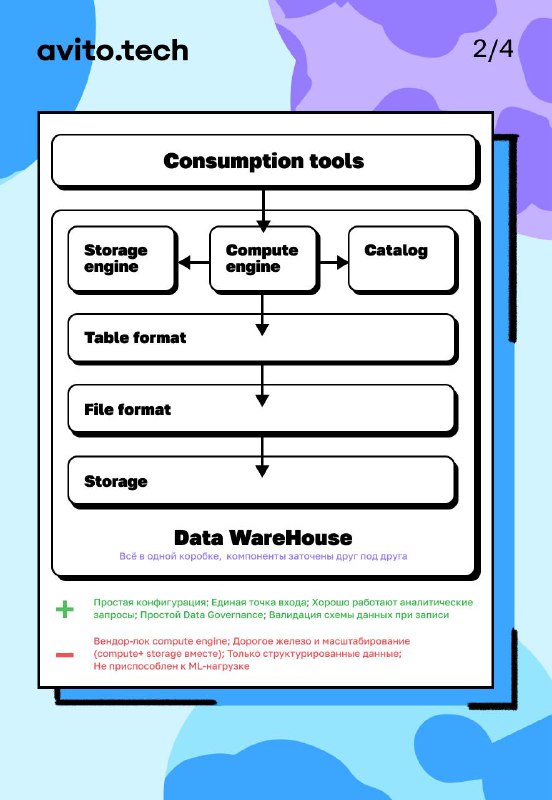
Первая концепция Data Warehouse (DWH) появилась еще в 1980-х годах. В концепции описанные выше компоненты содержатся в одной коробке и максимально заточены друг под друга. Такой вариант удобен для аналитика: единая точка входа, хорошо работают аналитические запросы, просто управлять данными, схема валидируется при записи. При этом DWH редко приспособлен для решения data science задач: не приспособлен к ML-нагрузке и хранит только структурированные данные. С точки зрения администратора такое хранилище легко конфигурировать, при этом оно лишено гибкости. Один из главных недостатков — на больших объемах хранилище слишком дорого масштабировать (Compute и Storage движки соединены), подменить Compute — нельзя, всё закрыто через вендор-лок.
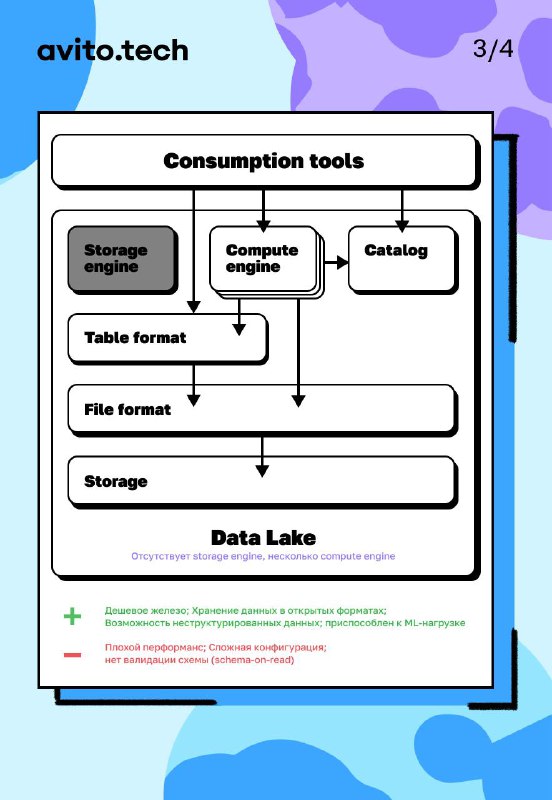
В 2011 году компания Pentaho представила подход Data Lake. Это парадоксально, но в таком подходе в хранилище отсутствует Storage Engine. Как преимущество — данные хранятся в открытых форматах и на дешевом железе, в хранилище может быть несколько Compute Engine (решается проблема масштабирования). Также Data Lake отлично заточен на решение data science задач: он хранит неструктурированные данные и приспособлен к ML-нагрузке. При этом такое хранилище существенно сложнее поддерживать: нужно выбирать, собирать и затачивать друг под друга компоненты. Аналитику приходится работать с неструктурированными данными и мириться с плохим перформансом запросов по сравнению с DWH.
Следующей революцией в мире аналитических хранилищ данных стала парадигма Data Lakehouse. В эту сторону двигались некоторые Big Tech компании, а термин ввели Jellyvision в 2017 году. Из названия мы понимаем, что этот подход призван совместить плюсы двух предыдущих концепций. Lakehouse предоставляет DWH-like интерфейс, предоставляет сопоставимую скорость выполнения запросов. При этом интерфейс построен на открытых технологиях, дешевом железе и приспособлен для ML-задач, как Data Lake. Разумеется, такой подход сложнее с точки зрения администрирования, но это стоит того, в особенности на больших объемах.
Хотите узнать подробнее про наш Data Lakehouse? Ставьте 👍
#Databases
Post #29
2.85K

- 👍 63
- 🔥 7
- ❤ 6
- 🥱 3