
😁Kiro: LLM + SMT для проверки спецификаций
AWS добавила в свою SDD-based IDE Kiro любопытную функцию анализа требований — инструмент, который математически, с помощью SMT-солвера, доказывает отсутствие противоречий и пробелов в спецификациях до начала генерации кода.
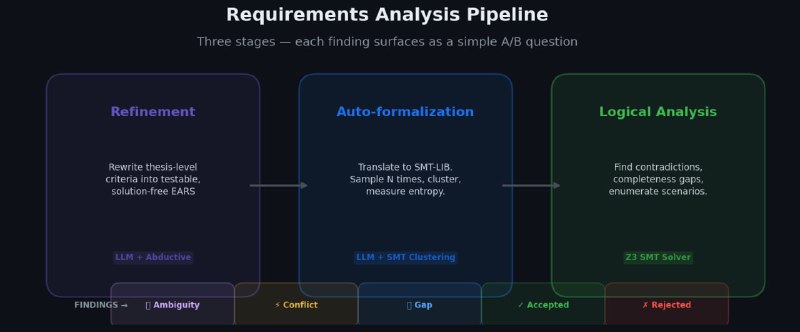
Работает это так:
1. Уточнение требований
LLM перерабатывает размытые требования на естественном языке в тестируемые критерии в нотации EARS. На этом этапе устраняется «язык реализации», выявляются пропущенные сценарии ошибок и противоречия.
2. Авто-формализация (LLM + семантическая энтропия)
Уточнённые критерии переводятся в формальную логику — язык утверждений SMT-lib для SMT-солвера. Ключевой механизм здесь — семантическая энтропия: LLM генерирует несколько семплов формализации одного и того же критерия, которые кластеризуются по логической эквивалентности и проходят энтропийную оценку:
• низкая энтропия — принимается интерпретация большинства;
• средняя энтропия — пользователю выдаётся уточняющий вопрос с двумя расходящимися трактовками;
• высокая энтропия — формализация отбрасывается, критерий требует переформулировки.
Механизм эвристики «измерения двусмысленности», на мой взгляд — является главной технической находкой, отличающей подход AWS от тупого прогона через LLM. И, если подумать, может быть применен отнюдь не только для анализа спецификаций (собственно, и в самой статье упоминается, что весь подход изначально уже использовался у них в гардрейлах и для политик харнесса).
3. Логический анализ (SMT-солвер)
Формализованные критерии подаются в SMT-солвер. Он решает две задачи:
• непротиворечивость: существует ли ситуация, в которой два правила требуют несовместимых результатов? Солвер находит минимальные противоречащие наборы правил;
• полнота: существует ли достижимое состояние, для которого не определено поведение?
Из формальной модели автоматически генерируются примеры accepted- и rejected-scenario. LLM-судья проверяет их на наличие расхождений — соответствие исходному пользовательскому замыслу, и при их наличии выносит вопрос разработчику в формате бинарного выбора (условно: «оставить как есть» или «изменить»).
Утверждается, что во внутреннем тестировании на 35 проектах Kiro с >1400 критериями приёмки ≈60% черновых требований нуждались в доработке. SMT-солвер выявил проблемы, которые при ручном рецензировании были пропущены.
В статье не раскрывается, какой именно солвер они используют, но в других упомянутых выше технологиях AWS применяется Zelkova — ансамблевый подход, включающий, и Z3 с автоматными расширениями, и обе версии CVC (почитать об этом можно здесь).
Подход выглядит весьма интересным, поскольку, в отличие от распространённого «проверим выход одной LLM, подав всё на вход другой», AWS здесь применяет то, что сейчас модно называть нейросимволическим пайплайном: LLM отвечает за интерпретацию естественного языка, а за доказательную проверку — детерминированный формальный движок.
Получается, надо тестить 🙂
#ИИ_инструменты
Post #88
595
- 👍 8
- ❤ 4
- 🔥 3
- 💯 2