
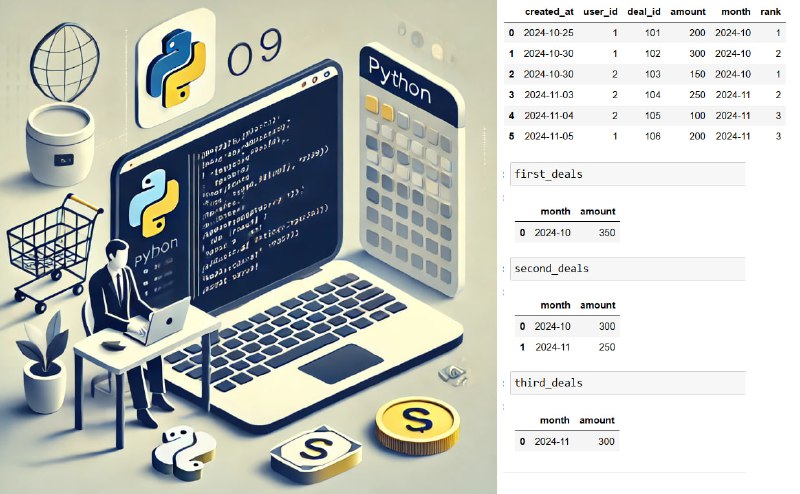
Поступила мне тут задачка посчитать сумму покупок для каждого пользователя на определенном этапе его покупок: например, для 1-й, 2-й или 3-й покупки. В идеале это можно решить с помощью оконных функций в SQL. Но что делать, если они не доступны? 🤔
Я сделала, как обычно, с помощью Python и библиотеки pandas! Давайте разберемся, как это сделать шаг за шагом.
Итак, у нас есть таблица df с такими данными:
data = {
    #дата покупки
    'created_at': ['2024-10-25', '2024-10-30', '2024-10-30', '2024-11-03', '2024-11-04', '2024-11-05'],
    #идентификатор пользователя
    'user_id': [1, 1, 2, 2, 2, 1],
    #номер сделки
    'deal_id': [101, 102, 103, 104, 105, 106],
    #сумма покупки
    'amount': [200, 300, 150, 250, 100, 200]
}
df = pd.DataFrame(data)
df['created_at'] = pd.to_datetime(df['created_at'])
Мы добавляем столбец month, который извлекает месяц из даты покупки (created_at), так как мне нужна была именно по месяцам разбивка.
df['month'] = df['created_at'].dt.to_period('M')Оказывается есть метод cumcount(), чтобы рассчитать порядок покупок для каждого пользователя. 📊
df['rank'] = df.groupby('user_id').cumcount() + 1Теперь у нас есть столбец rank, который говорит нам, какая по счету покупка была сделана пользователем.
И уже можно легко фильтровать их по порядку (первая, вторая, третья) и посчитать суммы для каждого из этих этапов.
# Сумма первых покупок
first_deals = df[df['rank'] == 1].groupby('month', as_index=False)['amount'].sum()

# Сумма вторых покупок
second_deals = df[df['rank'] == 2].groupby('month', as_index=False)['amount'].sum()

# Сумма третьих покупок
third_deals = df[df['rank'] == 3].groupby('month', as_index=False)['amount'].sum()
📈 Вот так любимый python-чик может все! ❤️🔥🎯