
Сперва кажется, что за бред про прерываемые индексы? Сейчас расскажу где можно ошибиться 😜
А кто не ошибается, тот не работает! Главное вовремя понять, что тут что-то не то.
💡 Итак, задача: У нас есть список клиентов и их годовые обороты. Мы хотим отфильтровать тех, у кого оборот, допустим, больше 1 миллиона, отсортировать их по убыванию и выбрать топ-3 самых крупных клиентов.
Создадим данные для наглядности:
import pandas as pd
# Создаем исходный DataFrame
data = {
    'client_id': [101, 102, 103, 104, 105],
    'client_name': ['Client A', 'Client B', 'Client C', 'Client D', 'Client E'],
    'turnover': [1200000, 500000, 1500000, 2000000, 3000000]
}
df = pd.DataFrame(data)
📋 Шаг 1: Фильтрация и сортировка клиентов
Сначала отфильтруем клиентов с оборотом более 1 миллиона и отсортируем их по обороту от большего к меньшему:
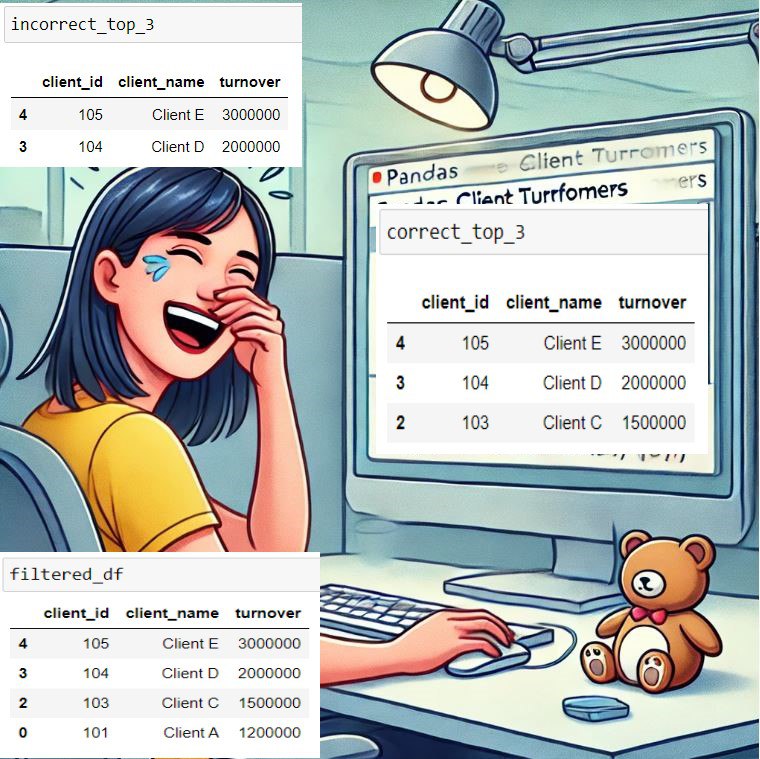
filtered_df = df[df['turnover'] > 1000000].sort_values('turnover', ascending=False)Теперь у нас есть DataFrame с клиентами, у которых оборот превышает 1 миллион, отсортированный по убыванию
🚫 Ошибка: Что будет, если для выбора топ-3 теперь использовать .loc?
incorrect_top_3 = filtered_df.loc[:3]
Метод .loc[:3] пытается выбрать строки с индексами 0, 1, 2, 3. Однако, после фильтрации и сортировки, индексы строк изменились, и это приведет к выбору не тех строк!
✅ Правильный подход: Используем .iloc, чтобы выбрать первые 3 строки по их позициям:
correct_top_3 = filtered_df.iloc[:3]
С помощью .iloc мы гарантированно получаем топ-3 клиента по их позициям в отсортированном DataFrame, игнорируя индексы.
✨ Вывод: Используйте .iloc для выбора строк по позициям, особенно после фильтрации, группировки или сортировки данных, когда индексы идут не подряд. Тогда результат действительно будет топовым! 🤪