Post #1369
57
Channel Public Channel
 #N
#N/A
@anai8
- Subscribers
- 190
- Photos
- 378
- Videos
- 14
- Links
- 163
Recent Posts 20 shown

Post #1368
86

мне так знакомо это настроение (и эта физиогномика)
Post #1367
84
Forwarded from Запрети мне псевдолейблить

Ферма перевалила за 10к участников!
Это значит две новости для вашего рейтинга:
1. 30+ золотых медалей
2. Очень большой сдвиг рейтинговой таблицы
3. Хорошая возможность поднять себе серебро (топ 501) и бронзу (топ 1003)
Вообще мемно, как за ТОП 1000 можно получить медальку
Это значит две новости для вашего рейтинга:
1. 30+ золотых медалей
2. Очень большой сдвиг рейтинговой таблицы
3. Хорошая возможность поднять себе серебро (топ 501) и бронзу (топ 1003)
Вообще мемно, как за ТОП 1000 можно получить медальку
Post #1366
91
Это, кстати, альфа сильная. Если до медальки чуть-чуть не дотягиваешь, то можно на своем канале пофорсить и технически подняться.
Post #1365
97
Еще мне кажется что Гугл перемогу сделает со временем над ОпенАИ и Антропиком.
Ща институционалы состригут с хомяков свои инвестиции через ИПО и дальше гг.
Ща институционалы состригут с хомяков свои инвестиции через ИПО и дальше гг.
- 👍 2
- 💯 1
Post #1364
99

Ждали с мая.
- 🔥 5
Post #1363
100
Встреча с подписчиками канала, это когда Маму подписал на канал и на выходных заехал проведать или по зуму созвонился.
- 🥰 5
Post #1362
105
Каждый год в сентябре мы пересаживаемся на модели Антропика, в марте следующего года возвращаемся к ОпенАИ.
- ❤🔥 4
Post #1361
122

Строю в гараже акустооптический модулятор на 2 tops.
Post #1360
131
Post #1359
126
Forwarded from Daniilak — Канал

Запек свой Jev и теперь могу работать с любыми моделями и любыми классами
открыл CSV, написал вопрос своими словами, сам придумал ответы - и у каждой строки есть вероятность.
Локально на своей NVIDIA, любая модель с Hugging Face
На днях выложу в репозиторий, сейчас времени нет
открыл CSV, написал вопрос своими словами, сам придумал ответы - и у каждой строки есть вероятность.
Локально на своей NVIDIA, любая модель с Hugging Face
На днях выложу в репозиторий, сейчас времени нет
Post #1358
123

(с) Сайдо
- 😁 1
Post #1357
137
Post #1356
126
Forwarded from NLP Wanderer
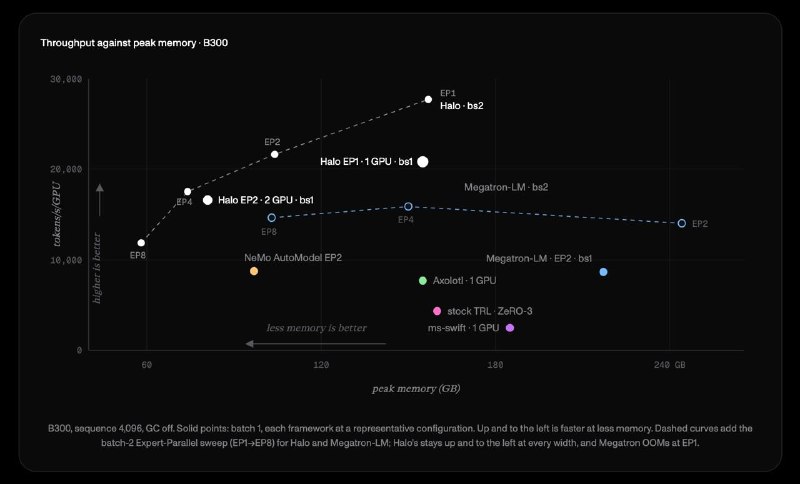
Halo: почти год моей работы в White Circle теперь в опенсорсе
Почти год я веду в White Circle разработку Halo - фреймворка для тренировки LLM, на котором мы учим все свои модели. Внутри он работал давно как замена Мегатрона, но до публичного релиза пришлось догнать transformers, TRL и vLLM, добавить модели и упростить адопшен - образы, CLI, документация. Подробный блогпост - на сайте White Circle (https://whitecircle.com/research/halo).
Если вы файнтюните открытые модели, то наверняка упирались в: модель уже не лезет в TRL и обычный FSDP, но связываться с Megatron и конвертацией чекпоинтов еще рано или просто не хочется. С MoE все еще хуже, без Expert Parallelism их по большому счету не потренировать. Halo добавляет EP, Context, Tensor и Expert-Tensor Parallelism прямо поверх обычных классов HuggingFace: на вход HF модель, на выходе HF модель. Новое MoE семейство подключается оберткой меньше 140 строк (у Megatron-Bridge на то же самое уходит 600-1900), сейчас их 15.
Немного цифр, все на B300, воспроизводимы из репо:
- 2.3-2.8x throughput относительно стокового TRL на gpt-oss-20b при тех же кернелах, loss совпадает в пределах ~1%.
- Gemma 4 26B-A4B на 2 GPU: 7.2k tok/s против 3.2-5.0k у NeMo AutoModel, Axolotl, Megatron Bridge, MS-SWIFT и Unsloth.
- Оптимизатор целиком в bf16 со стохастическим округлением: 120 GB состояния вместо 240 для 20B.
Все это првоерялось на реальных кластерах B300/B200/H200/H100 а топология заложена вплоть до NVL72: невалидные раскладки отбрасываются еще на этапе конфига. Запускается через
Отдельная моя гордость - Async RL. vLLM или SGLang живут в отдельном контейнере, роллауты идут асинхронно через Ray, веса уезжают по NCCL (по EFA 53-80 GB/s, gpt-oss-120b обновляется за 3-4 секунды), а генерации во время синка не обрываются. Внутри routing replay, importance sampling с масками, обучение на токенах, которые насэмплил движок, и 11 встроенных сред - от code contests и SWE до тулов через MCP. По механикам это сопоставимо с verl и Miles, только на HF-моделях и без Megatron.
Для студентов и тех, кто только начинает, Halo, мне кажется, хорошая точка входа. Все запускается из одного docker-образа:
Выложили и модель - GLM-4.7-Flash-Coder, 30B MoE под агентские скаффолды: SFT на 7.8k успешных траекторий GLM-5.1, на SWE-rebench-V2 pass@1 вырос с 33.2% до 41.7%, а модель сама научилась вызывать тулы параллельно. Она уже слегка устарела, но как гайд по агентскому SFT актуальна.
Код мы пишем с агентными скаффолдами и сильными моделями вроде Claude Fable и Opus, репозиторий под это спроектирован. Контрибьт приветствуется, но через фильтр: сначала issue и approve мейнтейнера, потом PR. Главное правило - понимать свой код: с AI писать можно, но это нужно раскрыть, а тесты должны падать, когда ломается поведение.
Дальше больше: Pipeline Parallelism (все уже в коде, но докатим после полных тестов) и серия блогов про тренировку, например про async RL для code contests. Лицензия Apache 2.0.
P.S. Если помните такую вещь как SMPO из времен Vikhr, то он теперь тоже живет там, но уже с EP и CP и улучшениями.
Почти год я веду в White Circle разработку Halo - фреймворка для тренировки LLM, на котором мы учим все свои модели. Внутри он работал давно как замена Мегатрона, но до публичного релиза пришлось догнать transformers, TRL и vLLM, добавить модели и упростить адопшен - образы, CLI, документация. Подробный блогпост - на сайте White Circle (https://whitecircle.com/research/halo).
Если вы файнтюните открытые модели, то наверняка упирались в: модель уже не лезет в TRL и обычный FSDP, но связываться с Megatron и конвертацией чекпоинтов еще рано или просто не хочется. С MoE все еще хуже, без Expert Parallelism их по большому счету не потренировать. Halo добавляет EP, Context, Tensor и Expert-Tensor Parallelism прямо поверх обычных классов HuggingFace: на вход HF модель, на выходе HF модель. Новое MoE семейство подключается оберткой меньше 140 строк (у Megatron-Bridge на то же самое уходит 600-1900), сейчас их 15.
Немного цифр, все на B300, воспроизводимы из репо:
- 2.3-2.8x throughput относительно стокового TRL на gpt-oss-20b при тех же кернелах, loss совпадает в пределах ~1%.
- Gemma 4 26B-A4B на 2 GPU: 7.2k tok/s против 3.2-5.0k у NeMo AutoModel, Axolotl, Megatron Bridge, MS-SWIFT и Unsloth.
- Оптимизатор целиком в bf16 со стохастическим округлением: 120 GB состояния вместо 240 для 20B.
Все это првоерялось на реальных кластерах B300/B200/H200/H100 а топология заложена вплоть до NVL72: невалидные раскладки отбрасываются еще на этапе конфига. Запускается через
torchrun, accelerate или halo CLI, в репо есть рецепты под SLURM, SkyPilot, RunPod и Nomad. Большая часть года ушла на то, чтобы все это не разваливалось на всех комбинациях моделей и параллелизмов - тестов в репозитории больше, чем кода. При этом работать будет также и на современных консьюмерских GPU.Отдельная моя гордость - Async RL. vLLM или SGLang живут в отдельном контейнере, роллауты идут асинхронно через Ray, веса уезжают по NCCL (по EFA 53-80 GB/s, gpt-oss-120b обновляется за 3-4 секунды), а генерации во время синка не обрываются. Внутри routing replay, importance sampling с масками, обучение на токенах, которые насэмплил движок, и 11 встроенных сред - от code contests и SWE до тулов через MCP. По механикам это сопоставимо с verl и Miles, только на HF-моделях и без Megatron.
Для студентов и тех, кто только начинает, Halo, мне кажется, хорошая точка входа. Все запускается из одного docker-образа:
halo launch sft config.yaml, а QLoRA Qwen3-4B занимает 7.9 GB и должна работать на 3090/4090. Документации больше 170 страниц, отдельно советую прочитать лекцию GPU Training Theory: база того как работают такие фреймворки, почему эксперты в MoE упираются в память, а не в compute, и почему в EP-шаге 88% времени - это all-to-all. Там же честно написано, что не помогает и что тихо ломает, например TF32 по умолчанию в NGC-образе, портящий RoPE после 2048 токенов.Выложили и модель - GLM-4.7-Flash-Coder, 30B MoE под агентские скаффолды: SFT на 7.8k успешных траекторий GLM-5.1, на SWE-rebench-V2 pass@1 вырос с 33.2% до 41.7%, а модель сама научилась вызывать тулы параллельно. Она уже слегка устарела, но как гайд по агентскому SFT актуальна.
Код мы пишем с агентными скаффолдами и сильными моделями вроде Claude Fable и Opus, репозиторий под это спроектирован. Контрибьт приветствуется, но через фильтр: сначала issue и approve мейнтейнера, потом PR. Главное правило - понимать свой код: с AI писать можно, но это нужно раскрыть, а тесты должны падать, когда ломается поведение.
Дальше больше: Pipeline Parallelism (все уже в коде, но докатим после полных тестов) и серия блогов про тренировку, например про async RL для code contests. Лицензия Apache 2.0.
P.S. Если помните такую вещь как SMPO из времен Vikhr, то он теперь тоже живет там, но уже с EP и CP и улучшениями.
Post #1355
179
Еще чуть про партии и выбор:
Типа где партия мужчин и отдельно партия женщин?
Где партия детей, подростков, молодежи, взросляков? Пенсов есть уже, спасибо.
Партия скуфов и партия метросексуалов.
Типа где партия мужчин и отдельно партия женщин?
Где партия детей, подростков, молодежи, взросляков? Пенсов есть уже, спасибо.
Партия скуфов и партия метросексуалов.
- 😁 6
Post #1354
183
Сходил в посольство.
Очень стильные дипломаты у нас. Речь, выправка.
Сама локация со строгим советским (в хорошем смысле) лоском - всегда в восторге от этого места.
Очень стильные дипломаты у нас. Речь, выправка.
Сама локация со строгим советским (в хорошем смысле) лоском - всегда в восторге от этого места.
- ❤ 4
Post #1353
188
Forwarded from AGDchan
Говорят, сто Сбер и вправду делает что-то свое в области ИИ. Раз так, то это замечательно.
- 😁 2
Post #1352
186
Легенда.
Post #1351
198
Forwarded from Love. Death. Transformers.
го сходим накидаем голосов против единой россии? заебали уже
- 👍 6
Post #1350
221
у админа есть яйца
- 👍 2
- 🤯 2
- 🤡 1
- 🥴 1
About this channel
- How can I read @anai8 without a Telegram account?
- TGViewer shows the public web preview Telegram publishes for #N/A: recent posts, photos, videos and the subscriber count, with no app, login or account.
- How many subscribers does #N/A have?
- #N/A (@anai8) has 190 subscribers on Telegram, refreshed roughly every 30 minutes.
- Does #N/A know I viewed it here?
- No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.