
Неотъемлемая часть научной деятельности — делиться результатами исследований на профильных мероприятиях, конференциях, семинарах. И часто — говорить об одном и том же на разных площадках. Но я все еще порой ловлю себя на мысли: «Зачем повторяться? Все уже в курсе!». Так же иногда думают и мои подопечные, особенно начинающие. Но практика показывает: напоминать о значимых работах не только можно, но и нужно.
Очередным поводом задуматься на этот счет стало мое участие в конференции Сбера по рекомендательным системам. Но дело не в моем докладе. Несколько раз была затронута тема масштабирования трансформерных моделей для работы с большими каталогами. Проблема лежит на поверхности: чтобы ранжировать товары из огромного каталога, модель по сути решает задачу экстремальной классификации, где число классов равно числу товаров. Попытка вычисления полной кросс-энтропии в таком сетапе мгновенно исчерпает память даже самой современной GPU. Классический выход — аппроксимация. В небезызвестной модели SASRec авторы заменяют полную кросс-энтропию (CE) бинарной с сэмплированием отрицательных примеров (BCE). Этим достигается некоторый компромисс между нагрузкой на память и качеством модели. Но итоговый результат зачастую оказывается заметно слабее варианта с полной CE.
Над улучшением такой аппроксимации стали активно трудиться в последние годы. Уместно вспомнить подход gBCE Александра Петрова, реализующий поправки к сэмплированной BCE. Позднее командой Алексея Васильева был показан способ аппроксимации CE напрямую, реализующий механизм внутрибатчевого сэмплирования как в GRU4Rec. Об этом механизме было как раз упомянуто на конференции Сбера в докладе Дарьи Тихонович. В той же секции был и доклад Кирилла Хрыльченко об успехах в дальнейшем улучшении сэмплированной CE на основе корректирующей нормировки к софтмакс-распределению.
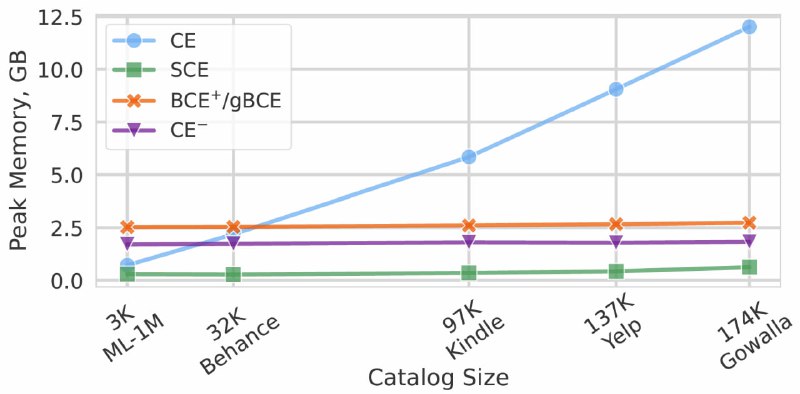
Но за кадром обсуждений остался еще один подход с принципиально другим взглядом на исходную постановку. Еще в 24-м году на конференции ACM RecSys 2024 мы показали, что проблему эффективного обучения на основе полной CE можно свести к задаче MIPS (Maximum Inner Product Search). Для ее решения мы применили рандомизированный подход (по заветам уже классической работы) и получили не только сокращение пиковой нагрузки, но и увеличение метрик качества. В частности, при качестве на уровне полной CE, наш подход Scalable CE (SCE) позволяет сократить нагрузку на память в 100 раз, заодно ускоряя обучение почти в 7 раз. А если есть возможность не ограничивать память — прирост метрик может составить до 18%. Это уже относительно SOTA-варианта сасрека на основе CE!
Почему же в 2025 году не звучат упоминания нашего подхода? Спишу это на то, что слишком мало повторял об успехах. Исправляюсь. Мы сами постоянно используем данный подход для эффективной утилизации наших ресурсов. Если и вам это кажется полезным, но не знаете с чего начать — посмотрите в наш репозиторий. Или обращайтесь напрямую — покажем, поможем донастроить под ваши нужды. Независимо от того, сотрудник вы компании, отвечающий за внедрение моделей в свой контур, или студент, поднимающий свой pet project — приходите, мы проконсультируем, поможем извлечь максимум из обучения. А если вы уже пробуете наш метод или только планируете, дайте обратную связь. Для нас это очень ценно.
Post #11
1.09K
- ❤ 14
- 👍 10
- 🔥 3
- 💯 2
- 👏 1
- 🤩 1
- 🏆 1