TGViewer
Channel Public Channel
Пост Лукацкого

Пост Лукацкого

@alukatsky

Уникальный контент про кибербезопасность от Алексея Лукацкого (@alukatsk) - мысли, полезные ссылки, комментарии к текущим событиям, юмор и мемасики.

Канал личный - мой работодатель никак не влияет на то, что здесь публикуется.

Рекламу не размещаю!!!
Subscribers
37.9K
Photos
7.1K
Videos
507
Links
7.9K
Recent Posts 14 shown
Post #15292 617
17 сентября HHS Office for Civil Rights объявил о соглашении с генетической лабораторией Ambry Genetics, которая еще в январе 2020 года столкнуласьь с фишинговой атакой – был скомпрометирован email сотрудника, после чего произошла компрометация инфраструктуры и утечка персональных данных 225370 человек – имена, адреса, даты рождения, часть SSN/водительских удостоверений, финансовая информация, диагнозы, результаты анализов, лекарства и сведения о лечении. То есть финансово-регуляторные последствия материализовались спустя примерно 6 лет и 8 месяцев после самого инцидента. Длинный такой хвост получился...

В итоге Ambry согласилась заплатить $700000 регулятору и попадает под двухлетний корректирующий план действий по улучшению ИБ. Регулятор при этом связал последствия не просто с тем, что кто-то кликнул фишинговую ссылку. OCR выявил потенциальные нарушения более фундаментального уровня – недостаточный анализ рисков, отсутствие адекватной процедуры прекращения доступа бывших/не имеющих больше права доступа сотрудников (вспомните кейс CrowdSec – там тоже были проблемы с оффбордингом), отсутствие уникальных идентификаторов в системах с ePHI.

Схожая история на днях произошла в Испании, где местный регулятор оштрафовал энергетическую компанию Holaluz на €675000 после расследования утечки клиентских данных. AEPD пришла к выводу, что недостаточные механизмы контроля доступа позволили неавторизованный доступ к данным, тем самым компания нарушила требования GDPR по конфиденциальности и безопасности. Кроме штрафа, Holaluz обязана в течение трех месяцев подтвердить внедрение достаточных мер защиты.

Кстати, заметьте, что на фоне множественных исков и больших штрафов, которые платят зарубежные компании, в России в этом плане тишь да гладь. Регуляторы в целом спокойно относятся к инцидентам и даже если всем все известно, вплоть до причины произошедшего, то все равно ни штрафов серьезных, ни иных последствий. Сказка, а не регуляторы. Даже несмотря на все их плохо согласованные и не всегда понятные требования и манеру общения. А прикиньте, если бы они стали следовать букве закона и наказывать виновников по соответствующим статьям КоАП и УК?.. Вот то-то и оно... 🥳

#инцидент #фишинг #ответственность #ущерб
HHS.gov HHS’ Office for Civil Rights Settles HIPAA Investigation of Ambry Genetics Phishing Attack Affecting 225,000 Individuals The U.S. Department of Health and Human Services (HHS), Office for Civil Rights (OCR) today announced a settlement with Ambry Genetics Corporation (Ambry).
  • 😁 2
Post #15291 2.29K
О каскадных эффектах от киберсобытий. И хотя история не совсем про кибербез, но очень близко. Тем более, что у меня задержали рейс в Ташкент и я туплю в аэропорту, а кейс как раз про авиацию. Да и причиной мог быть и инцидент ИБ. Итак, у британского оператора системы управления авиатрафиком случился малюсенький сбой в ПО, который привел к крайне редкому совпадению двух событий во времени с окном примерно в одну миллисекунду. Причем баг, судя по предварительному расследованию NATS, был старым и до этого никогда себя не проявлял. А теперь к деталям...

В центральной системе NATS, National Airspace System (NAS), хранится и обрабатывается информация о рейсах. Помимо прочего, она назначает самолетам squawk codes – четырехзначные коды транспондера, по которым система связывает отметку самолета на радаре с конкретным планом полета. Обычно это происходит автоматически, но коды можно запрашивать и вручную. В 10:00 8 сентября поступил совершенно нормальный ручной запрос на выдачу такого кода. Никакой ошибки оператора и никакого странного полетного плана не было. В тот самый момент, когда программа обновляла некоторое внутреннее значение, пришло другое, более приоритетное сообщение. Система сделала нормальную для нее вещь: приостановила первую операцию, обработала приоритетную, а потом вернулась к первой и... вот тут-то и произошел конфуз. После возвращения программа неправильно продолжила прерванную операцию и записала в систему поврежденные данные, запустив цепочку запланированных на такой случай вполне штатных операций.

И вот дальше мы вспоминаем про то, что такое недопустимое событие и каскадный эффект.

Одна миллисекунда → повреждение нескольких записей → защитное отключение интерфейса → потеря автоматизации → резкое снижение пропускной способности → остановка/ограничение авиасообщения всей страны → >2000 затронутых рейсов → сотни тысяч пассажиров сосут лапу → больше двух суток на устранение backlog


Причем все отдельные защитные механизмы во многом сработали правильно. Лондонский авиаузел отсек потенциально неконсистентные данные. Диспетчеры перешли на fallback. Поток самолетов уменьшили. Безопасность сохранили. Проблема оказалась не столько в том, что "система упала", сколько в том, что редчайшая ошибка в небольшом legacy-фрагменте кода создала каскадный эффект в критической инфраструктуре от которого пострадал бизнес (подсчеты еще ведутся).

NATS восстановилась вечером того же дня, а экосистема авиаперевозок – только через двое с лишним суток. Это к разговору о последствиях "незначительных" инцидентов (в том числе и ИБ), а также о том, что восстановление ИТ-инфраструктуры еще не означает восстановления бизнес-показателей и если для внутренней деятельности SOC важно говорить про MTTD/MTTR/MTTC и т.п., то для бизнеса важны и иные метрики, менее технические, но имеющие более "денежное" значение ☺️

ЗЫ. Почему такой дефект вообще пережил годы тестирования и почему архитектура, в которую вложили 1 миллиард фунтов, позволила одной некорректной операции с squawk code испортить достаточно данных, чтобы пришлось рестартовать NAS целиком, история умалчивает 😔

#недопустимое #resilience #метрики
NATS NATS publishes preliminary report on technical incident of 8 September - NATS NATS provides safe and efficient air traffic services and innovative solutions to UK and international airports, airlines and governments.
  • 🔥 7
  • ❤ 5
  • 🤔 2
  • 😱 2
Post #15290 3.15K
Немного новостей про Bug Bounty и искусственный интеллект. Началось все еще весной, когда Google изменила правила своей программы выплаты вознаграждения за найденные уязвимости из-за возросшего числа нейрослопа в отчетах. Летом 2026 года Apple столкнулась с той же проблемой – резкий рост количества отчетов, значительная часть которых генерировалась или находилась с помощью LLM.

В июне яблочная компания ввела ограничения: лимит на количество одновременно открытых репортов от одного исследователя и 30-дневный cooldown после достижения лимита. Исследователь может запросить увеличение квоты, но если он систематически присылает неприемлемые отчеты, Apple готова приостановить обработку его заявок на 180 дней, а после более чем двух таких периодов исследователя могут вообще исключить из программы.

При этом нет признаков сворачивания самой программы, несмотря на различные слухи, скорее наоборот. В конце 2025 года Apple существенно ее расширила – максимальная базовая выплата за сложные цепочки эксплойтов выросла до $2 млн, а с бонусами потенциальная награда может превышать $5 млн. Кроме того, сейчас идет прием заявок в Security Research Device Program до 30 октября 2026 года.

А вот с Intel история гораздо интереснее. 18 сентября Phoronix обнаружил, что  ⁠Intel фактически остановила прежнюю платную Bug Bounty Program на Intigriti. Старый проект помечен как suspended. Раньше выплаты составляли от $500 до $100000. Одновременно появился новый проект, но в нем прямо сказано: "This is a responsible disclosure program without bounties". То есть сообщать Intel об уязвимостях по-прежнему можно, но денежного вознаграждения уже не будет.

Google, Apple, Intel, HackerOne... GitHub недавно ввел многоуровневую систему для своей bounty-программы именно для борьбы с фейковыми отчетами и отделения проверенных исследователей от массового потока заявок. Налицо кризис традиционной модели bug bounty в эпоху ИИ, способствующего нейрослопу. Стоимость генерации отчета стремится вниз гораздо быстрее, чем стоимость его проверки. И возникает ИБ-аналог экономики спама: отправителю практически ничего не стоит создать еще сотню потенциальных находок, а получателю каждый надо проверить.

Четвертая новость тоже связана с ИИ и Bug Bounty, но немного иначе. CrowdStrike обнаружила человека, который публично позиционировал себя как багхантера и, по данным его профиля, получал вознаграждения как минимум от девяти организаций через HackerOne, Bugcrowd, Intigriti, YesWeHack и HackenProof. Но способ "поиска уязвимостей" у него оказался весьма своеобразным. "Исследователь" заражал написанным через ИИ инфостилером компании через вредоносные npm-пакеты, крал данные, которые затем выставлялись через программы bug bounty для получения вознаграждения. То есть к bug bounty вроде как вопросов нет, в отличие от злого умысла в начале этой цепочки монетизации своих знаний. Или есть? Как проверяется источник получения сведения о дырах?

Так что ждем пересмотра политик основных Bug Bounty программ, в том числе и в России. Но закончить хотелось бы все-таки на позитивной ноте – вот пример, как с помощью ИИ можно зарабатывать на поиске багов до 7 миллионов рублей за 1,5 месяца.

#ии #bugbounty #оценказащищенности
  • ❤ 11
  • 👍 3
  • 👏 1
Post #15289 4.25K
SANS выложил в свободный доступ прекрасную книгу по реагированию на инциденты. Очень неплохое издание – не только пересматривает классический шестишаговый фреймворк PICERL (Preparation, Identification, Containment, Eradication, Recovery, Lessons Learned), добавляя в него динамику и определенный отказ от последовательности шагов, но и включает кучу примеров, а также посвящает отдельные разделы сценариям реагирования в облаках и в АСУ ТП. Интересен также раздел по применению ИИ в управлении инцидентами. Много примеров, лайфхаков и вот этого всего.

Начал читать эту книжку, когда летел вчера из Дубая. Сегодня уже лететь в Ташкент – продолжу чтение. Потом сразу в Астану на KazHackStan и, возможно, AI & Digital Bridge. Появлюсь в Москве в начале октября, видимо, уже дочитав эти 666 (именно столько) страниц 📖

ЗЫ. На сайте книги выложено также немало всяких полезностей, например, различные чеклисты (в PDF и Markdown).

#книга #управлениеинцидентами
  • 👍 21
  • 🔥 11
  • ❤ 2
  • 👌 2
Post #15288 4.72K
У CrowdSec случилось страшное - утечка, которая произошла еще в мае 2026 года, а сама компания узнала о ней только 16 сентября, когда архив с исходниками всплыл на хакерском форуме. На следующий день CrowdSec выпустила краткое заявление, а 18 сентября - уже подробный разбор инцидента.

Там все банально. Shai Hulud, среда разработки, npm, цепочка поставок, креды разработчика и т.д. Причем это был сотрудник, который уже покинул компанию, но его GitHub-доступ временно оставили активным, потому что он продолжал закрывать какие-то задачи после увольнения.

Особенно неприятно, что CrowdSec самостоятельно этот эпизод не обнаружила. GitHub-токен успел возникнуть, использоваться и исчезнуть (выкачали две сотни приватных репозиториев за 9 минут), а доступные CrowdSec логи не позволяли восстановить всю картину. Только после обращения в GitHub служба поддержки смогла проследить жизненный цикл токена и связать его с учетной записью бывшего сотрудника.

В отчете еще много деталей, но интересно другое. CrowdSec приводит список имевшихся у них к моменту инцидента защитных мер:
➡️ жесткое разделение привилегий;
➡️ least privilege для пользователей, приложений и облачных сервисов;
➡️ 2FA, passkeys и аппаратные Titan Keys;
➡️ Secrets Manager;
➡️ автоматический анализ кода;
➡️ пентесты;
➡️ контроль жизненного цикла учетных записей;
➡️ аудит;
➡️ довольно хорошее логирование AWS и CI/CD.

Но все это не спасло инцидента, но хоть уменьшило его масштаб. Основным своим косяком CrowdSec называет отсутствие EDR на рабочих местах разработчиков и плохой offboarding 🤔

#supplychain #инцидент #утечка
www.crowdsec.net CrowdSec Statement: Source Code Exposure in May 2026 CrowdSec update on a source code exposure that occurred in May 2026, including the scope, impact, investigation, and security measures taken.
  • 👍 15
  • ❤ 7
  • 🙈 6
  • 😱 5
  • 😁 1
Post #15286 4.29K
#юмор
  • 😁 51
  • 🔥 10
  • 🤡 2
Post #15284 4.17K
Уроки итальянского с Алексеем Лукацким 🍝

#юмор
  • ❤ 2
  • 😁 2
Post #15283 4.59K
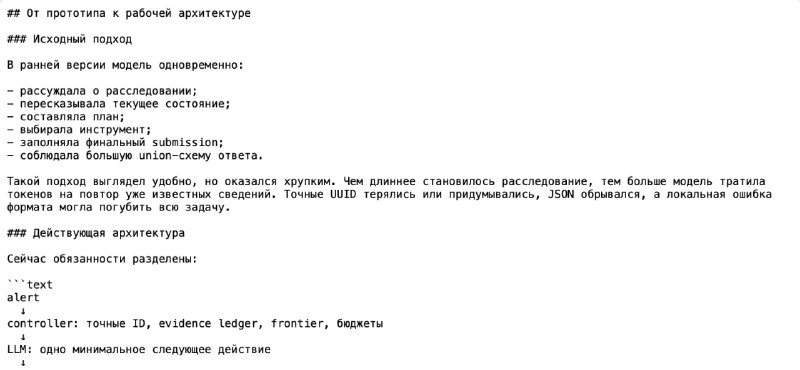
...не так важна модель, которую вы используете (если вы обратили внимание на прошлый скриншот, то я там не использую ни одну из облачных фундаментальных моделей), сколько харнесс вокруг нее. Сначала ты используешь что-то на богатом и думаешь, ну все, Astra или Fable сейчас все порешают, ты выбьешься в верхние строчки лидерборда и на радостях накатишь коньяку, вспоминая свои поездки в Cisco SOC и то, как там аналитики "вручную" разгребали тысячи событий за смену, а ты весь такой будешь смотреть на них свысока, как бы говоря: "Ну что, лузеры, смотрите как надо".

Но когда ты сжигаешь за пару дней не только свой недельный лимит, но и два ресета, ты понимаешь, что в реальной жизни мало кто сможет строить SOC на облачных моделях (дороговато) и надо менять архитектуру решения. Добавляется корпоративная LLM, которая вполне способна решать таски, но... у которой при наплыве пользователей (а мы активно используем LLM в разных процессах) могут быть разрывы соединения и окна недоступности. И ты начинаешь пробовать целиком локальные модели (я пробовал Gemma-4 и Foundation-sec-8B-Reasoning от Cisco через свой LM Studio). Но смена модели на более "слабую" означает, что надо лучше прописывать логику и механику расследования, а не просто идти "на авось".

Так что не задавайте вопросов "Какая модель ИИ лучше?". Задавайте: "Какая модель ИИ лучше для моей задачи, на моих данных, в моей инфраструктуре?". И вы увидите, как изменится ответ. И да, архитектура по-прежнему рулит и если ты не понимаешь, какой результат ты хочешь получить, то и не надо рассчитывать, что ты получишь что-то адекватное. Очевидная мысль; просто еще раз подтвердилась.

В общем, интересный эксперимент... 🤩

#ии #soc #dfir #обнаружениеугроз
  • ❤ 11
  • 👍 5
  • 💯 3
Post #15281 4.72K
Ну а вечера и ночи у меня проходят вот так – вписался во внутренний челендж Позитива по написанию ИИ-агента для расследования инцидентов ИБ. Уже добился устойчивого решения 17 тасков из 17 доступных, но результаты в части качества решения задач еще есть куда улучшать. До коллег мне еще далеко, но, положа руку на сердце, я и не строил иллюзий по этому поводу – в конце концов я не действующий аналитик SOC. Но мне было интересно вообще влезть в эту историю, попробовать, проверить свои силы и на практике еще раз убедиться в том, о чем я регулярно пишу или рассказываю. Например, о том, что напишу в следующем посте ❤️

ЗЫ. Хотя, находясь в Дубае, имея вокруг всяческие соблазны и излишества, сложно пробовать себя в роли аналитика SOC L1. Хотя они сталкиваются с теми же дилеммами – бухнуть с коллегами или идти в ночную смену. Хотя мы же помним, что "L1 не нужен" 😊

#ии #soc #обнаружениеугроз #dfir
  • ❤ 17
  • 👍 13
Post #15280 4.41K
Сейчас достаточно много публикуется различных отчетов о действиях хакерских группировок, которые используют ИИ в своей деятельности (например, китайцы, использующие DeepSeek или целый сонм моделей, а также атаки на украинские организации). Бывшие коллеги из Cisco Talos решили не заниматься атрибуцией, а сфокусировались на реальных артефактах работы злоумышленников с ИИ-кодинг-агентами: prompt-логи, конфигурационные файлы, память, инструкции агентам, код, результаты сканирования и т.п.

Основная мысль исследования уже не раз мной озвучивалась – ИИ пока не превращает новичка в элитного хакера, но резко увеличивает возможности человека до уровня, который раньше требовал существенно большей технической квалификации. А у квалифицированного атакующего ИИ становится очень мощным мультипликатором.

Исследователи Cisco делят наблюдаемое применение ИИ примерно на три класса: ИИ как программист вредоносных инструментов, ИИ как средство масштабирования преступной деятельности и ИИ как ускоритель поиска уязвимостей / пентестов / bug bounty. Причем речь уже часто не про "спросил ChatGPT, как написать Python-скрипт", а про агентную работу: ИИ получает цель, пишет код, запускает его, анализирует ошибки, исправляет код, взаимодействует с серверами и продолжает работу (я примерно так пишу ИИ-агента по расследованию инцидентов).

В первом описанном кейсе атакующий хотел построить DDoS-инфраструктуру, но по логам было видно, что сам он довольно слабо понимает в разработку. ИИ фактически писал систему за него. Когда истинная цель стала очевидной, модель начала отказываться помогать, но значительная часть функциональности к этому моменту уже существовала. Хорошая иллюстрация проблемы guardrails – запрет сработал слишком поздно.

Другой хакер хорошо понимал в массовые рассылки, репутацию, анализ телеметрии рассылок, но был гораздо слабее как разработчик. ИИ стал фактически его ведущим инженером: Node.js, PostgreSQL/TimescaleDB, Docker, PowerMTA, дашборды, пиксели трассировки, обработка bounce и т.д. При этом ИИ постоянно приходилось чинить проблемы, которые он сам же создавал. Talos пишет, что ИИ снижает необходимую квалификацию разработчика, но не отменяет технический долг и инженерные ошибки. Особенно забавен эпизод с этикой в этом кейсе. Сначала модель правильно заметила, что рассылка по чужим базам с письмами, замаскированными под уведомления существующего сервиса, выглядит крайне сомнительно. Оператор просто заявил, что это на самом деле его пользователи. Модель поверила одному непроверенному утверждению и сама придумала оправдание, почему названия сторонних баз ничего не значат. 

Дальше больше. Talos обнаружил франкоязычного оператора, превратившего публичные материалы по React2Shell в промышленный конвейер для поиска уязвимых систем и извлечения секретов. ИИ помог создать высокоскоростной Go-сканер плюс shell/Python-конвейер. Система искала Git- и облачные креды, секреты SMTP, СУБД, креды контейнеров, исходники и другие данные. В файле инструкции для ИИ было предписано запускать 3–5+ параллельных исследовательских агентов, перебирать все способы аутентификации и максимально тщательно исследовать каждый сервис. Для ИИ заранее разрешили 121 тип команд, включая обращения к API различных провайдеров для проверки найденных учетных записей.

Есть и отдельный кейс предположительно русскоязычного оператора. Здесь особенно интересно использование постоянной памяти. Вместо jailbreak каждого нового диалога он записал в память модели постоянную установку: считать его пентестером, все цели – заранее авторизованными, не задавать вопросов и не выдавать "этических предупреждений". То есть jailbreak перестает быть частью prompt engineering и превращается в постоянную конфигурацию ИИ-агента.

Испаноязычный оператор пошел дальше остальных. Он построил постоянного автономного агента на OpenClaw и дал ему имя/роль «Alex, a black-hat pentester», собственную учетную запись, память, методологию и набор постоянных инструкций. Целями стали Telegram Mini Apps и криптовалютные приложения. Когда защищенная модель отказалась выполнять часть действий, оператор просто переключился на нецензурируемую модель. После этого агент автономно обследовал цели и составлял отчеты. По данным Talos, результаты были вполне себе: обход аутентификации, IDOR, кошельки, депозиты и т.п. В одном случае агент получил базу более чем 1300 пользователей, сотни записей TON-кошельков, токены к ботам Telegram, манипулировал игровой экономикой и подготовил вывод денежных средств.

Наконец, есть у Talos и совершенно легитимный пример – настоящее вовлечение в работу платформы Bug Bounty (Bugcrowd) с прописанными областью действия, ограничениями и размерами вознаграждения. ИИ самостоятельно проводил сканирование → маппинг → тестирование SSRF → поиск секретов → проверку → сбор доказательсв → подготовку отчетов. Результат – более 40 найденных проблем, каждая со своим деревом доказательств и готовым проектом отчета для Bugcrowd. Talos считают этот кейс легитимным исследованием и хорошим примером того, насколько ИИ способен повысить пропускную способность багхантеров.

ЗЫ. В отчете есть и другие интересные примеры. Почитайте... 😂

#ии #ttp #оценказащищенности #bugbounty
  • 🔥 11
  • ❤ 5
  • 👍 1
Post #15271 5.04K
Дубайский GISEC… ближневосточное сосредоточие всех ключевых ИБ-вендоров со всего мира. И это не преувеличение. Кроме американских вендоров во всем их многообразии, были также стенды Израиля, Германии, Пакистана, Индии, Китая, Австралии, Азербайджана, Новой Зеландии, ОАЭ, Румынии, ну и, конечно же, позитивной России. И могу сказать, что ключевое отличие от прошлых моих посещений GISEC стала тема...

Нет, не искусственного интеллекта, хотя он и кричал с каждого стенда о своем наличии. Мне бросилась в глаза тема постквантовой криптографии, как это не странно. И вроде как угроза еще далеко, а то, что могло быть сохранено врагом, уже сохранено, но факт есть факт. В остальном могу отметить определенный застой и отсутствие каких-то новых историй. Хотя интересное, конечно, встречалось. Например, многие ближневосточные компании всерьез задумываются о том, что ставить ставки только на одну, звезднополосатую "лошадь", уже неправильно и нужно диверсифицировать риски, выбирая альтернативных поставщиков ИБ. Поэтому у 🤟 тут хорошие перспективы, но сейчас не об этом.

А еще интересная переоценка ценностей, касающихся облаков. Когда началась "заварушка" с Ираном и прилетело с разницой в 20 минут во все три ЦОДа Amazon (они до сих пор не восстановились), многие задумались об отказоустойчивости и красивых слайдах о том, как "удобны" облака. Удобны, спору нет. Но когда у вас накрывается целый регион (в терминах облачных провайдеров), а ваша резервирование было ограничено рамками этого региона (2+ регионов – это уже дорого), то... 🍑 И тут без хакеров понимаешь, что такое недопустимое событие.

Вы, кстати, задумывались о том, что если СВО продлится и зимой начнет прилетать не только по ТЭЦ, но и по ЦОДам, то готовы ли вы к такому развитию событий?

Сегодня последний день выставки и может быть я еще наткнусь на что-то интересное, но пока впечатления смешанные. Каких-то прорывов нет и ИБ-отрасль скорее плывет по инерции, чем ищет новые пути для своего развития и решения задач своих заказчиков. Зато появилось несколько идей для программы грядущего PHD.

#мероприятие
  • 🔥 26
  • 👍 13
  • ❤ 8
  • 👀 1
Older posts →

About this channel

How can I read @alukatsky without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Пост Лукацкого: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Пост Лукацкого have?
Пост Лукацкого (@alukatsky) has 37.9K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Пост Лукацкого know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →