
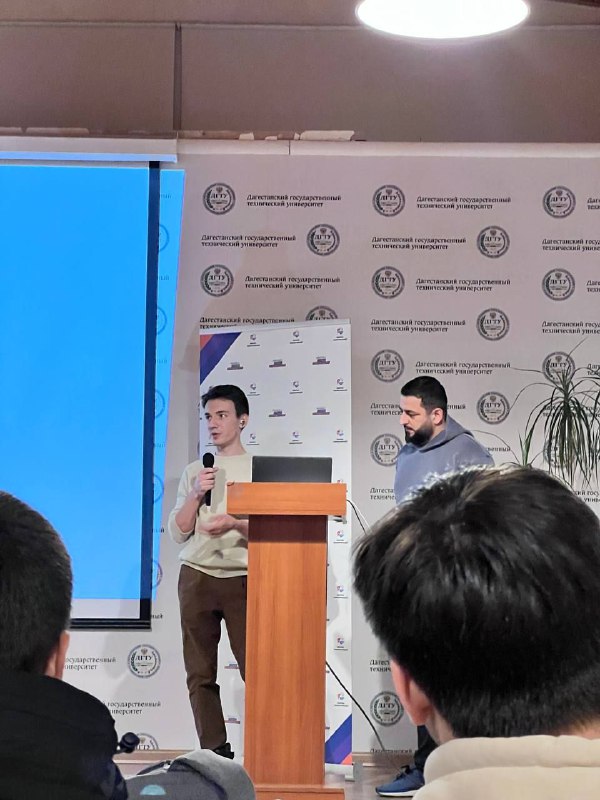
Это я в Дагестанском Технологическом Университете рассказываю про последние наши разработки, как ИИ помогает сохранять языки малых народов. И призываю других энтузиастов присоединяться к нам и делиться опытом и экспертизой.
Два месяца назад я писал про платформу для краудсорсинга параллельного языкового корпуса. А в последний месяц мы один за другим проводили эксперименты по созданию Text-to-Speech модели. И тут есть, чем поделиться)
Для того чтобы натренировать такую модель, нужно иметь довольно большой размеченный датасет (аудио+текст). Качество аудио должно быть близко к идеальному. Поэтому обычно созданием таких моделей занимаются корпорации, либо используются открытые датасеты. На русском и английском, например, таких датасетов довольно много. Но чтобы у небольшого народа была проделана такая работа - это большая редкость.
И тут нам очень повезло. В рамках работы над переводчиком мы познакомились с еще одним энтузиастом, основателем PublicDictionary, который горел идеей создания синтеза речи для малых народов. Он организовал и платформу для записи аудио, и разметку, купил качественные микрофоны и нашел людей, кто очень грамотно говорит на лезгинском. Но модель создать пока что не вышло, хотя попытки предпринимались. Мы решили объединить усилия и поэкспериментировать по правилу 20/80. Так у нас на руках оказался уникальный набор данных.
Для базовой модели выбрали VITS, нашли наработки Meta по созданию модели озвучки текста на базе VITS, подсмотрели, как они работают с фонемами, и начали экспериментировать.
Несмотря на довольно небольшой датасет (30 часов аудио), полученная модель получилась в каких-то местах лучше привычных русскоязычных моделей синтеза речи. На видео я как раз рассказываю про один из примеров, как модель с выражением читает стихи. Однако она все еще не идеальна: есть проблемы с проглатыванием звуков в некоторых сценариях. Но в рамках малоресурсного языка модель такого качества выведена впервые. И рад, что аудитория это тоже заметила и оценила - было приятно получить аплодисменты аудитории после демонстрации примеров работы.
Такие модели значительно упрощают работу с контентом: вы могли и сами заметить, как много подобного видео стало появляться в социальных сетях. Буду надеяться, что наши первые шаги в эту сторону помогут наполнить рекомендательные алгоритмы тиктока, инсты и ютуба, и позволят людям не забывать, как звучит их родной язык.
Post #182
769

- ❤ 35
- ❤🔥 15
- 🔥 14