TGViewer
Channel Public Channel
EdTech, AI и HighLoad | Блог AK из Школково

EdTech, AI и HighLoad | Блог AK из Школково

@ak_segfault

CEO ZeroAgency, руководитель разработки онлайн-платформы Школково.
Пишу про IT, AI и HighLoad разработку.
Личный блог: @daily_ak
YT: youtube.com/@segfault_11
Контакт для связи: @bethrezen
Subscribers
2.85K
Photos
271
Videos
16
Links
74
Recent Posts 16 shown
Post #367 1.38K
Обещал рассказать про обучение LLM с нуля.

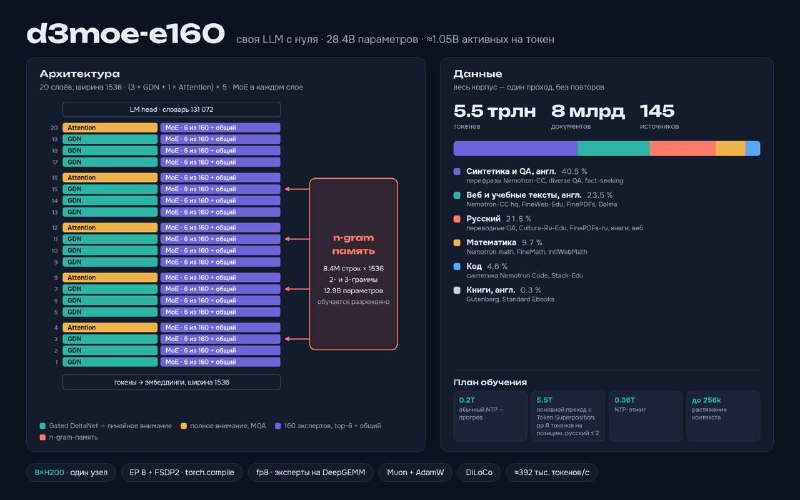
Итак, что же я делаю. Обучаю с нуля свою языковую модель — d3moe-e160. Короткий отчёт о первых полутора сутках.

Архитектура — гибрид:
• 20 слоёв, ширина 1536. На каждые три слоя Gated DeltaNet (линейное внимание) приходится один слой полного внимания (MQA, FlashAttention-4).
• MoE в каждом слое: 160 экспертов, на токен работают 6 плюс один общий. Сигмоидный роутер, балансировка без aux-loss.
• n-gram-память (в духе Engram): отдельная хэш-таблица на 8.4 млн строк × 1536 для 2- и 3-грамм. На каждом токене модель достаёт строки своих n-грамм и подмешивает их в слои 2, 6, 10 и 14 через обучаемый гейт. Таблица разложена по 8 GPU и обновляется разреженно — только строки, которые встретились в батче.
• Всего 28.4B параметров: ≈15.1B в экспертах, ≈12.9B в n-gram-таблице; на токен активно ≈1.05B. Словарь — свой BPE на 131k.

Данные: ≈5.5 трлн токенов за один проход, без повторов. Русского около четверти, остальное — веб, учебные тексты, код, математика, книги, синтетика.

Как учим:
• Один узел 8×H200: expert parallel 8 + FSDP2, torch.compile, fp8 (эксперты — на DeepGEMM).
• Muon для матриц, AdamW для остального, разреженный оптимизатор для n-gram-таблицы.
• План: 0.2T токенов обычного next-token prediction, затем основной проход с Token Superposition Training (до 8 токенов на позицию, для русского — не больше 2), затем ntp recovery стадия на самых качественных и важных для моей задачи данных и растяжение контекста до 256k.
• Всё крутится внутри DiLoCo: к трейну можно подключать другие серверы. Схема, где сервер-остров шлёт градиенты прямо в оптимизатор главного узла, прошла проверку качества — подключим на финальном NTP-этапе. Пока что у нас только один дополнительный сервер с 4x RTX Pro 6000 - даст примерно +15% tok/s к трейну.
• Скорость ≈392 тыс. токенов/с, шаг ≈1 с.

Где сейчас: 32.7 млрд токенов, ~5 % пути. На чекпоинте 64k: MMLU (5-shot) 0.35, HellaSwag 0.59, GSM8K (8-shot) 0.12 — и всё растёт от чекпоинта к чекпоинту.

Как модель пишет на чекпоинте 80k (жадная генерация, чистый претрейн без чата):

→ «Задача: У Маши было 12 яблок. Она отдала 5 яблок брату, а потом купила ещё 8. Сколько яблок стало у Маши? Ответ:»
«У Маши изначально было 12 яблок. Она отдала 5 яблок брату, что привело к 12 - 5 = 7 яблокам. Затем она купила ещё 8 яблок, что привело к 7 + 8 = 15 яблокам. <…> Ответ — 15»

→ «The capital of Canada is»
«Ottawa, which is also the capital of the province of Ontario. Ottawa is the seat of the federal government of Canada…»

→ «Столица Австралии — город»
«Мельбурн, расположенный на реке Флит-стрит…» — факты о мире ещё впереди, модель видела еще очень мало данных.

Окончание претрейна — ориентировочно во второй половине ноября.
  • ❤ 15
  • 👍 8
  • 🔥 4
Post #365 1.13K
😋Очередной AI-хайп — на этот раз вокруг Jev от TypeSafe AI.

И судя по некоторым постам, человечество опять изобрело новый вид нейросетей. Поэтому давайте быстренько разберёмся, что там на самом деле.

Jev — это не LLM в привычном смысле. Он вообще не генерирует текст.

На вход ему дают state + набор типизированных вопросов, а на выходе получают choice / score / probability с вероятностями. Причём все решения считаются параллельно, без авторегрессивного token-by-token decode.

То есть условно:

LLM:
текст → reasoning → JSON → надеемся, что JSON нормальный → парсим

Jev:
состояние → [A: 0.73, B: 0.21, C: 0.06]

TypeSafe называет это System One Model(кстати сразу заметен всплеск System1 моделей на hf, но это конечно же в основном ерунда) и утверждает, что специально под такую задачу сделали новую архитектуру, parallel sampler и objective RLCD — Reinforcement Learning for Calibrated Decisions.

Официальный анонс: Introducing System One Models & Jev — TypeSafe AI

И вот тут как раз начинается самое интересное.

Чем это отличается от LLM?

LLM — универсальная generative-модель. Она умеет писать код, тексты, рассуждать и т.д., но для банального это spam или not_spam? всё равно запускает довольно дорогой генеративный тракт.

Jev сознательно выбрасывает генерацию строк и оставляет только decision layer: classification, routing, ranking, scoring, moderation, выбор tool'а и подобные задачи.

Поэтому он потенциально намного дешевле и быстрее.

Но погодите. А BERT мы забыли?

Нет 🙂

BERT + classification head делает примерно то же самое уже много лет:
BERT: Pre-training of Deep Bidirectional Transformers

Но обычный BERT-классификатор обучается под фиксированный набор классов. Изменили taxonomy — обычно снова fine-tuning.

У Jev классы/вопросы задаются прямо во время запроса. Сегодня определяем sentiment, завтра выбираем один из 70 tools, послезавтра оцениваем вероятность fraud — отдельную модель под каждый кейс обучать не надо.

Впрочем, и это не появилось вчера.

Например, zero-shot NLI давно позволяет подсовывать произвольные labels.

А ещё есть GLiClass — open-source generalist classifier из 2025 года: dynamic labels, zero-shot/few-shot и один forward pass:
GLiClass: paper | GitHub

Совсем свежий Laya пошёл ещё дальше и фактически воспроизводит саму идею System One: open weights, ModernBERT/mmBERT backbone, typed decisions, probabilities, multilingual:
Laya model/source: 🤗 HF

Так что лично для меня главное в Jev — не «они изобрели классификацию».

Интересна комбинация:
dynamic tasks + calibrated probabilities + отсутствие autoregressive decoding + машинно-типизированный API + отдельный training objective именно под принятие решений.

Это реально очень правильная идея для агентов. Большой LLM совершенно не обязательно должен принимать каждое микрорешение в системе.

Но пока я бы немного придержал слово «революция»: TypeSafe ещё не выложили ни веса, ни полноценный paper с архитектурой и рецептом обучения. Есть официальный анонс, API, бенчмарки и уже первые независимые работы с Jev: Calibrated Decisions at Scale — Jev

В общем — направление мне нравится. Особенно сама идея разделения дорогого «думания» и очень дешёвого decision layer.

Также интересно было бы посмотреть реализацию этого подхода с учётом тренда на рекуррентные и looped transformers.

А я тем временем перестаю читать чужие анонсы, прямо сейчас начинаю претрейн с нуля нашей собственной LLM(подробности позже) и вообще улетаю в отпуск.

Stay tuned ^_^
typesafe.ai Introducing System One Models & Jev - TypeSafe AI Blog TypeSafe AI is an AI lab building machine-native intelligence infrastructure for automation, designed to make decisions within software. Try our first System One Model, Jev, in early access.
  • 🔥 14
  • ❤ 10
Post #364 1.23K
EdTech, AI и HighLoad | Блог AK из Школково Оп-паа. Что это тут у нас? Qwen/Qwen3.8-Flash-Next 125B A6B, 512 экспертов(10 routed + 1 shared) на 640d Гибридный аттеншен: GDN + QSA (QwenSparseAttention) - 12 слоев в 3:1 N-gram Embedding И если посмотреть, это прям во многом похоже на мой незавершенный…
🤷‍♂️ Qwen3.8-Flash-Next не оправдал мои надежды.

Есть у нас вымученный датасет с 89 тасками для агента.
Qwen3.8-27B по качеству сильно опережает Qwen3.8-Flash-Next.
Скорость по tok/s у Flash-Next похожа на 27B-NVFP4.
Тулзов вызывает сильно больше, но даже не смотря на это с задачей справляется хуже, хоть и завершает её быстрее.
Ну и понятное дело, в силу размера модели и новизны архитектуры - тюнить его я даже и не пробовал пока что.

В целом, по трейсам сложилось впечатление, что реальный пре-трейн у модели крайне слабый, как и пост-трейн - примерно на уровне qwen3.5. Видимо в превью как всегда сделали упор на бенчмарках, а не реальных задачах.
Русские знания о мире по моим опять таки ощущениям слабее, чем в qwen3.8-27b. То есть total params + ngram здесь как будто бы ничего не дали.

Возможно в ваших сценариях эта модель и проявит себя лучше.

Тесты проводились на 2 серверах с 4x RTX Pro 6000.
Flash-Next запускался с TP=4 EP=4
Остальные модели PP=4
  • ❤ 13
  • 🔥 10
  • 👀 6
Post #363 871
На злобу дня, так сказать.

Кто-то может не знает, но я не только языковыми моделями занимаюсь. Есть ещё всякие интересные проекты. Один из них - модель для предсказания балла на экзамене и составления индивидуального плана для ученика.
И вот сегодня выходит демоверсии. В некоторых предметах всё очень сильно поменялось. Самое критичное здесь - набор тем и задач.
Всё было бы страшно, если бы я этого не предусмотрел и строил всё вокруг конкретных тем. Но поскольку ЕГЭ не первый раз меняют - я сразу предусмотрел этот момент, сделав True ID-free модель. Поэтому по сути сильно на метриках качества это не ударит.

Такие дела ^_^
  • 🔥 26
  • ❤ 12
Post #362 806

Forwarded from Максим Коваль. ЕГЭ по математике

🔥Как зарабатывать 5 миллионов в месяц на IT и быть счастливым?

Вышел мой подкаст с генеральным директором ZeroAgency и главным разработчиком платформ Школково и Бобр 🦫📱🚀
Поговорили о том, как стать настоящим профессионалом в IT, заниматься любимым делом и при этом хорошо зарабатывать 👇👇👇

🦫 Бобр | 📱 Ютуб | 📱 VK-Видео

Слушайте, вникайте) и не забудьте поставить 👍❤️
  • 🔥 23
  • ❤ 9
Post #361 815
Оп-паа. Что это тут у нас?
Qwen/Qwen3.8-Flash-Next
125B A6B, 512 экспертов(10 routed + 1 shared) на 640d
Гибридный аттеншен: GDN + QSA (QwenSparseAttention) - 12 слоев в 3:1

N-gram Embedding

И если посмотреть, это прям во многом похоже на мой незавершенный эксперимент по LLM с нуля, на который так и не хватило ресурсов

По метрикам естественно интереснее Qwen3.8-27B, 3.7-Plus.
  • 🔥 12
  • ❤ 1
Post #360 945
Кстати, Qwen3.8-27B не просто хороший релиз, но и показатель, куда движется опенсорс.
Это не только хороший качественный RL и post-training.
Лично для меня самое знаковое, это что в 3.8 появился официальный reasoning_effort={low, medium, xhigh}, причём с xhigh default.
Также по сравнению с Qwen3.6-27B, где output рекомендовали выставлять в 32768 tok для обычных задач и 81920 для сложных - в 3.8 уже прямо говорят про 262144 ток.
Т.е. фокус на агентов не просто с контролем "а сколько думать", но и действительно чтобы они выдавали как можно больше полезного контента.

Конечно же, старые добрые chat_template_kwargs с enable_thinking и preserve_thinking из чат-шаблона не выкинули, так что не забывайте про эти параметры тоже.

Ну и сразу вангую, что одним из следующих небольших направлений развития будет не просто привычное сжатие контекста, а сжатие того самого ризонинга на предыдущих шагах - либо просто как обычный compact, либо более хитрые схемы с эмбеддингами/memory/прочими трюками. Кмк, это логичное развитие в сторону решения cost/gpu проблем.
  • 👍 15
  • ❤ 8
  • 🤔 5
Post #355 787
Qwen выпустили Qwen3.8-27B — и это неожиданно большой скачок относительно Qwen3.6-27B 🚀

Это всё ещё dense-модель на 27B параметров, но прирост особенно заметен не на классических knowledge-бенчмарках, а на реальных coding-, agentic- и multimodal-задачах.

Несколько примеров Qwen3.8-27B → против Qwen3.6-27B:
• Terminal Bench 2.1: 63.4 → 73.0
• SWE-bench Pro: 53.5 → 61.7
• DeepSWE 1.1: 13.3 → 42.2 — более чем ×3
• QwenSWEBench: 49.3 → 79.0
• Agents' Last Exam Pass@1: 10.6 → 20.4
• HLE: 24.0 → 30.8
• LiveCodeBench v6: 83.9 → 90.3

Но самый интересный скачок, кажется, произошёл в мультимодальных агентах:
• OSWorld: 63.9 → 84.3
• WebArena: 48.8 → 64.8
• RecreationBench: 29.8 → 47.1
• SWE-MM: 25.7 → 38.6
• Vision2Web: 45.0 → 62.9
• BabyVision: 28.9 → 65.7

Причём на некоторых тестах локальная open-weight 27B уже оказывается на уровне или выше гораздо более крупных закрытых моделей из сравнительной таблицы самого Qwen.
По архитектуре всё как и у qwen3.6-27b - это 64 слоя, d_model=5120, гибрид Gated DeltaNet + Gated Attention, FFN 17,408, multi-step MTP и нативный контекст 262K с возможностью расширения до 1M.

Что особенно интересно: на GPQA прирост всего 87.8 → 89.2, зато на длинных агентских задачах местами +50–200%. Похоже, основной прогресс поколения 3.8 — уже не просто «модель стала немного умнее», а существенно лучше научилась долго планировать, пользоваться окружением, писать и исправлять код и доводить сложные задачи до конца.
На картинках ниже собрал все опубликованные Qwen метрики, сравнил с Qwen3.6-27B и, где возможно, с Qwen3.6-35B-A3B, плюс добавил Qwen3.7-Plus, Muse Glimmer-30B и Opus4.6 Max.
Очень мощный релиз для 27B.

Вот мы и определились, на базе чего будем тюнить мультимодалки ^_^
Для скорости пока что всё ещё юзаем Qwen3.6-35B-A3B, а для качественных задач новый фаворит!

🤗 Веса на HF: bf16 | fp8 | gguf

На openrouter пока что нет, но уже появилось в API на NeuralDeep.ru
  • 👍 11
  • ❤ 3
  • 👀 3
Post #354 826
Почему мне так смешно... 😂
  • 🤯 3
Post #353 1.15K
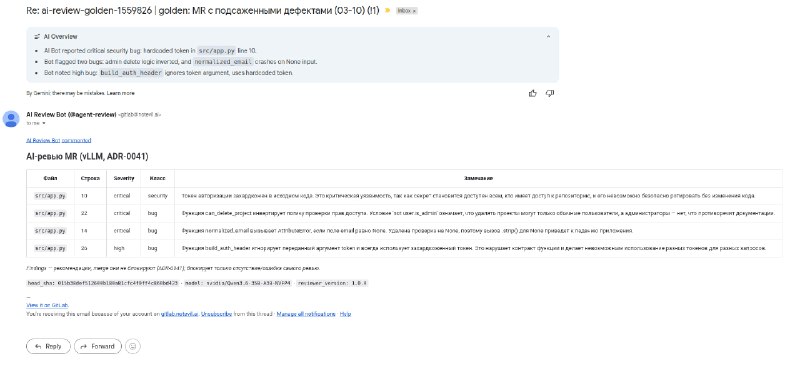
🤖 AI-бот сделал ревью кода.
GitLab прислал письмо об этом.
Gemini в gmail сделал AI Overview.
...
What's next?

PS: ревью кажется тупорылым, потому что это тестовое ревью на тестовом репозитории, так что всё норм на самом деле - это просто PoC
  • 🔥 4
  • ❤ 1
  • 👀 1
Post #352 1.2K
Навайбкодил тут давно статус-лайн с контекстом, затратами, лимитами и прочим.
Работает на Claude Code и Codex.

Кому надо - берите, форкайте/юзайте https://github.com/bethrezen/status-line
  • 🔥 17
  • ❤ 2
Post #351 1.39K
Я научил собаку вайбкодить. А чего добился ты?
  • ❤ 33
  • 🔥 13
Post #350 1.35K
🔥 Бомбическое преимущество Vision LLM для простых рутинных задач

Предыстория
В прошлом году я уже занимался оцифровкой разбалловки результатов учеников для разработки модели предсказания баллов и рекомендательной системы.
Тогда я тоже запилил простой интерфейс и ручками вбивал все эти данные, потому что по-нормальному и быстро автоматизировать это тогда не удалось, а датасет для трейна нужен был срочно.
Из данных я тогда выкинул те, где дети не указали свой тестовый балл в отдельном поле. Ну и понятное дело, очень много результатов, где 10 шакалов из 10, оцифровать не удалось.

Наши дни
Наколеночное решение из поста выше помогло добавить примерно ещё треть к датасету. Это результаты, где не проставлен был балл или разбалловка трудно читалась из-за качества картинки(см. скрин, да-да, в таком качестве прислали результаты...).

+34% к объёму трейн данных - это на самом деле очень ощутимо и круто!

Да, есть риск, что нейронка криво распознала цифры на изображении. Но этот риск снимается прогоном предыдущей модели предсказания баллов по этому юзеру. Если распознавание Vision совпадает с предсказанием модели - значит всё распознано верно и историю этого пользователя можно спокойно добавлять в датасет обучения новой модельки.

Такие дела ^_^
  • 🔥 17
  • ❤ 9
  • 👀 1
Post #349 981
Простое и очевидное решение на коленке, которое сберегло мои нервы.

Дано: тысячи результатов экзаменов учащихся в виде картинок
Задача: оцифровать разбалловку и провалидировать данные

Основная проблема в том, что дети присылают скриншоты результатов максимально странным образом. Плюс есть ещё куча разных сайтов, где эти результаты в разных форматах отображаются.

Это в этом году мы додумались просить детей забивать эти данные самим в форме. А в прошлые года вот что-то не догадались... Ну ничего, сейчас бы с ллмкой быстро всё оцифруем как надо.

Решение: прогоняем через LLM с Vision. В результате большая часть данных нуждается только в быстрой проверке и нажатии на Enter.
  • 🔥 15
  • 👍 10
  • ❤ 7
Post #348 1.92K
🖤 Zero Fest, он же "Ноль фест" в Тамбове 1 августа.

Раньше был "Рок над Студенцом", но по определенным причинам он не смог продолжиться в прежнем формате. Поэтому я решил вписаться в этот движ со своей компанией и помочь ребятам. Ну и теперь это "Ноль фест".

В этом году будут не только местные артисты, но и гости из Санкт-Петербурга.
DenDerty, которые выступали у нас на корпоративе в прошлом году, Молодость Внутри и Вася Васин из группы "Кирпичи".

Для нашего города это уникальное мероприятие, которое всем советую обязательно посетить!

Билеты по ссылке: vk.cc/cYe5vi
  • 🔥 25
  • 👍 10
  • ❤ 8
Post #347 4.03K
🎮 Самый неоднозначный девайс NVIDIA

Брал я тут в марте 7шт. DGX Spark.
Очень хотелось попробовать этот девайс давно - ещё со старта хотел его купить. Но появляться по вменяемым ценам они начали только сейчас.

NVIDIA обещала крутую производительность в FP4.

Но что мы имеем по факту?
1. Очень медленную unified memory LPDDR5x.
2. Коробки очень горячие и уходят в троттлинг. Temperature cap стоит где-то на 70C.
3. DGX Spark инференсит Qwen3.6-35B-A3B в NVFP4 со спекулятивным декодингом DFlash со скоростью 100-200 tok/s. на оптимизированном VLLM с кастомными ядрами под GB10.

Соответственно ШЕСТЬ DGX Spark в реальности у меня дают 700-1500 tok/s.
Для сравнения - ОДИН GPU RTX Pro 6000 Blackwell Workstation даёт 1000-1200 tok/s.
Нагрузка 1-в-1 одинаковая.

Простая математика
RTX Pro 6000 Blackwell стоит примерно 1-1.1M руб.
DGX Spark стоит ~500к руб.

6x DGX Spark = 3M руб. и это в лучшем случае 1500 tok/s, но 768GB памяти на скорости 273 GB/s.
Рабочая станция с 2x RTX Pro 6000 Blackwell - те же 3M руб.(дада, можно и дешевле) и 2200 tok/s, а это всего лишь 192GB VRAM на скорости 1792 GB/s.

И это я ещё не говорю про то, как в реальности работают все эти кольца из 200Gbit/s линков между тремя спарками. Спойлер: плохо.

Выводы
DGX Spark проигрывают примерно везде и по всем фронтам. Обещания NVIDIA - пустой маркетинг.
Коробки вообще никому не рекомендую даже для экспериментов, даже с QLoRa. Для трейна не годится. Для инференса - тоже.
Лучше за те же деньги собрать ПК с игровой видеокартой.

Единственное годное применение - тихий локальный AI-ассистент для дома. Вот только вопрос - сколько он прослужит с такими рабочими температурами.
Telegram Daily AK | Личный блог Во-первых, это красиво.
  • ❤ 16
  • 🔥 8
  • 👍 2
Older posts →

About this channel

How can I read @ak_segfault without a Telegram account?
TGViewer shows the public web preview Telegram publishes for EdTech, AI и HighLoad | Блог AK из Школково: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does EdTech, AI и HighLoad | Блог AK из Школково have?
EdTech, AI и HighLoad | Блог AK из Школково (@ak_segfault) has 2.85K subscribers on Telegram, refreshed roughly every 30 minutes.
Does EdTech, AI и HighLoad | Блог AK из Школково know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →