
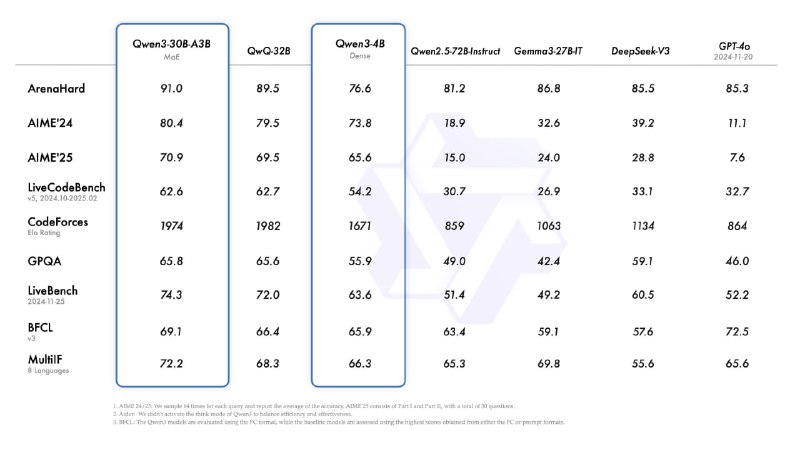
شرکت چینی علیبابا روز دوشنبه مدلهای زبانی جدیدی با نام Qwen3 رو معرفی کرده که بهگفتهی خودش، در برخی سنجشها از مدلهای پیشرفتهی شرکتهایی مثل OpenAI و گوگل هم عملکرد بهتری داشتن. مدلهای Qwen3 با اندازههایی از ۰.۶ تا ۲۳۵ میلیارد پارامتر طراحی شدن و اکثرشون یا هماکنون روی پلتفرمهای Hugging Face و گیتهاب قابل دسترسی هستن، یا بهزودی منتشر میشن. بزرگترین مدل این مجموعه، یعنی Qwen3-235B-A22B، در تستهای کدنویسی، ریاضی و استدلال عملکردی نزدیک یا بهتر از مدلهای o3-mini از OpenAI و Gemini 2.5 Pro از گوگل داشته.
علیبابا گفته این مدلها از معماری هیبریدی و گاهی «Mixture of Experts» (MoE) استفاده میکنن؛ یعنی میتونن بسته به نوع وظیفه یا زمان پاسخگویی، بین حالت "تفکر" و "غیرتفکر" جابجا بشن. این قابلیت باعث میشه که هم کارهای ساده رو سریع انجام بدن، هم مسائل پیچیده رو با دقت بیشتری حل کنن، مشابه عملکرد مدلهای سطح بالایی مثل o3. تیم توسعهی Qwen توی یک پست وبلاگی نوشته: «ما امکان کنترل بودجهی تفکر برای کاربرها رو فراهم کردیم تا بشه عملکرد مدل رو برای هر وظیفه بهطور خاص تنظیم کرد.»
مدلهای Qwen3 از ۱۱۹ زبان پشتیبانی میکنن و با استفاده از دیتاستی شامل بیش از ۳۶ تریلیون توکن آموزش دیدن؛ از جمله متنهای درسی، جفت پرسشوپاسخ، کدهای برنامهنویسی، دادههای تولیدشده توسط هوش مصنوعی و غیره. بهگفتهی علیبابا، این نسخه نسبت به Qwen2 پیشرفت محسوسی داشته و در برخی تستها حتی از مدلهای شناختهشدهای مثل o1 هم بهتر عمل کرده؛ هرچند هنوز هیچکدوم از نسخههاش بهطور کامل از مدلهای ردهبالای بازار پیشی نگرفتن.
بزرگترین نسخهی Qwen3 فعلاً بهصورت عمومی منتشر نشده، اما مدل Qwen3-32B که در دسترس عموم قرار گرفته، با مدلهای قدرتمندی مثل DeepSeek R1 و OpenAI o1 رقابت میکنه. این مدل همچنین در اجرای دستورها، تماس با ابزارها و حفظ فرمت دقیق دادهها عملکرد خوبی از خودش نشون داده. Qwen3 علاوه بر دانلود مستقیم، از طریق پلتفرمهای ابری مثل Fireworks AI و Hyperbolic هم قابل استفادهست. برخی تحلیلگرها معتقدن انتشار این مدلها نشوندهندهی قدرتگیری مدلهای متن باز در برابر سیستمهای بسته هست، حتی با وجود محدودیتهای صادرات تراشه به چین.
این مدلها از طریق وبسایت qwen از اینجا قابل استفاده هستن.
@aipulse24
Post #431
1.84K

- 🔥 15
- 👍 4
- ❤🔥 2