
Обзор движков для инференса LLM
LLM-движок размещает веса и KV cache, собирает запросы в батчи, выбирает ядра и держит SLO по TTFT и TPOT. Выход длиной T токенов требует T последовательных decode-итераций, поэтому на каждом шаге движок решает, кого обработать следующим.
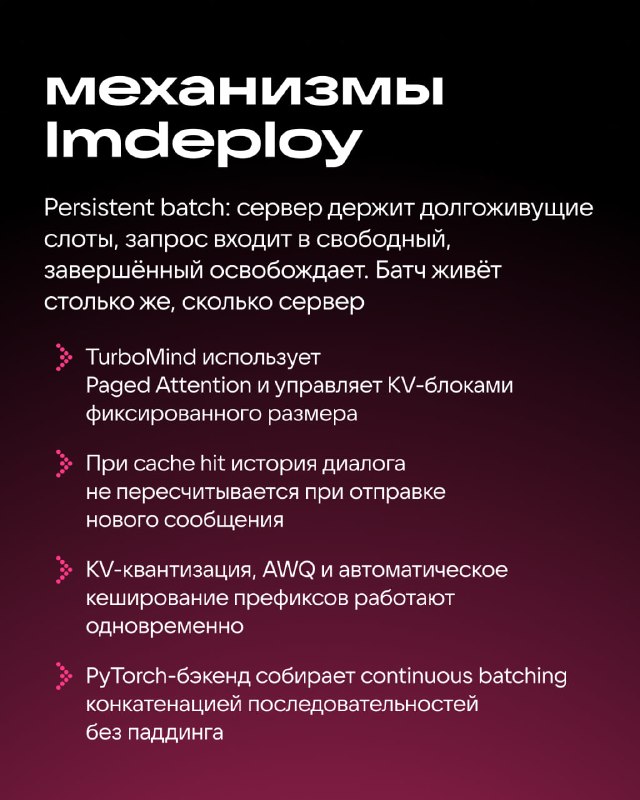
TensorRT-LLM, LMDeploy, vLLM, SGLang и llama.cpp решают задачу с разными приоритетами. Как это происходит, рассказываем в карточках.
#aivkhub #llm #обзор
Post #588
1.33K




- 🔥 8
- ❤ 5
- 👍 5
- 💅 2