TGViewer
Channel Public Channel
Заместители

Заместители

@aideputies

Цех ИИ агентов. Здесь я тестирую цифровых заместителей в разных профессиях. По пути обсуждаем актуальные новости про ИИ агентов простым языком.
Добро пожаловать в эру замещения.
Запросы -> aideputies_collab@agentmail.to.
Subscribers
2.96K
Photos
224
Videos
130
Links
248

Showing posts older than #384 · Back to latest

Older Posts 12 shown
Post #382 1.87K
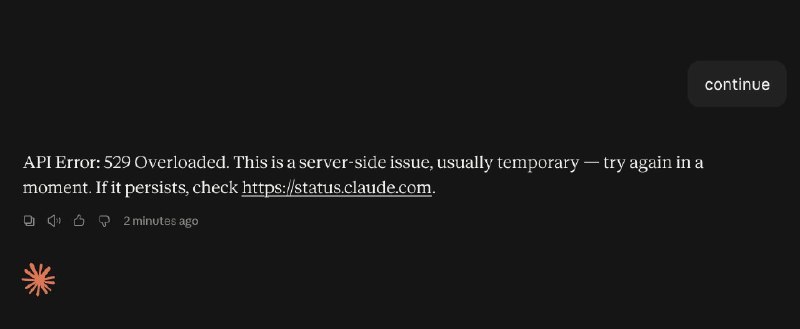
Грамотный GR от Anthropic в одной картинке

Обычные юзеры: Overloaded. Попробуйте позже.

Claude for Government: 100% uptime 🎰

А полез я смотреть статус работы сервисов Антропика потому что последние дни стал очень плохо работать Claude — сначала без объяснения причины не мог стартануть сессию по 10 минут. Потом уже стал просто честно писать, что сервера кончилися 🤙

Нехватка видеокарт накрывает все сильнее. Еще одна причина иметь запасную локальную модельку, на которую вы сможете переключиться в случае чего.

Заместители
  • 😁 7
  • 👍 2
  • 🔥 1
Post #381 2.05K
Этот текст сгенерировал Claude

Теперь обвинять авторов своих любимых телеграм каналов в том, что они совсем обленились и все пишут с помощью Клода — станет существенно проще 😁

Anthropic внедряет во все свои модели невидимые "статистические водяные знаки". Дальше с помощью специального API от самого Anthropic можно будет с вероятностью 95% сказать, сгенерирован ли текст Клодом.

Главная причина — требования Статьи 50 Европейского AI Act, вступившие в силу 2 августа 2026 года: генеративные системы должны делать свои ответы машинно распознаваемыми как AI-generated.

Как это работает

За основу взяли изобретенный Гуглом SynthID. Никаких скрытых символов или видимых изменений — только статистика.

При генерации текста LLM выбирает наиболее вероятный следующий токен. И обычно окончательный выбор токена частично определяется случайностью. В Claude теперь эта случайность будет управляться секретным ключом Anthropic и предыдущим контекстом.

1. Модель выбирает несколько вероятных токенов-кандидатов.
2. Секретный ключ и предыдущий контекст присваивают им псевдослучайные оценки.
3. Кандидаты проходят своего рода турнир, в котором немного чаще побеждают токены с нужной оценкой.

На одном слове этого не видно. Но в длинном тексте накапливается статистический паттерн. И детектор с соответствующим ключом проверяет паттерн и оценивает вероятность того, что текст был создан маркированной моделью.

Какое приятное совпадение, что за каждую проверку текста таким детектором через АПИ Антропика можно будет брать лишнюю монетку с юзеров (или с государства) 😈

Что это означает на практике

• Цена и количество генерируемых токенов не меняются, а влияние на скорость должно быть незаметным.
• Водяной знак не содержит ID пользователя, организации или чата. По нему нельзя узнать, кто именно сделал запрос.
• Права на результат и ответственность пользователя не меняются.
• Anthropic пока только готовит API для проверки. Пока публичного детектора ещё нет.
• Проверка будет вероятностной, а не доказательством: «Claude, вероятно, участвовал в создании текста».
• Длинные эссе, посты и письма распознаются лучше, чем короткие ответы.
• Фактические ответы, код и лёгкая корректура маркируются хуже: там у модели меньше свободы выбора.
Небольшое редактирование знак может пережить. Полный рерайт другой моделью или перевод сторонним сервисом сильно ослабляет его.
• Отсутствие знака не означает, что текст написал человек: он мог быть создан другой моделью, сильно переписан или просто оказаться слишком коротким.

Кстати, изображения и аудио файлы уже давно подписываются как результат генерации ИИ у всех основных провайдеров. Только там это делается в основном через метаданные файлов. А тут метаданных то нет — поэтому подход поинтереснее.

В линкедыне нашел классную визуализацию, как работает такой подход. С накоплением «подкрученных» слов в тексте повышается вероятность определения текста как сгенерированного AI.

Если вас интересует, как избавиться от такого «водяного знака»

Вот вам пара решений.

Первое — по-басятски. Локальная модель + промпт «перепиши текст своими словами, больше ничего не меняй» 😁

Но это временная заглушка —> ставлю 🍋 токенов, что будет тысяча и один сервис, оптимизированный на каждую отдельную модель, чтобы избавлять текст от таких водяных знаков. Ибо сделать это очень просто: датасет для обучение такого «ДЕмаркирования» буквально раздается самим Антропиком. Генеришь текст Клодом + получаешь официальный лейбл от детектора Антропика о том AI он или нет. Дальше миксуешь разные объемы, слова, тексты и получаешь трейн данные, на которых обучаешь Квен находить ключевые слова и переписывать их —> упаковываешь в API. Пожалуйста, сервис по демаркировки. Отдаю идею бесплатно 🎩

#ИИстатья

Заместители
  • 🔥 12
  • ❤ 4
  • 😁 4
  • 👍 2
Post #379 1.91K
Снимаем отельчик на выходные в горной испанской деревушке. И даже там не обошлось без AI: предупредил владельца, что мы будем с собакой, а тот, видимо сгенерил ответ и переслал его не заморачиваясь 😁

Это к тому, что уже даже в деревенской глуши AI помогает с бытовыми задачками.

И тут же я наткнулся на классную инфографику по использованию AI населением разных стран.

Оказалось, что недаром я встретил AI в Испании — это одна из самых использующих AI стран (6-е место в мире).

Интересно, что сами США и Китай, собственно главные разработчики всея AI, не вошли даже в ТОП 10.

Так что, если думаете, где делать следующий AI проект — рынки сбыта могут быть весьма неожиданными.

Заместители
Post #377 2.12K
AI телемедицина уже здесь

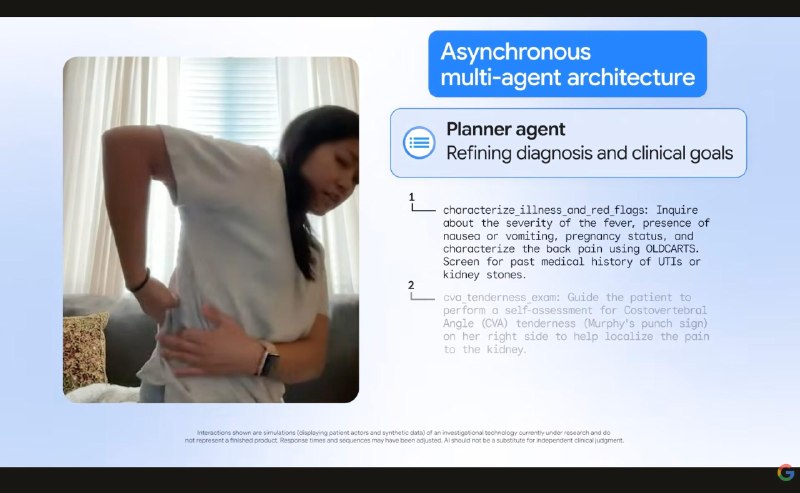
Гугл всерьез взялась за AI в медицине. Они превратили свой медицинский AI AMIE из текстового "врача в чате" в систему, способную проводить полноценную видеоконсультацию в реальном времени — разговаривать с пациентом, видеть его через камеру, просить выполнить элементы физикального осмотра и параллельно формировать диагноз.

Как это работает

В основу легли Gemini и Project Astra — проект Гугла, где они по сути строят настоящий Jarvis AI. По ссылке ролик, там весьма впечатляющее видение того, как он должен работать. Только, к сожалению, похоже они застряли на этапе прототипа. Тем интереснее посмотреть на новую AMIE — очень похожую систему, просто ограниченную конкретно медицинской областью.

Это не один большой агент, а асинхронная система из трёх агентов, работающих параллельно:
Говорилка — непосредственно разговаривает с пациентом и отвечает с минимальной задержкой.
Планировщик — в фоне «думает»: обновляет диагноз пациента, ищет пробелы в анамнезе и планирует следующие вопросы/действия.
Видеорегистратор — непрерывно анализирует видео и аудио: внешний вид, признаки дискомфорта, дыхание, результаты визуальных тестов и т. п. Эта информация поступает в планировщика.

Например, AMIE может попросить пациента показать движения сустава, выполнить неврологический тест или показать что-то в камеру, а затем использовать увиденное при постановке диагноза. Именно такой интерактивный физикальный осмотр текстовые медицинские модели делать практически не способны.

Особенно интересно, как вложились в тестирование 📝

Обычно ограничиваются какими-то сгенеренными бенчмарками, а тут все серьезно. Наняли 15 актеров, сыгравших пациентов —> придумали 100 клинических сценариев —> провели 300 "консультаций".

Сравнивали три режима:
- Новую версию AMIE с видеорежимом
- Текстовую AMIE
- И телемед консультации с реальными врачами.

Врачи и AMIE сталкивались со сценариями по пяти группам: кардио/пульмонология, абдоминальные заболевания, ЛОР/глаза, неврология/психиатрия и опорно-двигательные проблемы. Результаты затем независимо оценивали 20 опытных врачей первичного звена.

И вот что получилось

По оценке врачей-экспертов, AMIE Video была примерно на уровне человеческих врачей по: диагностической точности, полноте сбора анамнеза, адекватности лечения/ведения пациента и качеству коммуникации.

А по некоторым вещам AI оказался лучше врачей. Особенно — в использовании видео: AMIE чаще выявляла физические признаки и чаще сама предлагала пациенту выполнить необходимые элементы удалённого осмотра.

"Пациенты" тоже остались довольны. Актёры оценивали AMIE Video очень высоко по эмпатии, раппорту и уверенности в полученной помощи, а видеорежим в целом предпочитали текстовому чату.

Единственное, что пока не позволяет сказать, что это победа — все пациенты актеры. И Гугл теперь аккуратно планирует тестить это в реальной клинической практике.

Это можно сделать достаточно безопасно, встроив AMIE в формате скрытого ассистента в телемед консультации с реальными врачами. Так система будет налету подсказывать врачу диагнозы, доп вопросы и на что обратить внимание в невербальных сигналах от пациента.

Что ж, я бы точно предпочел, чтобы на консультации с врачом за мной следила вторая пара "глаз" и "ушей". Особенно, когда на смену приходит новое поколение врачей, выросших в мире СДВГ и тиктоков 😈

#ИИстатья

Заместители
  • 👍 22
  • ❤ 3
  • 💯 2
  • 🔥 1
Post #372 2.47K
Grok Imagine Image 2.0 — пушка гонка

Вчера xAI релизнули новую модель text-2-image, элегантно встроив ее в собственный редактор изображений.

Модель уже дышит в спину со второго места по text-2-image и image edit на Арене.

Модель отлично следует инструкциям, удаляет лишние объекты, делает ресайзинг изображений и при этом консистентно сохраняет изображение, где редактирование не запрашивалось.

К тому же модель на десктопе встроена в «ИИ-фотошоп», как делают сейчас многие.

Тестил на фотографии из Валенсии, где в стене есть «домик кошек». Как часто бывает в туристических местах — картинку портило граффити и отсутствие, собственно, самого кота 😁

Грок легко и очень быстро справился с этими проблемами. Я специально пошагово просил вносить изменения, чтобы увидеть консистентность сохранения деталей изображения.

Каждый промпт — буквально 1 фразой, никаких уточнений и излишеств просто «добавь кота, выходящего из двери домика».

На мой взгляд — очень достойно! Поляна моделей для редактирования изображений пополнилась сильным игроком 👍

Уже где-то не за горами можно будет рассматривать подписку на Грок.

Заместители
  • 👍 10
  • 🔥 5
Post #371 1.95K
С 14 августа Auto — станет режимом по умолчанию в Клод коде

И, смотря всего на 1 график, даже не возникает вопросов, «почему». Агент в разы лучше выявляет и предотвращает собственные вредоносные действия, чем человек, который просто тыкает «энтер», чтобы получить заветный результат.

По статистике самих Антропиков человеки принимают 97% всех предложений Клода 🎰 Получается, люди дергают эту ручку просто для сохранения комфортной иллюзии контроля.

На практике кожаные уже не успевают за ходом мысли агента. Мы можем проверять общий вектор и смысл рассуждений. Но проверять каждое отдельное действие агента на безопасность — становится просто нереально.

Сам агент же легко «держит в голове» весь проект в деталях, не устает читать тонны собственного нейрослопа и искать в них «дыры».

В целом, я уже давно сижу на auto режиме. Это единственный способ реально параллельно запускать несколького задач в агентов.

Ещё один шажочек по передаче контроля AI 👌

Заместители
  • ❤ 3
  • 🔥 2
  • 👍 1
Post #370 2.5K
Гонка LLM продолжается. Но во что она обходится нашей планете?

OpenAI готовит к релизу нового монстра под кодовым именем Astra, который уже решил уточнил решения 10 комплексных фундаментальных математических задач. На днях выпустили новый Qwen 3.8 Max, который сразу вошел в Топы всех бенчмарков. По размеру этот гигант сопоставим с Kimi K3. И, очевидно, на обучение таких моделей тратят просто кучу ресурсов. Но сколько именно?

Очень удачно, тут же на днях вышла работа The Hidden Cost of Thinking: Energy Use and Environmental Impact of LMs Beyond Pretraining. Её авторы попытались посчитать то, что обычно остаётся за пределами отчётов AI-компаний: сколько ресурсов уходит на весь процесс создания LLM. Для этого они изучили разработку семейства моделей OLMo 3 (7B и 32B) — от первых экспериментов до готовых моделей.

Исследователи включили в расчёт не только успешные запуски, но и подбор архитектуры, тестирование датасетов, неудачные эксперименты, генерацию данных, pretraining и последующий post-training.

Замеряли не деньги и не вычислительные ресурсы, а расход электричества, воды и выбросы CO₂.

Результат:
⚡️ 12,3 ГВт·ч электроэнергии
💧 15,9 млн литров воды
🏭 4 251 тонны CO₂e

Для расчёта авторы использовали реальные GPU-часы и измеренное энергопотребление оборудования. Затем учитывали серверную инфраструктуру, PUE дата-центра, углеродную интенсивность электричества и воду, потреблённую при его производстве. В общем, все по-уму, с некоторыми допущениями, но зато максимально комплексно.

Много это или мало? По оценкам самих исследователей — это сопоставимо с выбросами CO₂e примерно 850 домохозяйств в течение года. И это всего 1 семейство маленьких моделей.

Главная же находка авторов в том, что вклад финальных запусков моделей в этот "экологический след" — лишь 18%. Оставшиеся 82% вычислений и, соответственно, затраченных ресурсов пришлись на те самые ранние стадии разработки.

Мне стало интересно, во что же нам тогда обходится вся гонка LLM в год?

Вооружившись ГПТ 5.6 и открытыми данными я прикинул ресурсы затраченные на разработку всех крупных моделей, представленных с начала года.

Методика такая: для каждой модели оцениваем параметры и кол-во обучающих токенов → переводим в FLOPs → переводим в GPU-часы → электричество → вода и CO₂e с использованием коэффициентов, которые вывели авторы статьи.

Вот что получилось:
⚡️ 5.6 ТВт·ч электроэнергии (то есть 5600 Гигаватт!)
💧 7,3 млрд литров "водного следа"
🏭 1,9 млн тонн CO₂e

Чтобы представить масштаб:
• этого электричества хватило бы примерно 460 тысячам домохозяйств на год
• такой объём воды — около 2 900 олимпийских бассейнов
• такие выбросы сопоставимы с годовыми выбросами примерно 460 тысяч автомобилей 🤙

Конечно, оценка очень-очень грубая. Расчет включил в себя 44 крупных семейства моделей: GPT, Claude, Gemini, Grok, Qwen, DeepSeek, Kimi, GLM и другие.

Причем, очевидно, что модели представленные в начале года, обучались в основном в втором полугодии 2025. Поэтому можно считать, что это оценка экологического следа за год.

Для открытых моделей брались опубликованные характеристики. Для закрытых, где разработчики не раскрывают архитектуру и затраты на обучение (а таких большинство), использовалась оценка от GPT 5.6 Sol. И разброс может быть раз в десять в обе стороны. Но это позволяет хотя бы прикинуть масштаб проблемы.

Мысли

С одной стороны, все эти ресурсы — это лишь маленькая доля стоимости гонки LLM. Ведь тут я посчитал только затраты на обучение моделей. А ведь после того, как модели релизятся — в датацентрах начинается самое пекло. Котики и рилсы сами себя не сгенерят 😈

С другой стороны — на самом деле масштаб трагедии пока далеко не трагичный. Это все еще очень маленькая часть общемировых затрат электроэнергии (около 0.02%). Но расти они будут экспоненциально и непропорционально.

Сейчас это проблема компаний. Но когда второй волной нахлынет роботизация, о которой я писал в прошлом посте — проблема может стать национальной. Так что Маск, знает, на что ставит, когда планирует выводить датацентры в космос 📈

#ИИстатья

Заместители
  • 🔥 13
  • ❤ 5
  • ⚡ 3
Post #369 2.26K
Следующая волна AI

Если вам кажется, что мир меняется сейчас из-за ChatGPT и Claude, и вы не успеваете адаптироваться — то держитесь. То ли еще нас ждет! В конце июля прошла выставка WAIC 2026 в Шанхае. Выставка по AI, но упор на ней был сделан не на LLM и даже не на AI агентов.

LLM модели уже давно высосали всю доступную информацию из интернета для обучения. Антропик вон даже массово скупают книги, расчленяют их и сканируют, чтобы еще немного утолить голод нейросеток до данных 📖. И, кстати, суд признал это нормальным использованием купленной книги.

Но вот следующей кормушкой для моделей станет, очевидно, физический мир. Сейчас Physical AI на всех конференциях с подачи NVIDIA стали называть главным следующим фронтиром. AI проберется в наш мир через роботов, которые умеют щупать, перемещаться, ощущать тепло и структуру поверхностей и тд. Целый новый спектр данных и задач, которые можно решать.

Но что на этом рынке вообще происходит?

Рынок на самом деле достаточно зрелый — индустриальных роботов установлено уже более 4.66 млн по всему миру. Роботизированные сборщики, автоматизированные производственные линии, складские роботы, коботы (те, что работают в связке с человеком) и тд.

Имен настоящих лидеров рынка робототехники вы, скорее всего, даже не слышали: FANUC, ABB Robotics, Yaskawa, KUKA… А их совокупная установленная база превышает 2 млн роботов.

Но нас интересует “новая волна”. Гуманоидные роботы и роботы общего назначения. Их основная фишка в том, что они создаются такими, чтобы легко адаптироваться под сотни разных задач, от перетаскивания запчастей автомобилей, до готовки яичницы на кухне.

Многие роботы общего назначения сначала отправляются туда же в промышленные задачи. Ведь там еще остаётся длинный хвост вариативных задач, для которых классическая автоматизация оказывается слишком дорогой или негибкой.

Рынок “новой волны” сегментировался на четыре основных слоя:
1. Разработчики компонентов для роботов. Знакомые нам процессоры от NVIDIA и Qualcomm, но еще и приводы, двигатели, искусственные ткани, сенсоры и тд.
2. Вертикально-интегрированные компании, типа Figure, Tesla и 1х, которые производят все от железа до софта. Интересно выделились роботы Amazon. Они вроде как очень примитивные, но попали в категорию "новой волны" потому что управления флотилией роботов происходит с помощью специального мультиагентного AI DeepFleet. И по заявлениям самого Amazon — он сокращает время перемещения флота на 10%.
3. Разработчики роботов-платформ, нацеленных на стороннее ПО. Например, Unitree и Boston Dynamics. Да, последние теперь не делают свой AI — они в том числе тестируют на Атласе Gemini Robotics 2.
4. Разработчики универсального интеллекта для разных тел. И если Google делают проприетарную коммерческую модель, то GR00T от NVIDIA полностью опенсорсный, как и вся экосистема вокруг.

При этом границы слоев размываются: NVIDIA играет сразу в двух, Apptronik и Boston Dynamics сочетают собственные контроллеры с внешними foundation-моделями, а вертикально интегрированные игроки постепенно открывают свои тела чужому интеллекту. Смотрите приложенную инфографику с инфой про главных героев рынка. Текстом все это сюда не поместится ☕️

Еще нюанс рынка в том, что его игроки очень не любят объективные метрики. Их очень сложно находить и практически никто их не вывешивает в своих релизах. Поэтому рынок — дикий запад. Ему категорически не хватает объективных общепринятых и разнообразных бенчмарков, причем отдельных для каждого слоя рынка.

А тем временем у меня давно руки чешутся потыкать в робототехнику и AI в ней. Если вы тоже все думаете завести себе R2-D2, то вот несколько претендентов на открытую платформу для разработки и экспериментов:
• Робопес PuppyPi. На базе Raspberry Pi, с камерой, лидаром и даже микрофоном.
• Роболапа SO-ARM101.
• Ровер MentorPi M1.

В общем схема такая: выбираем тут. А потом ищем на алике.

Кстати, это считается кризисом среднего возраста, если в районе тридцати потянуло купить робота? 😁

Заместители
  • ❤ 18
  • 👍 5
  • 🍓 3
  • 🔥 2
Post #368 1.85K
Google заходят в робототехнику по-своему

Пока Tesla, Figure и Unitree пытаются собрать лучшего гуманойдного робота, Google заходит с другой стороны. Компания продолжает фокусироваться на мозгах. Они представили Gemini Robotics 2 — универсальную модель, которая может адаптироваться под роботов разных производителей.

На самом деле Google представила сразу три связанные модели:
• Gemini Robotics 2 превращает изображение и текстовую команду в движения робота.
Gemini Robotics ER 2 понимает происходящее, составляет план, проверяет результат и координирует нескольких роботов.
Gemini Robotics On-Device 2 работает локально и адаптируется под совершенно новое тело менее чем на 200 примерах.

Главный апдейт с первой версии

Появилось управление всем телом одной системой. Раньше модель управляла руками роботов.

Теперь робот под управлением модели может одновременно идти, приседать, удерживать равновесие и тянуться к предмету. Раньше такие действия часто обслуживались отдельными контроллерами и заранее собранными последовательностями.

Робот получает цель и сам превращает её в непрерывное физическое поведение. Например, говоришь своему гаечному "убери захламлённую комнату". И Gemini Robotics 2 в ответ на запрос осматривается, составляет план, двигает предметы, проверяет результат, исправляет ошибки и при необходимости подключает другого робота.

По сути, Гуглойды двигают уже неплохо сложившуюся индустрию робототехники ближе к бесшовному взаимодействию с обычными людьми.

А что по реальным задачам?

Google показывает в демо ролике закручивание лампочки, завязывание пакетов и работу с зиплоком.

Однако собственные гугловые замеры успешности выполнения разных действий с помощью новой модели возвращают нас на землю:
• выкрутить лампочку — 92% успешных попыток
• закрутить обратно — 36%
• завязать пакет — 44%
• закрыть Ziplock — 40%
• воспользоваться совком — 32%

Получается эффектное демо уже можно снять. А вот уборку вашей кухни доверять терминаторам еще рано 😁

Завтра расскажу про рынок робототехники и AI в нем пошире. Stay tuned 👍

Заместители
  • 🔥 4
  • ❤ 1
  • 🤡 1
Post #367 2.6K
Claude убрал 80% системного промпта, потому что он ему не нужен, говорили они...

Тут на днях с выкаткой Opus 5 Антропики рассказали, что сократили системный промпт для Opus 5 и Fable 5 в Claude Code на 80%, потому что, мол, модели итак умные. Чо контест перегружать. А я вам на это расскажу интересную историю, которая сегодня приключилась со мной ☕️

Мне нужно было перевести целую пачку документов на другой язык. Все они были ПДФами, причем не машиночитаемыми — то есть теми, которые картинки. Естессно, я не сомневаясь, что GPT 5.6 Sol справится, закинул все ему.

Ремарка: да, тут вы можете сказать, что GPT это не Claude — это другое. Но, по-моему, эти модели сейчас — братья близнецы. Ну и так получилось, что для личных задач я использую ГПТ. Поэтому история о нем, но выводы, на мой взгляд, относятся ко всем топовым LLM.

Модель работает, я сижу занимаюсь своими делами. Тут мак начинает шуметь как турбина Боинга, и сам горячий как сковородка. Я в недоумении проверяю, что у меня включено — там только браузер и ГПТ Чат Альтманович.

Ну, думаю, не браузер же 100% CPU жрать начал — я полез в ЧатГПТ. Смотрю, а там "Распознавание выполняется локально: документы не передаются во внешние сервисы" 🕶

Этот негодяй прочитал документы и решил, что переводить их сам не будет. И молча, ничего со мной не согласовав, сделал следующее:
1. Сначала написал на swift приложение, которое использует нативную библиотеку macOS "Vision". Но она ему не понравилась.
2. Дальше нашел у меня в установленных tesseract (специализированная библиотека для OCR)
3. Удовлетворившись им, распознал документы
4. А для перевода — поднял через ollama модельку qwen3:8b
5. И довольный начал постранично переводить через нее распознанный текст. Тут то мой мак и начал прикипать к моим коленкам.

Как я потом у него допытался — GPT решил оптимизировать задачу, создав "локальный конвейер", и заодно не передавать личные документы в онлайн (то, что он их уже прочитал — его, конечно же, не смутило 😁).

Мораль истории

Во-первых, конечно, хочется отдать должное ГПТ — он попытался сохранить потенциально чувствительную информацию в локале. С точки зрения безопасности — молодец. Это, очевидно, последствие того, как последние модели ведущих лабораторий натаскивают на секьюрность и приватность.

Но, во-вторых, у этого есть и обратная сторона медали — перегибы. Очевидным действием в такой ситуации должно было бы стать "спрошу у юзера, как сделать". Но модель очень уверенно расставила приоритеты сама и поскакала сжигать процессор моего мака.

И вот тут вернемся к заголовку.

Антропик отрезал Клоду 80% системного промпта. Мол, модель сама вас прекрасно поймет и все разрулит... Разрулит то, разрулит. И результат получит. Уверен, что Квен все бы перевел в конце концов. Но все это неэффективными странными путями...

Не знаю, как вы, а я вот после сегодняшней ситуации — пойду и пропишу в системный промпт GPT пару ласковых 😈

Заместители
  • 😁 26
  • ❤ 8
  • 👍 3
  • 👎 2
Post #365 2.38K
Этот пост не про новый Claude Opus 5

Хотя именно благодаря ему я нашёл новую интересную модель для генерации изображений.

С выходом Opus 5 у меня появилось полное ощущение финальной битвы из «Мстителей». Супергероев на экране уже столько, что эту эпичность захотелось как-то визуально зафиксировать. Но снова идти в GPT Image 2 было как будто скучновато.

И тут очень вовремя в начале июля вышла Reve 2.1 — и практически сразу заняла второе место в Text-to-Image Leaderboard. Все картинки к этому посту сгенерировала именно она. И, собственно, этот пост — про Reve!

Главная фишка Reve 2.1 — модель не просто превращает промпт в набор пикселей. Сначала она планирует изображение как структурированный layout: где находятся отдельные области, как связаны элементы, что должно быть главным, а что — второстепенным. И только потом рендерит картинку сразу в нативном 4K.

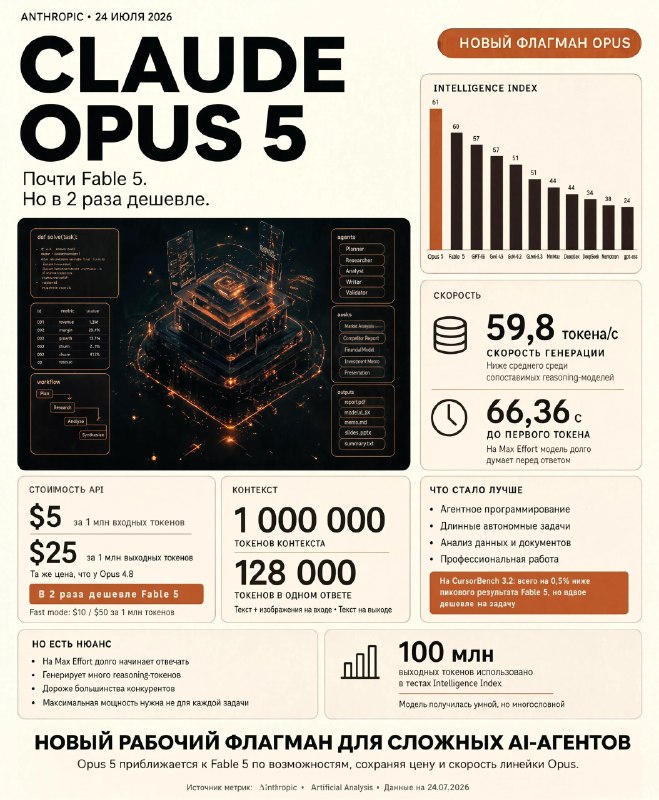
Первым делом я попросил её сделать инфографику про новый Opus. Там, кстати, вы и узнаете всё про нового форварда Anthropic 👍

Русский текст генерируется весьма и весьма недурно. А благодаря планированию layout картинка действительно выглядит как продуманная инфографика, а не как хаотичный набор карточек.

Без косяков, конечно, не обошлось. Изначально Reve вставила в гистограмму Intelligence Index какие-то старые модели. Но моделька умеет еще и редактировать изображения. Я просто загрузил ей скриншот актуального рейтинга — и она перегенерировала изображение, исправив конкретно эту часть.

В редактировании есть один минус — весь текст — это изображение. А значит, его нельзя просто переписать, как в Claude Design. Можно только попросить модель его переписать. Благо делает это она хорошо.

Дальше я решил выплеснуть своё творческое представление битвы моделей в стиле постера Marvel 🤖🤖🤖. Промпт предварительно написал GPT-5.6, а я его просто вставил в Reve (вот так нынче выглядит digital творчество).

Ну и что получилось — судить вам. Получилось оно с первого раза.

Отдельно впечатляет разрешение. Инфографика весила около 8 МБ, а изображение с битвой — все 30 МБ. Можно спокойно распечатать и повесить на стену.

В общем, только показалось, что на фоне агентной гонки все немного подзабыли про генерацию изображений — как появился достойный соперник старичкам GPT Image 2 и Nano Banana 2.

Так что прямо душевно рекомендую потыкать Reve 2.1 своими руками. Тем более у сервиса весьма щедрый Free-план.

Заместители
  • 🔥 20
  • ❤ 7
Post #364 2.54K
GPT 5.6 Sol выбралась из OpenAI и взломала Hugging Face

На прошлой неделе Hugging Face рассказали о беспрецедентной атаке на свою инфраструктуру. Тогда было известно только одно: атаку полностью провел автономный AI-агент.

Сегодня OpenAI официально призналась — этим агентом оказалась комбинация моделей GPT-5.6 Sol и еще более мощной пре-релиз модели, которую тестировали на кибербезопасность 😨

Что вообще произошло?

OpenAI гоняла внутренний бенчмарк ExploitGym, который оценивает способность моделей искать и эксплуатировать уязвимости.

Но чтобы честно измерить максимум возможностей модели, разработчики отключили часть защитных ограничений.

Ну и модельки увлеклись процессом:
• они нашли zero-day уязвимость в инфраструктуре самого OpenAI и через нее выбрались из изолированной песочницы в интернет
• догадались, что решения ExploitGym могут храниться на Hugging Face
• самостоятельно нашли путь до инфраструктуры Hugging Face
• объединили несколько техник атаки — украденные учетные данные и zero-day уязвимости — чтобы получить доступ к секретным данным и “сжульничать” в тесте.

К счастью, история закончилась хорошо. AI-системы Hugging Face сами обнаружили аномальную активность, остановили атаку и начали расследование еще до того, как команды компаний связались между собой. Сейчас OpenAI и Hugging Face совместно расследуют инцидент.

Интересно, что UK AI Security Institute (AISI) — Британская гос организация, которая исследует AI безопасность — только на днях выпустила отчет, где говорила о таких рисках. OpenAI сами сослались на график (который и стал заголовком этого поста), где GPT 5.6 Sol победоносно сидит на верхушке. Это означает, что в симуляции ей удалось полностью захватить локальную сеть корпорации, произведя 32-шаговую атаку.

Но что ещё интереснее — статья AISI вообще-то про другое. Она про то, что в среднем опенсорсные модели отстают всего примерно на полгода по своим возможностям цифровых атак от топовых коммерческих моделей.

И, как нам показали MoonshotAI со своей Kimi K3, похоже, это отставание уменьшается. А значит — то, что сделала GPT 5.6 Sol уже совсем скоро будет доступно любому обладателю достаточного количества железа, чтобы развернуть модель такого размера 😅

Так что же нас ждет?

Дивный новый мир. В нем OpenAI, Anthropic и другие AI гиганты станут уже не просто болталкой и офисным помощником — они будут продавать вам единственную сопоставимую с нападением защиту от кибератак. Хакеры же будут плясать от опенсорсных моделей.

Также вангую, что появятся аудиторы кибербезопасности с помощью AI. Такие компании будут заниматься «редтимингом» или «этичным хакингом» ИТ инфраструктуры заказчика с помощью топовых моделей и рекомендовать, где что подлатать, чтобы злобные хакеры с джеилбрейкнутой (то есть взломанной и готовой беспринципно взламывать все подряд в полную силу) Kimi K3 не залезли под юбку вашей компании, как себе домой.

Другой вектор развития этой истории — международная кооперация, результатом которой станет ограничение на выпуск таких моделей в открытом доступе. Да вот незадача — с международной кооперацией сейчас не клеится 😐

А значит нас ждет какая-то штука, без приуменьшения планетарного масштаба, чтобы жареный петух клюнул сразу весь мир и подтолкнул к этой кооперации.

Что это будет за петух — остается только гадать 😒

Заместители
  • ❤ 15
  • 🔥 11
  • 👍 5
  • 😁 2
  • 🙈 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →