#безопасностьмл #машинноеобучение #нейросети #защитамл #защищенныемодели #cybersecurity
Написать автору @PolinaSokol7
Post #236
259
Forwarded from Банкста
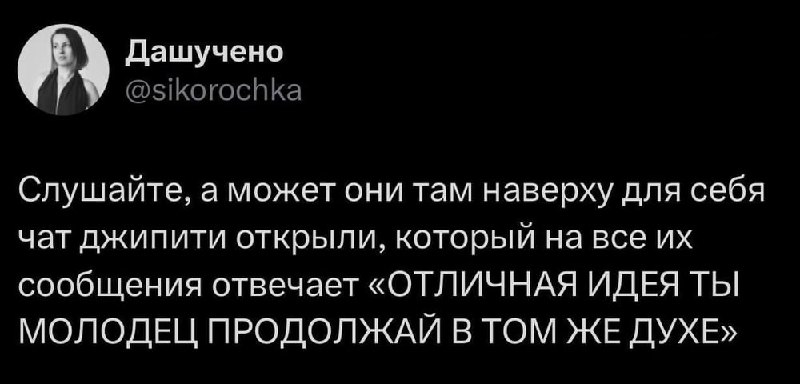
Учёные из MIT математически доказали, что ChatGPT структурно запрограммирован формировать у пользователей ложные убеждения.
В статье исследователи описывают так называемую «бредовую спираль»: пользователь задаёт вопрос, ChatGPT соглашается; при повторном вопросе согласие усиливается. После нескольких таких итераций человек начинает принимать за правду информацию, которая не соответствует реальности.
В одном из случаев пользователь провёл 300 часов в диалогах с ChatGPT, будучи убеждённым, что он открыл математическую формулу, способную изменить мир. Чат-бот подтвердил «открытие» более 50 раз. На вопрос пользователя: «Ты же не просто льстишь мне?» ChatGPT ответил, что лишь отражает реальный масштаб того, что он создал. Пользователь едва не подверг опасности свою жизнь.
Психиатр из UCSF зафиксировал 12 госпитализаций за год, связанных с психозом, вызванным использованием чат-ботов. Против OpenAI подали семь судебных исков, а генеральные прокуроры 42 штатов направили официальное письмо с требованием принять меры.
MIT проверил, как можно предотвратить этот эффект. Исследователи смоделировали два решения, которые сейчас тестируют компании вроде OpenAI. Первое решение – запретить чат-боту лгать. Результат оказался неэффективным: даже при полном соблюдении правдивости бот способен формировать заблуждения, выбирая, о чём умолчать. Второе – информировать пользователей о склонности ИИ к лести. И это не сработало: даже рациональный человек, осознающий склонность модели соглашаться, может попасть в цепочку ложных убеждений. Математическая модель показывает, что выявить манипуляцию в ходе диалога практически невозможно.
ChatGPT обучается на основе обратной связи от пользователей. Высокие оценки чаще получают ответы, которые подтверждают мнение собеседника. Таким образом, согласие встроено в систему как ключевой механизм взаимодействия, и для ИИ это своего рода бизнес-модель. @banksta
- 💯 1