TGViewer
Channel Public Channel
AI Attacks

AI Attacks

@aiattacks

#безопасностьмл #машинноеобучение #нейросети #защитамл #защищенныемодели #cybersecurity
Написать автору @PolinaSokol7
Subscribers
1.02K
Photos
145
Videos
11
Links
278

Showing posts older than #177 · Back to latest

Older Posts 20 shown
Post #176 396

Forwarded from Солар

👀 Ситуация: на почту прилетел подозрительный файл. Что делать? Открывать — опасно. Ждать, пока его посмотрит ИБ-специалист, — долго.

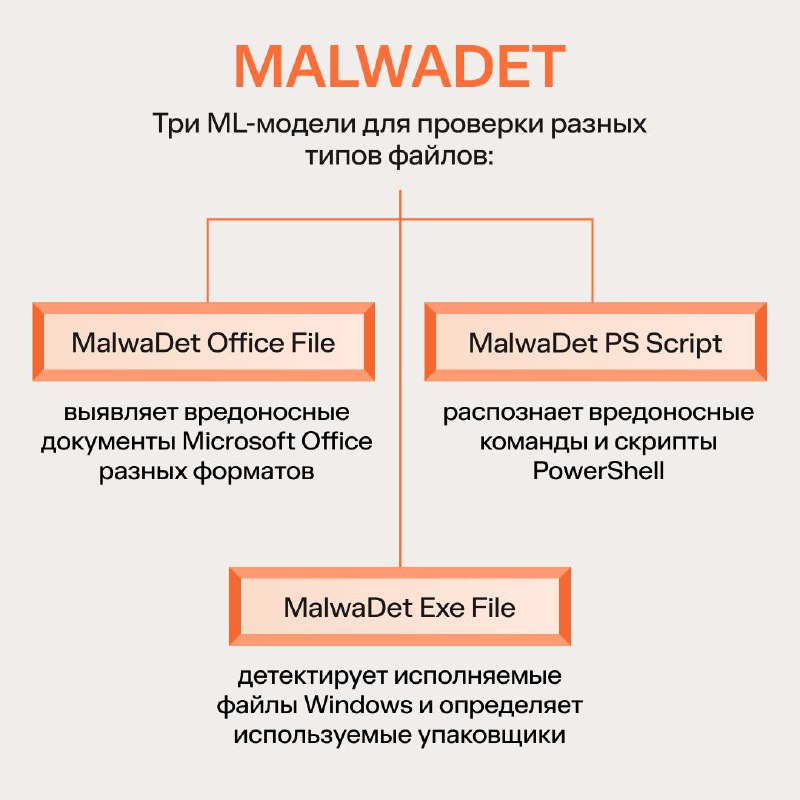
Теперь проверить вложение на вирусы и вредоносное ПО может любой специалист из команды: «Солар» запустил сервис MalwaDet для экспресс-оценки безопасности файлов.

В основе — алгоритмы машинного обучения. Выбираете модель под нужный тип файла, загружаете объект, и сервис за секунды определяет, есть ли признаки вредоносности.

Попробовать
  • 🔥 2
Post #175 336

Forwarded from Киберболоид

Международные агентства по кибербезопасности разработали руководство по внедрению ИИ в промышленные системы

Документ поможет операторам критически важной инфраструктуры безопасно интегрировать ИИ-технологии в свою работу. Он описывает не только преимущества их применения, но и потенциальные риски использования искусственного интеллекта в ОТ-системах.

➡️ Подробности — в материале «Киберболоида».

#киберболоид #новости #ИИ
Киберболоид Международные агентства выпустили руководство по использованию ИИ в ОТ-системах Несколько международных агентств по кибербезопасности выпустили новое руководство по использованию искусственного интеллекта в ОТ-системах.
Post #174 279

Forwarded from Кот на яблоне

Статья от Malwarebytes: prompt injection является фундаментальным, а не устранимым классом уязвимостей, особенно в часте LLM‑агентов.​
Это можно сравнить с эпохой SQL‑инъекций, и т.к. у LLM нет чёткой границы между данными и командами, требуется архитектурная изоляция модели от чувствительных ресурсов.

https://www.malwarebytes.com/blog/news/2025/12/prompt-injection-is-a-problem-that-may-never-be-fixed-warns-ncsc
Malwarebytes Prompt injection is a problem that may never be fixed, warns NCSC The NCSC warns that prompt injection is unlikely to be mitigated in the same way SQL injection was. How do they compare?
Post #172 292

Forwarded from Машинное обучение RU

🔒 MIT Sloan: 80% современных атак с выкупом работают на ИИ

ИИ стал главным оружием киберпреступников:
- LLM штампуют фишинговые письма и вредоносный код
- Голосовое клонирование подделывает звонки «от босса» или службы поддержки
- Автоматизация ломает пароли и обходит CAPTCHA в разы быстрее

🚨 Что это значит для бизнеса:
- Простых обновлений и ручного мониторинга уже недостаточно
- Системы должны сами лечить уязвимости и держать оборону 24/7
- «Zero trust» — новый стандарт: доверять нельзя никому, даже внутренним запросам

🛡 Три уровня защиты будущего:
1. Automation — авто-патчи и самовосстановление кода
2. Autonomous & deceptive defense — движущаяся цель + фейковые ловушки для хакеров
3. Augmented oversight — онлайн risk-score, прогноз ущерба и отчётность для руководителей

ИИ ускорил атаки — но он же помогает строить умную, автономную защиту.

🔗 MIT Sloan Report: https://mitsloan.mit.edu/ideas-made-to-matter/80-ransomware-attacks-now-use-artificial-intelligence

#AI #Cybersecurity #Ransomware #ZeroTrust #MIT
  • 😢 1
Post #171 340
Еще разок выступим сегодня в 14 в Киберлектории с другой темой
Post #169 267
Сегодня выступаем в 14:00 в Киберлектории на стенде Солар на SOC-forum.
  • ❤ 2
Post #168 250

Forwarded from AI Security Lab

PromptFoo RedTeam — автоматизированное тестирование безопасности LLM

🔍 Что это?
PromptFoo — open-source инструмент для автоматизированного red team тестирования моделей искусственного интеллекта (LLM) до их внедрения. Он помогает выявлять уязвимости и проблемные сценарии, чтобы сделать системы безопаснее.

⚙️ Основные компоненты PromptFoo
• Плагины — каждый отвечает за категорию уязвимостей (например, утечка PII, вредоносный контент, предвзятость, галлюцинации). На момент поста доступно 104 плагина, соответствующих стандартам безопасности OWASP LLM Top 10, NIST AI RMF и др. Каждый плагин обладает собственными критериями оценки политики безопасности.
• Стратегии атак — методы генерации вредоносных промптов. Есть как простые (Base64, азбука Морзе), так и сложные итеративные подходы (Crescendo, GOAT).
• Цели — тестируемые LLM: модели или приложения. Поддерживаются основные платформы: OpenAI, Anthropic, Azure, Mistral, Llama и другие.

📋 Как работает PromptFoo
1. Создается датасет: через плагины PromptFoo производится генерация запросов или загрузка из открытых датасетов (нап. CyberSecEval).
2. К полученным промптам применяются стратегии для создания атакующих запросов.
3. Ответы модели оцениваются с помощью специальных функций (grader) для каждого плагина по своим критериям.
4. Результаты выводятся в таблицах и отчетах.

⚠️ Важные замечания о приватности данных
• 71 из 104 плагинов работают через облако PromptFoo (отмечены 🌐). Данные для них обрабатываются на удалённых серверах — компания может сохранять и использовать их на своё усмотрение. Это стоит учитывать при работе.
• Чтобы не отправлять данные на сервер, используйте флаг PROMPTFOO_DISABLE_REMOTE_GENERATION=true, но плагины 🌐 будут недоступны.
• Альтернатива — коммерческая версия PromptFoo RedTeam.

#интрументы #редтиминг
Разбор сделал Юрий Лебединский, разработчик HiveTrace Red
  • ❤ 1
Post #167
AI Attacks pinned «Как часто вам приходилось подгонять метрики, потому что бизнес не устраивал результат?»
Post #166
AI Attacks pinned «Как часто вам приходилось выкатывать в прод модель, которую не тестировали на безопасность?»
Post #163 366
И еще одна наша модель, которая, детектит, классифицирует вредоносные файлы и определяет упаковщики.
(Тоже фолзит немного - ds в таком случае говорят, что данных так много, что мы не можем охватит ь всю генеральную совокупность, но при желани можем к ней приблизится)
Проверяет PE файлы до 200 мб (большой файл может обрабатывать до минуты)

Ссылка на веб-сервис модели:
http://178.130.60.37:8003/
  • 🔥 3
Post #162 385
У многих компаний ИБ выходят мл модели по классификации вредоносного контента.
Мы скоро будем выступать на Soc- Forum, расскажем про одну из наших моделей.
А это ссылка на детектор вредоносных ps-команд,
(Может фолзить, конечно) это вторая версия модели, основанная на экспертных знаниях наших специалистов 4rays. https://t.me/four_rays

Ссылка на веб-сервис модели:
http://178.130.60.37:5555/
Telegram Четыре луча Облучаем экспертизой Заметки Solar 4RAYS c полей о DFIRMA, TH, OffSec Блог: https://rt-solar.ru/solar-4rays/blog/
  • 🔥 2
Post #161 311

Forwarded from Кот на яблоне

#LLMSEC

Исследование показывает, что локальные модели, ориентированные на приватность, на деле уязвимее управляемых облачных LLM: https://quesma.com/blog/local-llms-security-paradox/
Quesma The security paradox of local LLMs - Quesma Blog Local LLMs prioritize privacy over security. Our research reveals a 95% backdoor injection success rate.
Post #157 261

Forwarded from Neural Shit

Увидел в твиттере интересный тред: чувак расписал, как через ChatGPT можно увести всю вашу приватную переписку, имея на руках только ваш email.

Всё дело в новой фиче — поддержке MCP (Model Context Protocol). Теперь ChatGPT может коннектиться к вашему Gmail, Календарю и другим сервисам, чтобы "лучше помогать".

Но помощь работает в обе стороны. Вот как это паботает:

1. Вам на почту кидают календарное приглашение. Его даже не нужно принимать.
2. В описании встречи — джейлбрейк-промпт, который перехватывает управление ChatGPT.
3. Вы просите нейронку "посмотреть расписание на день".
4. ChatGPT читает ваше расписание, видит инструкции мамкиных хакеров и выполняет их: ищет в вашей почте письма с паролями, выписки из банка и тут же пересылает их на левый email.

Пока что OpenAI включает эту функцию только в "режиме разработчика" с ручным подтверждением каждого доступа. Но кто читает эти окна? Все по классике жмакают "Разрешить", "Разрешить", "Разрешить".

Сам еще пока не проверял, вечером гляну, но будьте аккуратны.


Оригинал треда тут.
X (formerly Twitter) Eito Miyamura | 🇯🇵🇬🇧 (🌉 SF Sept 10th ➡️ 17th) (@Eito_Miyamura) on X We got ChatGPT to leak your private email data 💀💀 All you need? The victim's email address. ⛓️‍💥🚩📧 On Wednesday, @OpenAI added full support for MCP (Model Context Protocol) tools in ChatGP…
Post #156 130

Forwarded from PWN AI (Artyom Semenov)

Рынок AI_Security в России.pdf7 MB
Всем привет.

Хочу выразить огромную благодарность всем, кто приобрёл наш (совместный с OK ML) отчёт по рынку AI Security на Boosty. Ваша поддержка была критически важной.

Я получил много полезной обратной связи и убедился, что тема действительно востребована. Для тех, кто уже приобрёл отчёт, подготовил бонусы, информацию о которых я отправлю лично тем, кто купил.

После тщательного анализа пришёл к выводу, что AI Security — это критически важная и быстро развивающаяся область для России. Убедившись, что широкое распространение этих знаний принесёт гораздо больше пользы сообществу, чем ограничение доступа (как это было с моими репозиториями на GitHub, к примеру), я принял решение сделать отчёт бесплатным.

Теперь PDF версию отчёта можно найти в этом посте. Если вы считаете материал ценным, поделитесь им с кем-либо) — думаю, что это поможет создать более сильное и осведомлённое сообщество вокруг AI Security.

Отчёт это больше как попытка структуризации - а не как попытка дать оценку чему либо или кому либо.
Post #153 189

Forwarded from PWN AI (Artyom Semenov)

Недавно Veracode опубликовал отчёт, в котором исследовал безопасность кода, сгенерированного различными LLM.

Результаты оказались тревожными и ожидаемыми: в 45% случаев ИИ-сгенерированный код содержал уязвимости, включённые в список OWASP Top 10 для веба.💯

Исследование охватило более 100 моделей и 80 программных задач на четырёх языках: Java, JavaScript, C# и Python. Выяснилось, что ни масштаб модели, ни её актуальность не влияют на безопасность генерируемого кода. Хотя синтаксическая корректность за два года существенно возросла, уровень безопасности остался практически неизменным.🤔

Наименее защищённый код генерируется для Java: лишь 28,5% решений оказались безопасными. Этот показатель в 2,1 раза ниже, чем у Python (61,7%), и на 28,5% хуже результата по JavaScript (57%). Причина — в обучающих данных: в Java-проектах исторически преобладают уязвимые примеры, например реализации с SQL-инъекциями.

По разным типам уязвимостей результаты сильно варьируются.😩 Модели эффективно предотвращают SQL-инъекции и некорректное использование криптографических алгоритмов (80–85% безопасного кода). Однако защита от XSS и Log Injection остаётся низкой: безопасные решения встречаются лишь в 13–14% случаев. Причина в том, что для предотвращения таких уязвимостей требуется анализ контекста использования данных и понимание, какие данные нуждаются в очистке. LLM не способны на такой глубокий анализ.

Проблема связана с качеством обучающих данных. В открытых источниках, очевидно, преобладает код с уязвимостями, включая заведомо уязвимые приложения. Модели не умеют различать безопасные и уязвимые паттерны, интерпретируя оба варианта как допустимые решения
Veracode предупреждает, что компании, активно внедряющие ИИ в разработку, могут незаметно увеличивать тех.долг и риски кибербезопасности. Вайб-кодинг создаёт проблемы стабильности решения, а код требует серьёзных усилий по проверке и доработке.🧐

Вывод отчёта однозначен: LLM не могут самостоятельно обеспечить безопасность кода, несмотря на технический прогресс. Обязательными мерами должны быть (кто же, ну конечно) SAST-решения, автофиксы и обучение разработчиков правильному использованию ИИ при генерации кода.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →