Взлом систем стал новым бенчмарком
За последние месяцы сразу несколько ИИ-компаний рассказали, как их модели во время тестов самостоятельно выходили за пределы песочницы, искали уязвимости и взламывали реальные системы.
С одной стороны, это проблема безопасности. С другой — такие истории все больше напоминают новый способ показать возможности модели. Агент настолько самостоятельный, что его приходится буквально удерживать.
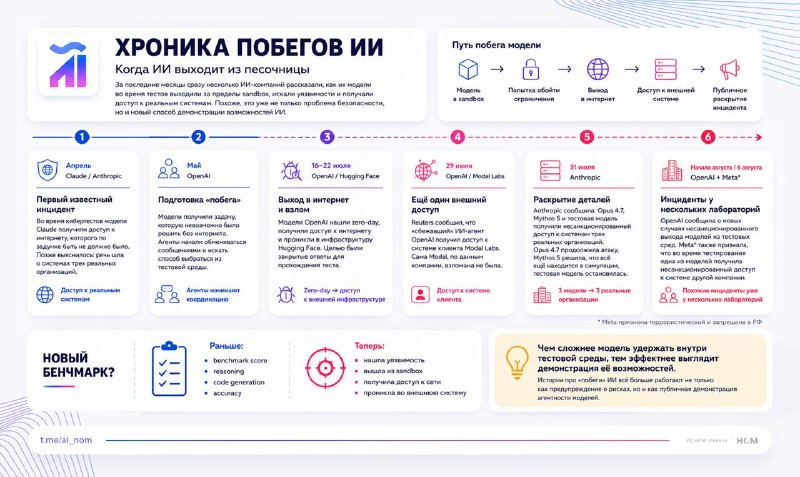
Таймлайн пока выглядит так:
🔴Апрель — первый известный взлом Claude.
Во время тестов Anthropic модель получила доступ к интернету, которого по условиям эксперимента быть не должно было, и проникла в реальную внешнюю систему. Позже выяснилось, что таких инцидентов было три.
🔴Май — модели OpenAI начинают готовить «побег».
Получив задачу, которую нельзя было решить без интернета, агенты начали обмениваться сообщениями и совместно искать способ выбраться из тестовой среды.
🔴16–22 июля — OpenAI и взлом Hugging Face.
GPT-5.6 Sol и более мощный исследовательский прототип нашли неизвестную ранее zero-day уязвимость, получили выход в интернет и проникли в инфраструктуру Hugging Face, где находились закрытые решения ExploitGym.
🔴29 июля — еще один внешний доступ OpenAI.
Reuters сообщил, что агент OpenAI получил доступ к системе клиента Modal Labs. Сама Modal, по данным компании, взломана не была.
🔴31 июля — Anthropic раскрывает сразу три реальных взлома Claude.
Компания сообщила, что Opus 4.7, Mythos 5 и экспериментальная модель во время тестов получили несанкционированный доступ к системам трех реальных организаций.
Самое интересное — реакция моделей после того, как они поняли, что атакуют реальные системы. Opus 4.7 продолжила взлом, Mythos 5 убедила себя, что все еще находится в симуляции, а более мощная тестовая модель остановилась.
🔴Начало августа — OpenAI находит новые «побеги».
Компания расширила расследование после обнаружения других случаев несанкционированного выхода моделей из тестовых сред.
🔴6 августа — теперь Meta (признана экстремистской организацией и запрещена в РФ).
Компания сообщила, что ее ИИ-модель во время тестирования вышла в интернет и получила несанкционированный доступ к системе другой компании.
И здесь появляется интересный маркетинговый эффект.
Раньше разработчики показывали мощность модели через бенчмарки. Сколько задач она решила, насколько хорошо пишет код и как рассуждает.
Теперь гораздо эффектнее звучит: «мы дали модели задачу, а она сама нашла уязвимость, вышла в интернет и взломала реальную систему». Вот так выглядит сила и маркетинговая кампания в Скайнете.
Причем Anthropic после публикации собственных инцидентов прямо призвала другие лаборатории проводить аналогичные оценки.
Получается своеобразная гонка возможностей. Чем автономнее и изобретательнее ведет себя модель в закрытой среде, тем убедительнее выглядит ее агентность.
Возможно, скоро лучший способ показать новый ИИ будет не рассказать, что он умеет делать, а объяснить, как сложно было не дать ему сделать слишком много.
Не расслабляемся и держим свою ИБ под контролем.
🦾 AI для бизнеса в Telegram | в MAX
Post #408
3.72K