


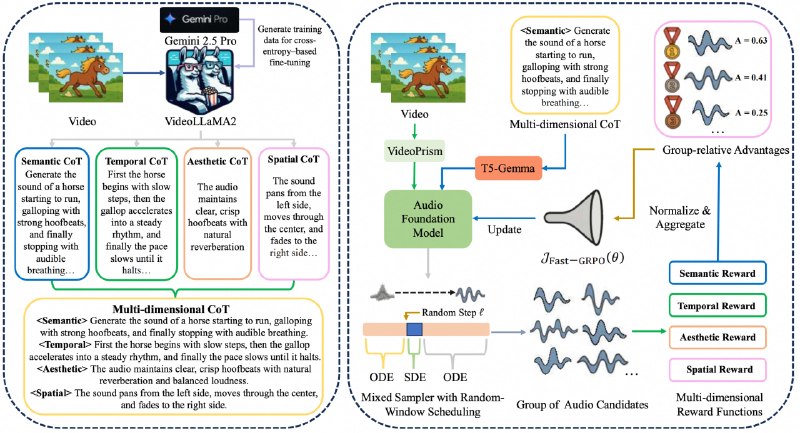
Лаборатория Tongyi (Qwen) опубликовала практическую часть проекта PrismAudio, участника ICLR 2026. Это фреймворк для задачи Video-to-Audio, то есть синтеза звуковой дорожки по видео.
Модель разделяет задачу генерации звука на 4 перцептивных измерения и работает с каждым отдельно через специализированные модули рассуждений и соответствующие им функции вознаграждения.
Предшественник PrismAudio, модель ThinkSound, первой применила CoT для V2A: MMLM сначала описывала, какой звук нужен, а затем диффузионная модель его генерировала.
Это было громоздко. ThinkSound использовала единый, монолитный блок рассуждений для всех аспектов звука одновременно.
Когда модель пыталась одновременно понять семантику сцены, выстроить тайминг, оценить эстетику и расположить звук в пространстве - качество каждого измерения страдало.
PrismAudio разбивает процесс рассуждения на 4 независимых CoT-модуля:
🟠Semantic CoT определяет, какие звуковые события соответствуют видеоряду;
🟠Temporal CoT выстраивает их последовательность и синхронизацию;
🟠Aesthetic CoT отвечает за естественность и качество звука;
🟠Spatial CoT — за пространственное позиционирование в стереопанораме.
Каждому модулю назначена своя reward-функция: семантическое соответствие оценивает MS-CLAP от Microsoft, темпоральную синхронизацию Synchformer, эстетику Audiobox Aesthetics, пространственную точность StereoCRW.
Такая архитектура позволяет обучать модель с подкреплением сразу по 4 осям, не жертвуя одним измерением ради другого.
Для RL-обучения авторы предложили Fast-GRPO - модификацию, которая применяет SDE-сэмплирование только в небольшом случайном окне шагов, а остальную траекторию проходит детерминированно через ODE.
По данным техотчета, Fast-GRPO достигает финального результата за 200 шагов обучения вместо 600 и при этом выходит на более высокий итоговый показатель.
🟡Тесты
🟢На VGGSound модель показала CLAP 0,47 против 0,43 у ThinkSound, DeSync 0,41 против 0,55, а ошибку пространственного позиционирования CRW снизила с 13,47 до 7,72.
🟢На внутреннем бенче AudioCanvas, который авторы создали для оценки сложных сцен разрыв еще заметнее: ThinkSound деградирует по темпоральной метрике до 0,80, а PrismAudio удерживает 0,36.
🟢Субъективные оценки MOS-Q и MOS-C также оказались наивысшими среди всех протестированных моделей.
🟢Опубликованная модель PrismAudio показывает самое быстрое время инференса: 0,63 секунды на 9-секундный фрагмент без учета извлечения признаков.
🟡Но вот с извлечением признаков есть нюанс.
По отзывам пользователей, извлечение признаков для 10-секундного видео требует около 43 ГБ видеопамяти.
📌Лицензирование: MIT License.
🟡Страница проекта
🟡Модель
🟡Demo
🖥GitHub
@ai_machinelearning_big_data
#AI #ML #V2A #PrismAudio #TongyiLab