


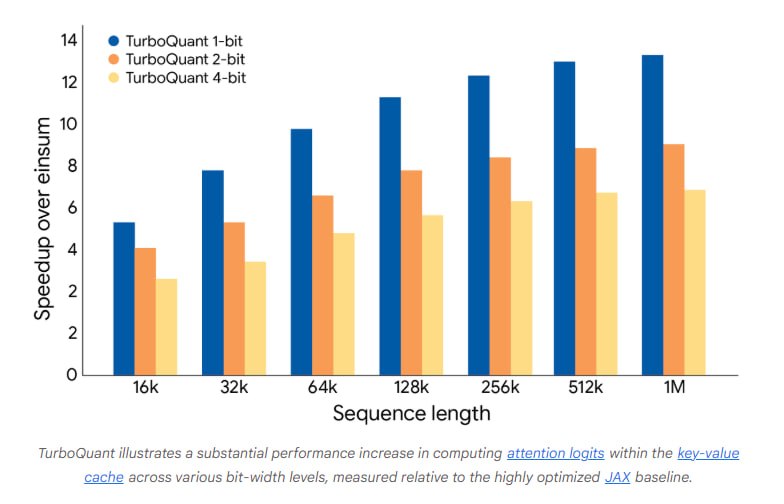
Подразделение Research анонсировало TurboQuant, алгоритм векторного квантования, объединяющий 2 других метода - QJL и PolarQuant, который решает проблему увеличения KV-кэша при работе с длинным контекстом.
TurboQuant будет представлен на ICLR 2026, PolarQuant - на AISTATS 2026.
KV-кэш хранит промежуточные представления токенов, чтобы модель не пересчитывала их на каждом шаге генерации. С ростом контекста он превращается в узкое место по памяти.
Обычное векторное квантование сжимает эти данные, но вносит накладные расходы: для каждого блока нужно хранить константы квантования в полной точности, а это плюс 1–2 бита на элемент, что частично обесценивает само сжатие.
🟡TurboQuant - двухэтапный пайплайн.
Сначала PolarQuant: случайный поворот выравнивает геометрию векторов, после чего они переводятся из декартовых координат в полярные (радиус и угол). Распределение углов оказывается предсказуемым и сконцентрированным, поэтому нормализация и хранение дополнительных констант становятся больше не нужны.
На втором этапе подключается QJL, метод на основе преобразования Джонсона-Линденштраусса, который кодирует остаточную ошибку первого этапа всего одним знаковым битом и через встроенную оценочную функцию сочетает высокоточный запрос с низкоточными сжатыми данными, корректно вычисляя attention score.
Ни один из методов не требует обучения или дообучения и работает в режиме "без предварительного анализа набора данных".
Алгоритмы тестили на бенчмарках для длинного контекста: LongBench, Needle In A Haystack, ZeroSCROLLS, RULER и L-Eval с моделями Gemma и Mistral.
При квантовании KV-кэша до 3 бит TurboQuant показал нулевую деградацию точности на всех задачах: поиск «иголки в стоге сена», QA, генерация кода, суммаризация.
Объем KV-кэша при этом сократился в 6 раз. На H100 четырехбитный TurboQuant ускорил вычисление attention-логитов до 8 раз по сравнению с 32-битными ключами.
Область применения не ограничивается KV-кэшем. В экспериментах с высокоразмерным векторным поиском TurboQuant стабильно превзошел по recall методы PQ и RaBitQ несмотря на то, что те использовали крупные код-буки и подстройку под конкретный датасет.
🟡Статья
🟡Arxiv
@ai_machinelearning_big_data
🎯Полезные Мл-ресурсы 🚀 Max
#AI #ML #LLM #TurboQuant #Google