
✔️ Sakana AI придумали, как LLM самим сортировать контекст по важности
Обычные языковые модели читают текст как одну длинную ленту.
Что ближе к началу внимания - то “важнее”.
Что дальше - то модель видит хуже.
И тут появляется проблема: если важный факт спрятан где-то далеко среди шума, модель может его просто не использовать.
Она тратит внимание на всё подряд, вместо того чтобы сосредоточиться на главном.
Sakana AI предложили решение - RePo (Context Re-Positioning).
Идея очень понятная: модель получает модуль, который позволяет динамически “перепозиционировать” контекст.
Примерно как человек:
ты читаешь длинный документ, понимаешь, что важная часть была 20 страниц назад - и мысленно перечитываешь её, а лишнее игнорируешь.
Что делает RePo
- подтягивает важные куски информации ближе
- отодвигает шум и лишний текст
- помогает вниманию модели фокусироваться на нужном
В модели есть обучаемый модуль, который **переназначает позиции токенов по смыслу**, а не по порядку
✅ важно = то, что помогает уменьшать ошибку модели и правильно решать задачу
❌ второстепенно = то, что не помогает (шум), поэтому “отодвигается” по позициям
В результате модель с такой памятью начинает лучше работать там, где LLM обычно страдают:
- когда контекст длинный
- когда много шума
- когда важные детали раскиданы далеко друг от друга
- когда данные структурированные (таблички, списки, правила)
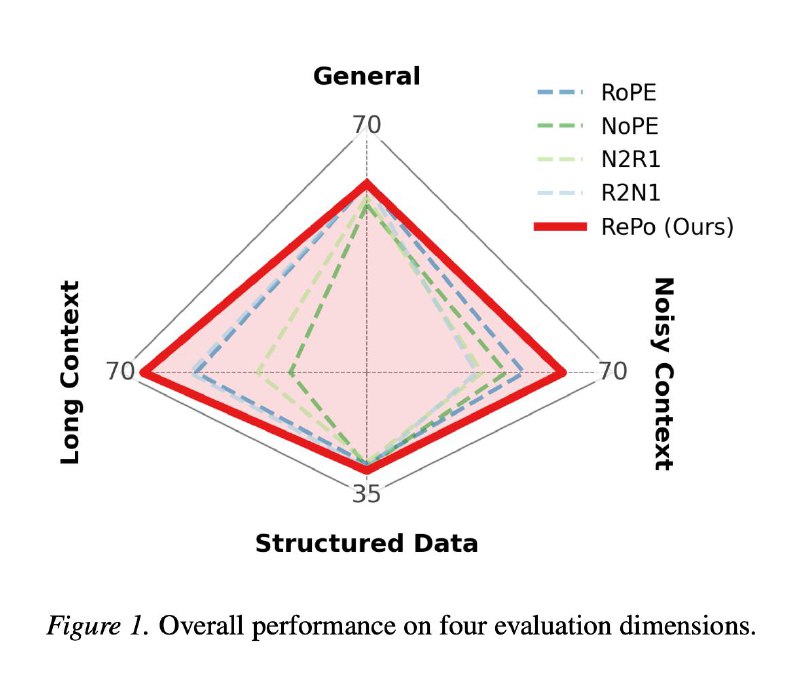
Авторы показывают, что RePo даёт заметный прирост устойчивости, при этом не ухудшая общее качество.
▶️ Устойчивость к шуму (Noisy Context)
Средний результат по 8 noisy-бенчмаркам:
- Обычный RoPE: 21.07
- RePo: 28.31
🟡 Прирост: +7.24 пункта (сильно)
Авторы отдельно фиксируют ключевую цифру:
на noisy-eval (4K контекст) RePo лучше RoPE на +11.04 пункта.
🔥 Примеры прироста на конкретных задачах
(везде RePo > RoPE)
- TriviaQA: 61.47 → 73.02 (+11.55)
- GovReport: 6.23 → 16.80 (+10.57)
- 2WikiMultihopQA: 23.32 → 30.86 (+7.54)
- MuSiQue: 7.24 → 13.45 (+6.21)
Это шаг к моделям, которые не просто “читают что дали”, а умеют сами организовать свою рабочую память.
🟡Подробности: pub.sakana.ai/repo/
🟡Статья: arxiv.org/abs/2512.14391
@ai_machinelearning_big_data
#RePo #SakanaAI #LLM #AI #AIAgents #Context #LongContext #Attention
Post #9395
37.7K


- ❤ 84
- 🔥 36
- 👍 14
- 🐳 1
- 🦄 1