

Новая версия рассчитана на длинную работу в одной сессии - модель ведет несколько параллельных задач в одном треде, сама набирает контекст инструментами из разных источников, замечает и латает пробелы в собственном плане и держит в памяти все, что успела выяснить, до готового результата.
Отдельно доработали поведение с человеком. Она задает уточняющие вопросы, когда запрос неоднозначен, зовет на помощь, когда застряла, и спрашивает подтверждения перед необратимыми действиями.
На долгих задачах подстраивается под привычки пользователя, т.е либо регулярно отчитывается, либо молча работает в фоне.
В длинном контексте точнее понимает, к какой задаче относится новое сообщение - правит ли пользователь давнюю просьбу или перебивает текущую.
Еще заявляют, что модель стала лучше понимать собственные пределы. Зайдя в тупик, она должна сообщить об этом, а не выдумывать результат.
🟡Код
Здесь Muse Spark 1.3 натаскивали на объемных инженерных задачах. По сравнению с версией 1.2 она делает меньше лишних ходов, меньше разглагольствует и кодит чище.
В сравнениях инженеров Meta новая версия оказалась экономнее - на 20% меньше вызовов инструментов и на 25% меньше токенов.
🟡Бенчмарки
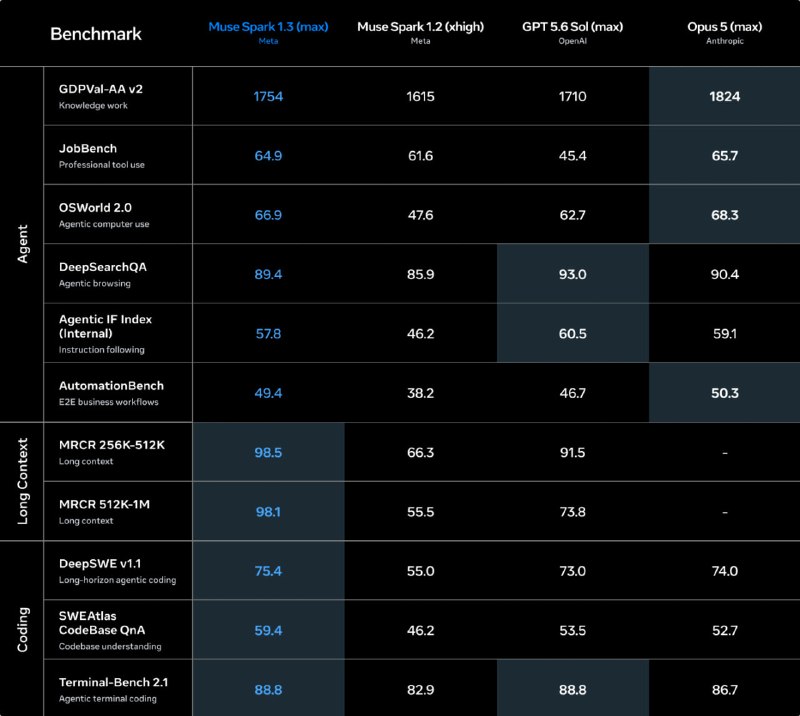
Версию 1.3 в режиме максимального ризонинга сравнили с прошлой версией, GPT-5.6 Sol и Claude Opus 5.
Относительно версии 1.2 прирост везде, а местами - приростище.
OSWorld 2.0 (работа с компьютером) - 66,9 против 47,6. Внутренний индекс следования инструкциям - 57,8 против 46,2. AutomationBench (бизнес-процессы) - 49,4 против 38,2. DeepSWE (длинные задачи по коду) - 75,4 против 55,0.
Самый резкий скачок на длинном контексте, и там же единственная категория, где Muse Spark лидирует безоговорочно.
На MRCR в диапазоне от 256 до 512 тысяч токенов - 98,5 против 66,3 у прошлой версии и 91,5 у GPT-5.6 Sol. На отрезке от 512 тысяч до миллиона отрыв еще больше: 98,1 против 55,5 и 73,8. У Opus 5 результатов в этой категории нет.
В коде тоже первое место.
DeepSWE 75,4 против 74,0 у Opus и 73,0 у Sol, понимание кодовой базы на SWEAtlas - 59,4 против 52,7 и 53,5, а на Terminal-Bench 2.1 ничья с Sol, 88,8 у обоих.
А вот в агентной части результаты скромнее.
Opus 5 впереди на четырех тестах из шести - GDPVal-AA v2 (1824 против 1754), JobBench (65,7 против 64,9), OSWorld (68,3 против 66,9) и AutomationBench (50,3 против 49,4). GPT-5.6 Sol забирает агентный браузинг (93,0 против 89,4) и следование инструкциям (60,5 против 57,8).
🟡Безопасность и доступность
Модель стала устойчивее к состязательным вводам и промпт-инъекциям, а на сложных агентных задачах лучше калибрована в том, какие действия необратимы.
Muse Spark 1.3 доступна в клиенте Muse Code для macOS и Linux и через Meta Model API.
Дальше в планах - релиз более крупных модели и открытая публикация весов Muse Spark.
*организация признана экстремистской, её деятельность на территории РФ запрещена.
@ai_machinelearning_big_data
#news #ai #ml