TGViewer
Channel Public Channel
Интеллект в коде: Python, AI, Data Science

Интеллект в коде: Python, AI, Data Science

@ai_in_progress

Обучаюсь Data Science и делюсь практикой: Python, аналитика данных, машинное обучение и новости AI.
Конспекты, разборы задач, примеры кода и свежие технологии, всё по делу и без «воды».
Для тех, кто идёт в AI от нуля к проектам.

Связь: @Ml_panda_user
Subscribers
125
Photos
195
Videos
22
Links
65

Showing posts older than #34 · Back to latest

Older Posts 20 shown
Post #33 34
Привет, друзья! 👋

Рад вас видеть здесь! 🚀 С сегодняшнего дня я начинаю делиться интересными мыслями, новостями и идеями на тему искусственного интеллекта. Если вам интересно, как технологии меняют наш мир, как ИИ помогает в работе, учебе, творчестве и даже в повседневной жизни — вам точно будет полезно заглядывать сюда.

Буду рассказывать просто и понятно, без лишних сложностей. Мы вместе разберемся, как использовать ИИ на максимум, чтобы сделать жизнь проще, продуктивнее и интереснее.

Давайте вместе погружаться в эту увлекательную тему! Если у вас есть вопросы или идеи для обсуждения, пишите в комментариях — будем общаться. 😊

Поехали! 🚀
  • 🤔 3
  • 💯 2
Post #32 39
Друзья, делюсь свежими новостями из мира нейронных сетей и искусственного интеллекта на 16 января 2025 года:

Nvidia на CES 2025 🎉

На выставке CES 2025 в Лас-Вегасе компания Nvidia представила ряд инновационных решений:

- Project Digits: компактный настольный суперкомпьютер с чипом gb10 Grace Blackwell, 20-ядерным процессором, 128 ГБ оперативной памяти и 4 ТБ флеш-памяти. Устройство способно локально запускать модели с параметрами от 100 до 200 миллиардов токенов, а объединение двух таких устройств позволяет работать с моделями уровня Llama на 405 миллиардов параметров.

- Чипы gb2 NV L72: по заявлению Nvidia, они в 30-40 раз превосходят предыдущее поколение h100 по скорости выполнения задач, что критически важно для современных моделей ИИ.

- Cosmos World Foundation Models: модель, предназначенная для генерации синтетических данных, необходимых для обучения роботов и других AI-систем. Она обучалась на 20 миллионах часов видеоконтента и обладает параметрами от 4 до 14 миллиардов токенов.

Илон Маск и Grok 3 🚀

Илон Маск анонсировал скорый релиз Grok 3 — новой версии своей AI-модели, которая, по его словам, в 20 раз превзойдет по вычислительным ресурсам предыдущие версии и сможет конкурировать с GPT-4. Он также заявил о планах по созданию видеомодели Grok Video и выразил уверенность в том, что в ближайшие 3-4 года искусственный интеллект достигнет уровня, превосходящего человеческие когнитивные способности.

OpenAI и ChatGPT 🤖

Несмотря на высокую стоимость подписки ChatGPT Pro в 200 долларов в месяц, OpenAI продолжает нести убытки из-за интенсивного использования ресурса пользователями. Компания также объявила о наборе сотрудников для развития направления робототехники, планируя создавать универсальных и адаптивных роботов, способных взаимодействовать с человеком. Появились первые изображения обновленного интерфейса ChatGPT с более удобной навигацией и возможностью кастомизации обращения к пользователю.

Тенденции в развитии нейронных сетей 📈

К 2025 году наблюдаются следующие тенденции:

- Генеративный ИИ: выходит за рамки текста и изображений, охватывая звуковую среду, 3D-модели, виртуальные миры и видеоконтент. Нейросети научились генерировать сложные музыкальные композиции, интерактивные виртуальные пространства и короткие видеоролики по сценарному описанию.

- Энергетическая эффективность и "зеленый AI": разработчики стремятся снизить энергопотребление нейронных сетей через квантовые вычисления, аппаратную оптимизацию и алгоритмические усовершенствования. Это важно не только для экологии, но и для снижения расходов корпораций и сервис-провайдеров.

Внедрение ИИ в медицину 🏥

В 2025 году цифровые технологии, включая нейросети, все шире применяются в медицине для увеличения продолжительности жизни и повышения ее качества. Примеры включают системы поддержки принятия решений для врачей, проекты в области медицинской логистики и мобильные приложения для пациентов.

Эти события и тенденции подчеркивают стремительное развитие технологий нейронных сетей и их интеграцию в различные сферы жизни.
  • 👍 3
  • 🔥 2
  • ❤ 1
Post #31 38
💡 F-строки в Python: Удобство и Простота 💻🐍

F-строки, или форматированные строки, появились в Python 3.6 и стали одним из самых удобных инструментов для работы с текстом. Они позволяют встраивать переменные и выражения прямо внутрь строки. Давайте разберемся, как это работает! 🔍

🧩 Как создать f-строку?

F-строка начинается с буквы f или F перед кавычками. Внутри строки можно использовать фигурные скобки {} для вставки переменных или выражений.
name = "Анна"
age = 25

# Пример f-строки
message = f"Привет, {name}! Тебе {age} лет. 🎉"
print(message)
# Вывод: Привет, Анна! Тебе 25 лет. 🎉


✨ Преимущества f-строк

- Простота синтаксиса – легко читается и пишется.
- Возможность вставки выражений – можно выполнять вычисления прямо внутри строки.
a = 5
b = 10

print(f"Сумма: {a + b}, Разность: {b - a}")
# Вывод: Сумма: 15, Разность: 5


🎨 Форматирование f-строк

F-строки поддерживают форматирование данных. Например, округление чисел или добавление нулей.
pi = 3.14159

# Округление числа
print(f"Число π: {pi:.2f}")
# Вывод: Число π: 3.14

# Число с ведущими нулями
number = 42
print(f"Номер: {number:05}")
# Вывод: Номер: 00042


🔥 Динамическая генерация

F-строки могут использовать функции и методы прямо внутри строки.
name = "иван"

print(f"Привет, {name.capitalize()}!")
# Вывод: Привет, Иван!


⚠️ Важно знать

- F-строки работают только с Python 3.6 и выше.
- Они не поддерживают экранирование выражений {}. Чтобы вывести фигурные скобки, используйте удвоение: {{ и }}.
value = 100
print(f"{{value}} означает: {value}")
# Вывод: {value} означает: 100


🎯 Итог
F-строки — это мощный инструмент для создания понятного и красивого кода. Попробуйте использовать их в своих проектах, и вы больше не захотите возвращаться к старым способам форматирования строк! 🌟

👉 А как ты используешь f-строки? Делись в комментариях! 😊
  • 🔥 3
Post #29 52
Переменные в Python: Основы и Примеры

Привет! Сегодня мы разберём одну из самых базовых, но очень важных тем в программировании на Python — переменные. Они являются основой любой программы, так как позволяют сохранять, обрабатывать и передавать данные. Если вы только начинаете изучать Python, этот пост для вас! Если вы только начинаете изучать Python, этот пост для вас.

Что такое переменные?
Переменные — это именованные контейнеры для хранения данных. Они позволяют программе запоминать информацию для последующего использования. Например, вы можете хранить имя пользователя, возраст, результат вычислений и многое другое.

Представьте переменные как ячейки в памяти компьютера, каждая из которых имеет имя и значение. Например, это как подписанные банки с продуктами на кухне: один может хранить сахар, другой — муку, а третий — соль. Имя банки помогает быстро понять, что в ней находится.

Правила именования переменных
- Имя переменной должно начинаться с буквы (но не с цифры!).
- Python чувствителен к регистру, то есть Name и name — это разные переменные.
- Нельзя использовать ключевые слова Python в качестве имён переменных (например, if, while, def).


Примеры правильных имён:
user_name = "Иван"
count2 = 5
total = True


Примеры неправильных имён:
2user = "Оля"   # Нельзя начинать с цифры
user-name = 20 # Нельзя использовать дефис
if = "значение" # Ключевое слово


Типы данных в переменных
В Python переменные не требуют явного указания типа данных. Интерпретатор автоматически определяет тип на основе значения. Основные типы данных:
int: Целые числа
float: Числа с плавающей точкой
str: Строки (текст)
bool: Логические значения (True/False)

x = 10          # int
pi = 3.14 # float
text = "Hello" # str
is_active = True # bool


Python поддерживает динамическую типизацию, что означает, что переменная может менять тип данных:
x = 10       # x - это int
x = "Текст" # теперь x - это str
  • 🔥 3
Post #27 61
💡 Основы Python: Типы данных и переменные

Python предоставляет мощные инструменты для работы с данными:

1️⃣ Числа (Numbers):

* Типы данных: целые числа (int) и дробные (float).
* Поддерживаются арифметические операции: сложение, вычитание, умножение.
Пример:
a = 3
b = 4.5
print(a + b) # 7.5


2️⃣ Строки (Strings):
* Это текстовые данные в кавычках.
* Операции:
🔹 Сложение строк:
greeting = "Привет"
name = "Мир"
print(greeting + name) # ПриветМир

🔹 Умножение строки на число:
phrase = "Ура! "
print(phrase * 3) # Ура! Ура! Ура!


3️⃣ Логические значения (Booleans):

* Представляют истину (True) или ложь (False).
* Используются для проверок и условий.
Пример:
print(3 > 5) # False
print(3 < 5) # True
print(not (3 > 5)) # True

📌 Переменные:
Переменные хранят данные для использования в коде.
Пример:
курс_доллара = 75.81
цена = 100
стоимость = цена * курс_доллара
print("Стоимость в рублях:", стоимость) # Стоимость в рублях: 7581.0


Вывод:
Python — это простой, но мощный инструмент, который подходит для работы с любыми типами данных. Освоив основы, ты сможешь создать что угодно — от игр до аналитических приложений. 🚀

#Python #Программирование #Обучение
  • 🔥 4
Post #26 58
Почему стоит выбрать Python? 🐍💻

Привет, друзья! 👋 Сегодня расскажу, почему Python – это не просто язык программирования, а настоящий универсальный инструмент, который подойдет каждому.

1️⃣ Простота и красота
Python понятен даже новичкам. Его код читается легко, как английский текст. Сложные задачи выглядят лаконично, и это позволяет сосредоточиться на сути, а не на синтаксисе. 🚀

2️⃣ Универсальность
Python – это про всё! Разработка сайтов, создание игр, анализ данных, искусственный интеллект, автоматизация задач – его применяют где угодно. 🎮📊🤖

3️⃣ Мощное сообщество
Миллионы разработчиков готовы помочь. Форумы, статьи, документация – найти ответы на вопросы проще простого. 🌍🙌

4️⃣ Богатые библиотеки
От анализа данных до разработки ИИ – библиотеки Python покрывают всё. Pandas, TensorFlow, Django – инструменты на любой вкус. 📚✨

5️⃣ Отличные перспективы
Python любят крупные компании: Google, Netflix, Instagram, YouTube. Знание этого языка открывает перед вами крутейшие карьерные возможности. 🔥

Python – это язык, который мотивирует учиться, создавать и воплощать идеи. Если вы задумывались, с чего начать или какой язык выбрать, попробуйте Python. Уверен, он вас впечатлит! 💡

А вы уже пробовали Python? Или, может, только собираетесь? Делитесь своими мыслями в комментариях! 👇🐍

#Python #Кодинг #Программирование #IT
  • 🔥 3
  • ❤ 1
Post #23 61
📊✨ Как работать с пропусками в данных

Пропуски в таблицах — это проблема, с которой сталкиваются все, кто анализирует данные. Важно знать, как с ними справляться:

1️⃣ Удаление 🗑 — подходит, если пропусков мало и их удаление не повлияет на результаты.

2️⃣ Заполнение 🔧 — если данные важны, пропуски лучше заполнить:

- Числовые данные ➡️ средним, медианой или самым частым значением.
- Категориальные данные ➡️ значением, которое встречается чаще всего.
📁💡 А ещё, вот файл с полезными функциями для работы в Google Таблицах и Excel! Он поможет тебе ускорить обработку данных и сделать всё суперэффективно! 🚀✨
Post #22 69
📊 Что такое описательная статистика? Простыми словами!

Описательная статистика — это способ разобраться в данных и сделать их понятными. Она помогает навести порядок, красиво показать данные и описать их важные характеристики.

Основные задачи:
1️⃣ Привести данные в порядок.
Например, разобраться, что означают числа, и как они связаны между собой.

2️⃣ Показать данные наглядно.
Использовать графики, таблицы или диаграммы, чтобы сразу видеть общую картину.

3️⃣ Описать данные числами.
Найти показатели, которые помогают быстро понять, что происходит.

Ключевые показатели:
- Среднее (AVERAGE) 🎯
Это как найти "средний балл" в классе. Например:
Петя получил 3, Оля — 4, Лена — 5. Среднее:
(3+4+5)/3=4
⚠️ Но если кто-то получил 2, то среднее станет
(2+3+4+5)/4=3.5
Среднее "чувствует" выбросы, поэтому иногда не очень точно описывает данные.

- Медиана (MEDIAN) 🏅
Это "срединное число". Если оценки: 2, 3, 7, то медиана = 3.
Если чисел больше: 2, 3, 4, 7, медиана будет между 3 и 4:
(3+4)/2=3.5.
Она устойчивее к крайним значениям, чем среднее.

- Мода (MODE) 🔄
Это "самое частое число". Например, в наборе 2, 2, 3, 4 мода = 2, потому что встречается чаще всех.

Пример из жизни:
В компании есть зарплаты:
* 💰 30 тысяч
* 💰 35 тысяч
* 💰 40 тысяч
* 💰 45 тысяч
* 💰 100 тысяч

- Среднее:
(30+35+40+45+100)/5=50. Кажется, зарплата высокая, но 100 тянет среднее вверх.

- Медиана: 40. Большинство получают ближе к 40, а не 50.

- Мода: если вместо 40 у нескольких сотрудников 35, то мода будет 35.

Такой подход помогает взглянуть на данные с разных сторон и увидеть полную картину! 🔍

#статистика #анализданных #простоянезаморочно
  • 🔥 4
  • 👍 1
Post #20 74
Сегодня я изучил, что такое Data Understanding 🔍📊

Data Understanding — вторая фаза методологии CRISP-DM, которая помогает понять, как правильно работать с данными и подготовить их для анализа. Это критический этап, который задает основы для дальнейшей работы.

Вот что я узнал:

✨ Сбор данных 📥
Сначала важно понять, откуда берутся данные. Это могут быть:

- First-party data — данные, собранные компанией (например, с сайта или приложения).
- Second-party data — данные, купленные у других организаций.
- Third-party data — агрегированные данные, которые покупаются у специализированных поставщиков.
- Открытые данные — доступные для всех, например, государственные статистики.
Данные могут быть собраны через таблицы, базы данных, файлы или с помощью API.

✨ Описание данных 📑
Здесь мы используем описательную статистику, чтобы выявить ключевые характеристики данных:
- Средние значения, медиану, дисперсию.
- Частотные распределения и отклонения.
Это помогает лучше понять структуру данных и их особенности.

✨ Исследование данных 🔍
На этом этапе выдвигаем гипотезы и анализируем, как признаки данных могут быть связаны между собой. Также проводится визуализация данных, чтобы выявить скрытые паттерны и аномалии.

✨ Проверка качества данных ✅
Очень важно на этом этапе проверить данные на ошибки:
- Пропущенные значения.
- Выбросы и аномалии.
- Дубликаты или некорректные записи.
Исправление этих ошибок или минимизация их влияния обеспечит более точное моделирование.

Data Understanding — это основа для дальнейшего успеха в анализе данных. Этот этап помогает избежать ошибок и строить точные модели, которые принесут реальную ценность бизнесу. 🚀

#DataScience #CRISPDM #DataUnderstanding #MachineLearning
  • ⚡ 5
Post #15 71
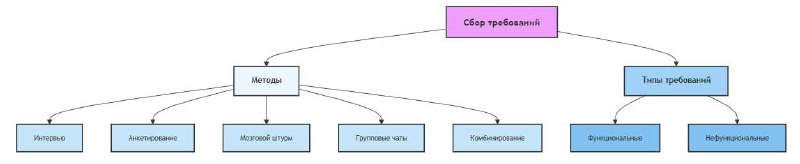
💡 Как собирать и классифицировать требования к проекту?

Сбор и оформление требований — важнейший этап в любом проекте. Без чётких требований сложно понять, что нужно делать и как это должно работать.

👥 Методы сбора требований:
1️⃣ Интервью: общение с заказчиком от общего к частному. Используйте открытые вопросы, чтобы узнать больше, закрытые — для подтверждения, и альтернативные — чтобы уточнить.
📋 Совет: фиксируйте договорённости и обсуждения, чтобы избежать недоразумений.

2️⃣ Анкетирование: быстрый и дешевый способ уточнить уже известные моменты.
📋 Минус: не позволяет задать уточняющие вопросы.

3️⃣ Мозговой штурм: коллективный способ генерировать идеи.

4️⃣ Групповые чаты: удобный формат для обсуждений и обмена мнениями.

5️⃣ Комбинирование методов: лучший результат достигается при использовании разных подходов.

⚙️ Типы требований:

Функциональные: что должна делать система.
Пример: модель классифицирует заёмщиков по категориям.
Нефункциональные: как именно система выполняет функции.
Пример: модель классифицирует заёмщика не дольше 5 секунд.
🎯 Итог: правильное понимание требований — ключ к успешному проекту!

#DataScience #ProjectManagement #Требования #ФункциональныеТребования #НефункциональныеТребования #ЭффективнаяКоманда #СборТребований
  • 🔥 4
Post #13 69
Как важно учитывать потребности стейкхолдеров в проекте 🔑

Когда вы начинаете новый проект, важно помнить о всех заинтересованных людях или организациях, которые могут повлиять на его успех. Эти люди называются стейкхолдерами, и у каждого из них есть свои потребности, цели и требования.

Кто такие стейкхолдеры? 👥

Стейкхолдеры — это люди или организации, которые имеют интерес в проекте и могут повлиять на его результаты. Это могут быть владельцы бизнеса, инвесторы, клиенты, поставщики, сотрудники и даже местные власти.

Пример из жизни: Открытие кафе ☕️

Потребность: Жители района хотят место, где можно выпить вкусный кофе и провести время. 🍵

Цель: Открыть кафе с уютной атмосферой и доступными ценами. 🏠

Требование: Качественное меню, аренда подходящего помещения, хорошая кофемашина. 🍽

Стейкхолдеры: Владельцы кафе, поставщики, клиенты и местные власти — все имеют свои интересы и требования. 🤝

Успех проекта зависит от того, как хорошо вы понимаете и балансируете эти интересы. Важно не только получить нужные результаты, но и учесть ожидания каждого стейкхолдера, чтобы все остались довольны! 🚀

#Стейкхолдеры #УспехПроекта #Кафе #Бизнес
  • 🔥 3
Post #10 73
Сегодня узнал, как связать бизнес и данные! 🤝📊

💼 Что такое Business Understanding?
Это когда мы берём бизнес-цель (например, "удвоить кредиты 💳") и превращаем её в задачу для анализа данных.

📋 Как это работает:

1. Понять бизнес-процесс: Как компания делает свой продукт или услугу? 🛠
2. Поставить цель: Например, "увеличить продажи, не поднимая цены" 💰.
3. Оценить ситуацию:
- Какие есть ресурсы? (данные, люди, оборудование) 🧑‍💻📦
- Что может помешать? (ограничения, риски) ⚠️
4. Перевести цель на язык данных:
- Установить метрики (например, точность прогноза 📈).
- Решить, как поймём, что всё получилось (критерии успеха ✅).
5. Составить план: Сроки, задачи, кто за что отвечает 🗓⏳.
Этот подход помогает точно понимать, что нужно бизнесу, и как данные могут это решить. 🌟
  • 🔥 3
Post #9 70
Немного разъяснения по этапам
Post #6 79
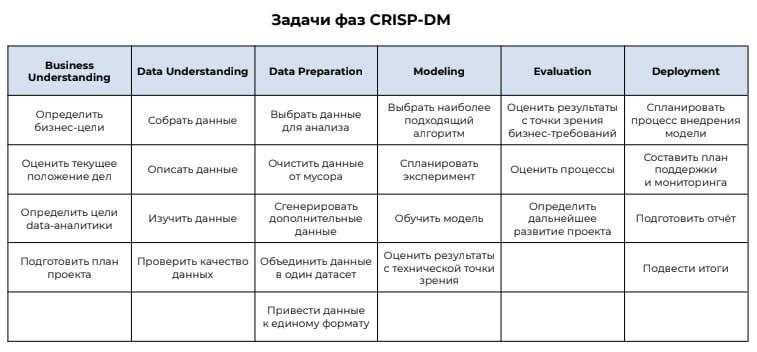
📊 Что такое CRISP-DM (Cross-Industry Standard Process for Data Mining) и как это помогает в анализе данных?

CRISP-DM — это методология для структурированного анализа данных, состоящая из 6 фаз. Она помогает эффективно работать с данными и решать бизнес-задачи, обеспечивая точные и полезные результаты.

Вот основные этапы:

- Business Understanding (Понимание бизнеса) — определяем цели.
- Data Understanding (Изучение данных) — анализируем доступные данные.
- Data Preparation (Подготовка данных) — очищаем и формируем данные для анализа.
- Modeling (Моделирование) — выбираем алгоритмы и строим модели.
- Evaluation (Оценка) — проверяем, насколько модель решает задачу.
- Deployment (Внедрение) — внедряем модель в рабочий процесс.

CRISP-DM используется в различных областях: от маркетинга до финансов, и помогает принимать более обоснованные решения на основе данных.
  • 🔥 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →