

Когда мы обучаем модель машинного обучения, важно понимать, насколько хорошо она справляется с задачей. Но как это сделать правильно? Ведь если оценивать модель на тех же данных, на которых она обучалась, результат может оказаться слишком оптимистичным.
Здесь на помощь приходит train-test split — метод разделения данных на две части: тренировочную и тестовую .
Как это работает?
1. Разделение данных :
Весь датасет делится на две выборки:
- Тренировочная (70-80%) : На этих данных модель учится.
- Тестовая (20-30%) : Эти данные используются для проверки качества модели.
Пример пропорций: 80/20 или 70/30. Главное — тестовая выборка должна быть достаточно большой, чтобы оценка была репрезентативной.
2. Случайный отбор :
Данные распределяются случайным образом, чтобы тестовая выборка отражала все возможные случаи из исходных данных.
3. Оценка качества :
После обучения модели на тренировочной выборке её "экзаменуют" на тестовой. Это позволяет понять, как модель справляется с данными, которые она раньше не видела.
Метрики качества
Чтобы оценить, насколько хорошо работает модель, используют различные метрики. Одна из самых простых — точность (accuracy) .
Точность (accuracy)
Это отношение правильных прогнозов к общему количеству прогнозов:
Accuracy = Количество правильных предсказаний / Общее количество предсказаний
Пример кода:
from sklearn.metrics import accuracy_score

# true_label — истинные метки, pred_label — предсказания модели
accuracy = accuracy_score(true_label, pred_label)
print(f"Точность модели: {accuracy:.2f}")
Матрица ошибок (Confusion Matrix)
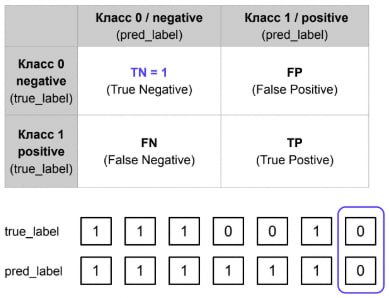
Если задача классификации имеет два класса (например, 0 и 1), то оценить качество можно с помощью матрицы ошибок . Это таблица, которая показывает, сколько раз модель правильно или неправильно предсказала каждый класс.
Четыре ключевых показателя:
➖True Positive (TP) : Элементы, верно предсказанные как положительный класс (класс 1).
➖True Negative (TN) : Элементы, верно предсказанные как отрицательный класс (класс 0).
➖False Positive (FP) : Элементы, предсказанные как положительный класс, но на самом деле относящиеся к отрицательному.
➖False Negative (FN) : Элементы, предсказанные как отрицательный класс, но на самом деле относящиеся к положительному.
Пример кода:
from sklearn.metrics import confusion_matrix

# Строим матрицу ошибок
matrix = confusion_matrix(true_label, pred_label)
print("Матрица ошибок:")
print(matrix)
Почему это важно?
➖Train-test split помогает избежать переобучения модели. Переобученная модель отлично работает на тренировочных данных, но плохо обобщает новые данные.
➖Матрица ошибок позволяет глубже понять, где именно модель ошибается. Например, много ложноположительных результатов (FP) может говорить о том, что модель слишком агрессивно предсказывает положительный класс.
#MachineLearning #DataScience #TrainTestSplit #ConfusionMatrix