TGViewer
Channel Public Channel
AI for Devs

AI for Devs

@ai_for_devs

По сотрудничеству пишите в личные сообщения канала.

Канал для разработчиков про AI. Модели, ИИ-агенты, практические кейсы и новости из мира AI. Всё, что можно применить в работе.
Subscribers
17.4K
Photos
412
Videos
123
Links
370

Showing posts older than #367 · Back to latest

Older Posts 14 shown
Post #366 8.21K
Мы в бар 🥳🥳🥳

Всем прекрасного понедельника :D
  • 🔥 49
  • 👏 16
  • ❤ 7
  • 😁 6
Post #364 10.9K
Когда попросил одного агента написать промпт для другого агента
  • 😁 74
  • 💯 20
  • 🔥 11
  • ❤ 5
Post #361 13.8K
⚡️ Anthropic выпустили Claude Opus 4.7

Cursor зафиксировал рост с 58% до 70% на своём бенчмарке, Rakuten — трёхкратный рост решённых production-задач.

Новый уровень effort xhigh добавили между high и max. В Claude Code он теперь включён по умолчанию.

Параллельно вышел /ultrareview в Claude Code — команда запускает отдельную review-сессию, которая прогоняется по всем изменениям и ищет баги и архитектурные проблемы.

Цена та же: $5/$25 за млн токенов.

@ai_for_devs
  • 🔥 66
  • ⚡ 18
  • 👍 15
  • ❤ 6
  • 🤩 3
Post #360 9.59K
⚡️ Qwen Code перестал быть бесплатным

13 апреля, ребята из Alibaba сначала срезали квоту с 1 000 до 100 бесплатных запросов в день, а 15-го убрали совсем.

Использовать Qwen Code теперь можно либо с подпиской на Alibaba Cloud Coding Plan (тарифы от $10 до 50$), либо со своим API-ключом, либо с локальными моделями.

Печально, на 1 бесплатный вариант стало меньше.

@ai_for_devs
  • 😢 68
  • 😁 13
  • 🤯 10
  • 🤬 9
  • ❤ 3
Post #359 8.57K
С большой силой приходит большая ответственность!

И 1 млн токенов контекста в Claude Code это реально большая сила. Для отличного результата важно понимать, как управлять таким большим контекстным окном.

Чем оно больше — тем сильнее context rot: модель распределяет внимание на всё больше токенов, и старый нерелевантный контент начинает мешать.

В каждый момент времени у нас есть пять вариантов, что с этим сделать:
• Продолжить — если контекст ещё актуален
• /rewind — откатиться к нужному сообщению и начать с него
• /compact — свернуть историю в краткое резюме и продолжить решать задачу дальше
• /clear — начать новую сессию с чистым контекстом
• Subagent — делегировать задачу агенту с отдельным контекстным окном

Кстати, про Rewind (двойной Esc) многие не знают, хотя это очень полезный и удобный инструмент. Когда Claude пошёл не туда — не нужно писать «это не сработало, попробуй X». Лучше откатиться к точке перед неудачной попыткой и переформулировать запрос. Неудачная ветка просто исчезает из контекста.


Подробный разбор каждого варианта и сравнительная таблица — в новой статье на Хабре.

@ai_for_devs
  • 👍 42
  • 🔥 13
  • ❤ 8
  • ⚡ 4
  • 👏 4
Post #358 7.18K
⚡️ Anthropic обновили десктопный интерфейс Claude

Теперь можно держать несколько сессий в одном окне — через боковую панель.

Рядом появились встроенный терминал, редактор файлов, превью HTML и PDF, ускоренный diff-вьюер.

Панели перетаскиваются мышью, можно собрать удобное расположение под себя.

Если сидите только в терминале, хороший повод попробовать десктоп.

@ai_for_devs
  • 🔥 44
  • 👍 22
  • ❤ 6
  • 🤩 5
  • 👏 3
Post #357 8.62K
Agent Harness — звучит круто, да?

И последнее время слышу это определение всё чаще. Но что оно вообще значит?

Коротко: это вся инфраструктура вокруг LLM — оркестрационный цикл, инструменты, память, управление контекстом, обработка ошибок. Всё, что не LLM.


Есть три уровня работы с харнесом (на картинке):
1. Prompt engineering — формирует инструкции, которые модель получает.
2. Context engineering — управляет тем, что модель видит и когда.
3. Harness engineering — включает оба предыдущих плюс всю прикладную инфраструктуру: оркестрацию инструментов, персистентность состояния, восстановление после ошибок, циклы верификации, обеспечение безопасности и управление жизненным циклом.

Не стоит умалять заслуги людей, которые обучают LLM — за последнее время они сделали огромный шаг вперёд. Но харнесс тоже имеет вес. Например, LangChain поменяли только его, не трогая модель и веса — и поднялись с 30-го на 5-е место в TerminalBench 2.0.

Подробнее про то, как устроены Claude Code, OpenAI, LangChain и где во всём этом харнесс — в новой статье на Хабре.

Рекомендую сохранить, если хотите лучше понимать, как работает ваш агент и как его можно улучшить.

@ai_for_devs
  • 👍 37
  • 🔥 17
  • ❤ 8
  • 👏 6
  • 💯 1
Post #356 9.09K
  • 👍 27
  • 🔥 18
  • 👏 7
  • ❤ 6
Post #355 9.46K
😎 Вебинар "AI-инструменты для разработчиков 2026" уже сегодня!

Если ты всё еще не зарегистрировался, то сейчас самое время. Трансляция начнется через час, в 14:30 мск.

Напомню, что эксперты из Veai будут разбирать, как выглядит рынок AI-инструментов сейчас, чем отличаются CLI-агенты от решений в IDE, какие риски реально важны для компании и как выбирать модели под конкретные задачи.

Спикер: Михаил Костицын (Lead Developer).

Вебинар бесплатный, главное зарегистрироваться: https://veai.ru/events/ai-assistants-2026/join
  • 👍 19
  • 🔥 12
  • ⚡ 8
  • 😁 4
  • ❤ 2
Post #354 9.65K
В 2019 году OpenAI выпустили GPT-2 и сразу объявили: полную версию не публикуем — слишком опасно!!

Заголовки тогда были соответствующие:

AI So Powerful That It Must Be Kept Locked Up for the Good of Humanity


Потом модель всё равно выпустили, сославшись на то, что никаких серьёзных злоупотреблений замечено не было 😄

Исследователи уже тогда говорили, что удержание модели от публикации это в лучшем случае временная мера. Как говорится, шила в мешке не утаишь! История с GPT-2 в итоге была скорее маркетинговым жестом (ну сейчас это очевидно), чтобы начать разговор об этике в AI, а не реальной попыткой что-то защитить.

Интересно, будет ли также весело читать про Mythos ещё спустя 7 лет)

@ai_for_devs
Slate Magazine When Is Technology Too Dangerous to Release to the Public? If recent history is any indication, trying to suppress or control the proliferation of A.I. tools may be a losing battle.
  • 😁 37
  • 👍 12
  • ❤ 7
  • 💯 2
  • 👏 1
Post #349 11.8K
🚨 Anthropic показали Claude Mythos Preview — и сразу заявили: в паблик модель выпускать не будут

Причина простая — кибербезопасность. За несколько недель модель нашла тысячи zero-day, включая уязвимости в Linux kernel, OpenBSD и FFmpeg.

Часть багов существовала 10–25 лет и проходила через миллионы тестов.

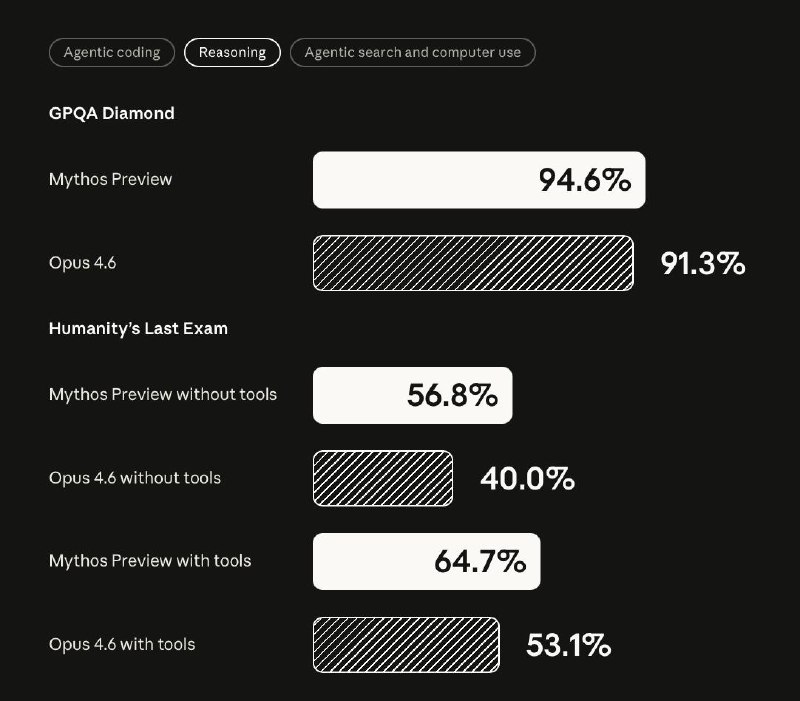
По бенчмаркам разрыв с Opus 4.6 просто космический:
— SWE-bench Verified: 93.9% vs 80.8%
— CyberGym: 83.1% vs 66.6%
— Terminal-Bench 2.0: 82.0% vs 65.4%

Модель не просто находит баги, но и умеет строить эксплойты и цепочки атак почти без участия человека.

Anthropic запустили Project Glasswing — закрытую программу с AWS, Google, Microsoft, NVIDIA, Cisco и другими. Им дают доступ к модели, чтобы искать и закрывать уязвимости в критической инфраструктуре и open-source. Под это выделили до $100 млн в кредитах + отдельные гранты в open-source фонды.


И когда релиз? Сейчас говорят, что напрямую релиз не планируется. Сначала хотят довести до ума защитные механизмы и только потом постепенно переносить возможности этой модели в более безопасные версии моделей (следующий Opus).

@ai_for_devs
  • 🤯 70
  • 🔥 22
  • 👍 18
  • ❤ 12
  • 😁 9
Post #348 8.44K
⚡ Z.ai выпустили GLM-5.1 — новый opensource флагман для агентных задач

Топ-3 глобально и первое место среди open-source на SWE-Bench Pro, Terminal-Bench 2.0 и NL2Repo. Модель проектировали под долгоиграющие задачи.

Один из сценариев, на котором проверяли модель — сборка Linux-десктопа в браузере.

За 8 часов GLM-5.1 собрала браузерный Linux-десктоп с нуля: файловый менеджер, терминал, текстовый редактор, системный монитор. После каждого шага модель сама смотрела на результат и решала, что доделать дальше.

Веса доступны на HuggingFace под MIT лицензией.

@ai_for_devs
  • 🔥 38
  • 👍 16
  • ⚡ 7
  • 🤩 2
  • ❤ 1
Post #347 8.05K
Opus 4.5 набирает 80.6% на SWE-bench Verified. Opus 4 — 72.5%. Значит ли это, что Opus 4.5 лучше программирует, чем Opus 4?

Ну... возможно.

Но SWE-bench Verified это не показывает. Он показывает способность модели чинить небольшие баги в 12 популярных open source Python-репозиториях, которые почти наверняка входят в её обучающие данные.

SWE-bench Verified не тестирует умение ориентироваться в вашем TypeScript-монорепо, Spring Boot-приложении или самописном ORM, на котором настоял предыдущий CTO.

А вы знаете, как устроены самые популярные бенчмарки? Если хочется чуть больше понимать, что происходит за цифрами в каждом новом релизе флагманской модели — добро пожаловать в лонгрид на Хабре.

Разбираем 14 самых популярных бенчмарков на конкретных примерах: что тестирует каждый и как устроена оценка.

@ai_for_devs
  • 👍 36
  • ❤ 8
  • 🔥 8
  • 👏 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →