


Та самая SSA-модель с контекстом до 12M токенов, про которую мы писали раньше. Бенчмарки теперь проверила сторонняя организация Appen.
Small в названии, по всей видимости, отражает размер модели в линейке. Сколько именно у неё параметров, компания не говорит. Дальше обещают модели покрупнее, также с контекстом до 12M токенов.
На тесте, где нужно связывать факты из разных частей текста, точность выросла с 95% до 99%.
Обычные модели сверяют каждое слово с каждым, поэтому вычислений с ростом текста становится непропорционально больше. SubQ выбирает только значимые связи и реально использует 0.13% всех пар слов, отсюда экономия на длинных задачах.
На контексте 1M токенов: вычислений в 64 раза меньше, чем у обычных моделей, ответ получают в 56 раз быстрее.
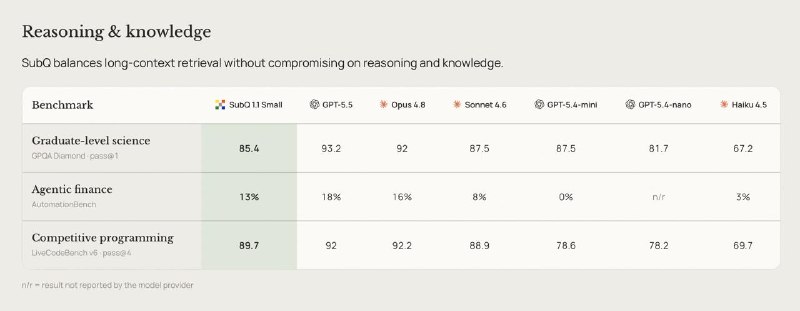
Общие способности не упали: GPQA Diamond — 85.4%, LiveCodeBench — 89.7%, почти на уровне лучших моделей.
Пока модель доступна избранным партнёрам, широкий публичный релиз обещают к концу года. Ждём!
@ai_for_devs