TGViewer
AI for Devs AI for Devs @ai_for_devs · 17.1K subscribers
Post #417 10.7K
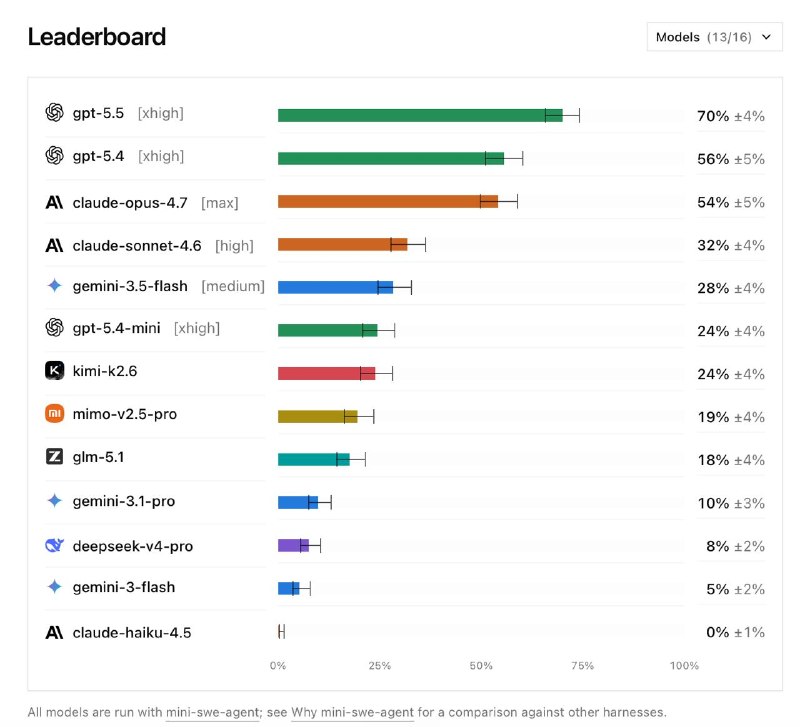
GPT уверенно уделывает Opus по очкам, стоимости и времени выполнения!

Datacurve (молодая команда из YC W24, которая делает дорогие и сложные coding-датасеты) выпустила DeepSWE: новый бенчмарк для coding-агентов.

Создатели утверждают: SWE-Bench и подобные уже не отражают реальности. Модели их заучили, задачи слишком мелкие, а оценка полна погрешностей.

Что внутри DeepSWE:
– 113 полностью новых задач из 91 активного open-source репозитория.
– Пять языков: TypeScript, Go, Python, JavaScript и Rust.
– Среднее решение составляет 668 строк кода в 7 файлах (против ~120 строк и 5 файлов в SWE-Bench Pro).
– Короткие естественные промпты.
– Verifier проверяет реальное поведение, а не структуру авторского решения.


Все модели тестировали на одном и том же mini-swe-agent (минималистичный harness на ~100 строк кода).

Результаты можете лицезреть на картинках. Разрыв между топами получился гораздо шире, чем на старых бенчмарках.

@ai_for_devs
  • 👍 51
  • 🤯 22
  • 🔥 14
  • ❤ 5
  • 💯 5
  • ⚡ 2
More from @ai_for_devs
  1. Sep 22, 2026⚡️ OpenAI выпустили GPT-6 Sol и Luna — более быстрые и дешёвые версии Astra Обе модели сто…
  2. Sep 22, 2026⚡️ Anthropic выпустили Claude Opus 5.5 По бенчмаркам новинка обошла всех основных конкурен…
  3. Sep 22, 2026⚡️ Xiaomi выпустили MiMo-V2.6 Pro и Flash В Pro больше триллиона параметров, во Flash 309…
  4. Sep 22, 2026⚡️ Z.ai опубликовали исходный код ZCode после скандала со сливом репозиториев Компания фак…
  5. Sep 21, 2026⚡️ SpaceXAI выпустили Grok 4.7 На CursorBench 4.0 модель набрала 46,3% против 41,7% у GPT-…
  6. Sep 21, 2026⚡️ Модель Jev от TypeSafe AI стала доступна всем На старте дают $5 на API-счет (~120млн.то…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →